Build And Understand a Vector Database From Scratch in 10 Easy Steps
Machine Learning Mastery3609 字 (约 15 分钟)
85
本文通过10个步骤用Python和NumPy从零构建向量数据库,详解向量编码、相似性搜索和近似索引原理。
入选理由:使用sentence-transformers库将文档编码为固定长度向量
FeaturedArticle#向量数据库#Python#NumPy#机器学习英文
产品
也叫:sentence-transformers
用于生成文档向量的Python库
最近变化
2026-09-18 · 使用sentence-transformers库将文档编码为固定长度向量
sentence-transformers 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
Build And Understand a Vector Database From Scratch in 10 Easy Steps
Machine Learning Mastery · 8.5 分
Combining LLM Embeddings with Tabular Features in a Unified Scikit-learn Pipeline
Machine Learning Mastery · 8.5 分
Training and Finetuning Multi-Vector Embedding Models with Sentence Transformers
Hugging Face Blog · 8.5 分
已收录 8 篇与「sentence-transformers」相关的 AI 资讯和分析。
本文通过10个步骤用Python和NumPy从零构建向量数据库,详解向量编码、相似性搜索和近似索引原理。
入选理由:使用sentence-transformers库将文档编码为固定长度向量
Sentence Transformers v6.0新增MultiVectorEncoder模型,通过微调可超越通用检索模型。
入选理由:MultiVectorEncoder模型使用MaxSim算子实现token级匹配,提升检索精度
本文展示如何将LLM生成的文本嵌入与表格特征整合到scikit-learn管道中,使用ColumnTransformer处理多类型数据并构建分类模型。
入选理由:使用Hugging Face的sentence-transformers库生成文本嵌入并向量化
Sentence Transformers v6.0新增MultiVectorEncoder模型,支持ColBERT风格的晚期交互检索,提升视觉文档检索效果。
入选理由:MultiVector模型保留每个token的向量,避免信息压缩损失。
使用LLM嵌入和HDBSCAN聚类非结构化文本,可自动发现隐藏主题。
入选理由:使用Sentence Transformers生成文本嵌入,可将非结构化文本转化为语义丰富的数学表示。
从TF-IDF到Transformer,文章通过四个阶段展示了语义搜索的演变过程,揭示了现代系统如何从手动设计特征转向直接从数据学习抽象意义。
入选理由:TF-IDF结合手工特征提供了透明的排名系统。
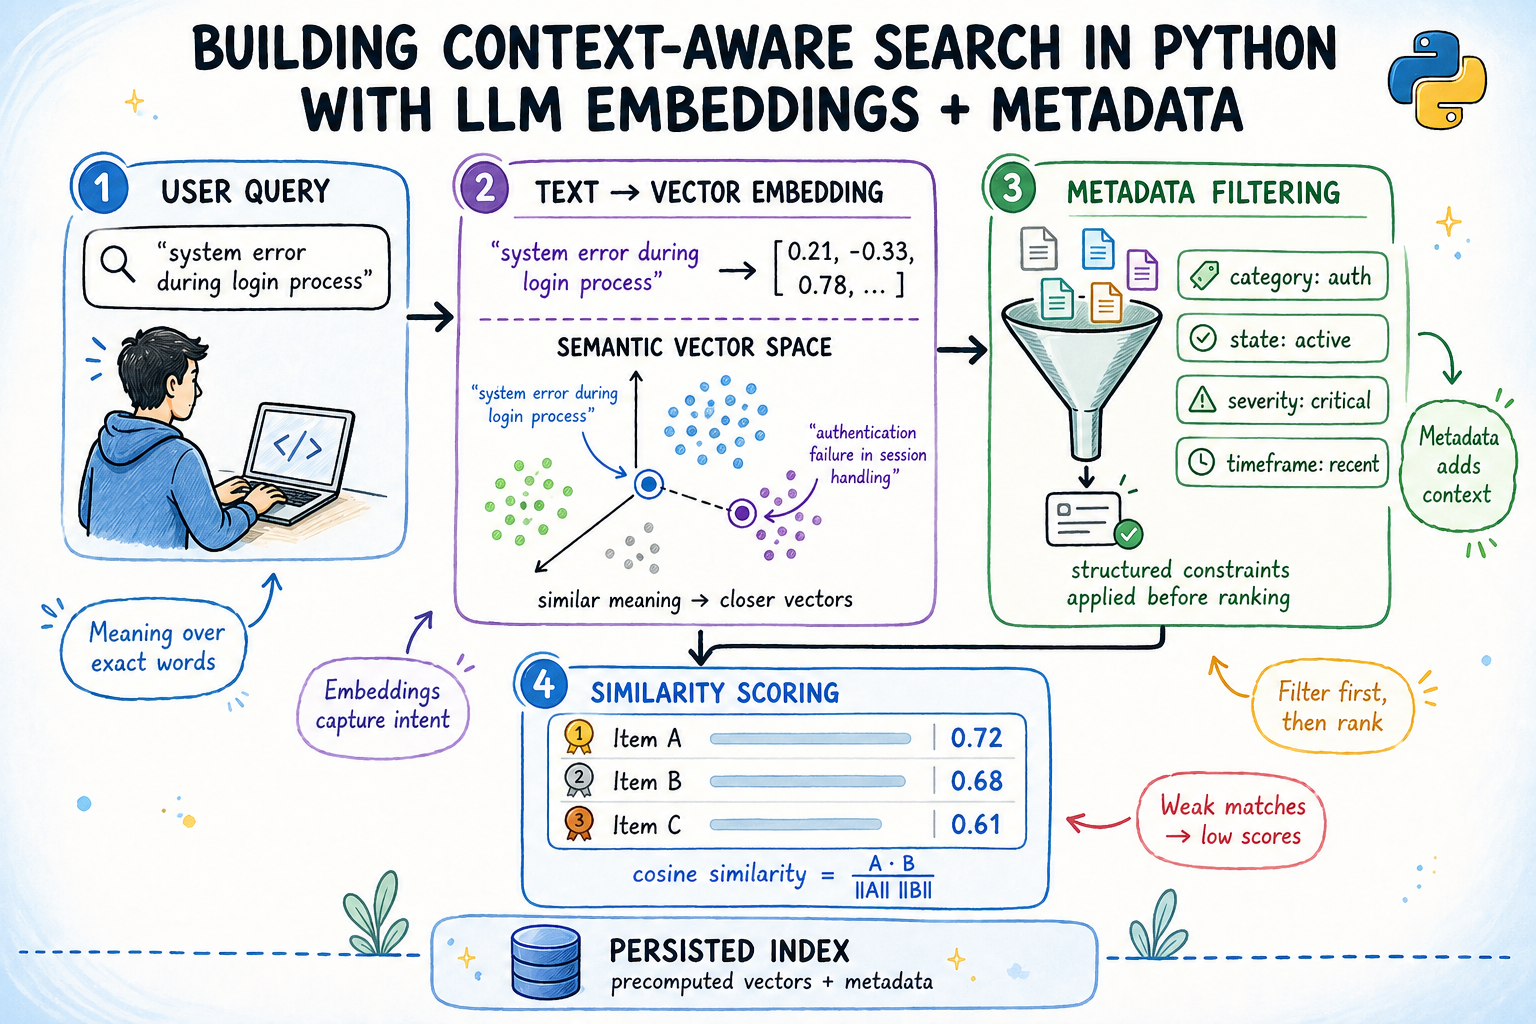
This article explains how to build a context-aware semantic search engine in Python using LLM embeddings combined with metadata filtering.
入选理由:使用本地预训练模型生成384维向量,无需API密钥即可实现语义搜索。
Hugging Face releases the Ettin Reranker Family, six CrossEncoder models ranging from 17M to 1B parameters built on ModernBERT encoders, using distillation training to achieve state-of-the-art performance on MTEB retrieval benchmarks for RAG systems.
入选理由:发布6个CrossEncoder reranker模型(17M/32M/68M/150M/400M/1B参数),基于Ettin ModernBERT架构
与「sentence-transformers」经常一起出现的 AI 术语。
💡 想追踪「sentence-transformers」的长期趋势?去 实体雷达 · sentence-transformers 查看详细分析和跨材料问答。