多向量检索策略选型:分离度决定nDCG@10成败
多向量检索中近似策略选择错误会导致nDCG@10下降6倍,影响远超模型升级收益。应通过计算Token向量MaxSim标准差判断嵌入空间分离度:高分散选TokenANN/MUVERA,低分散选LEMUR,避免盲目调优。
入选理由:同模型数据集下,错误近似策略使nDCG@10从0.701跌至0.109,损失超模型升级收益
traeai 专题雷达
追踪 Qdrant、Milvus、pgvector、Embedding、稀疏检索、重排与语义搜索系统设计。
想理解向量数据库怎么选型、怎么做语义搜索,以及 RAG 检索链路如何优化。
很多 AI 应用的效果瓶颈不在模型,而在检索和上下文组织。
这个专题可以沿着工具、实践、对比等搜索意图持续扩展,不靠空壳换词,而是用真实材料更新。
持续抓取与 向量检索 相关的高分文章、播客、视频和推文。
把最近变化、反复出现的观点和争议点整理成稳定摘要。
自动连接相关公司、模型、产品、人物和概念,形成可继续深挖的入口。
按相关度、评分和更新时间筛出的可读内容。
多向量检索中近似策略选择错误会导致nDCG@10下降6倍,影响远超模型升级收益。应通过计算Token向量MaxSim标准差判断嵌入空间分离度:高分散选TokenANN/MUVERA,低分散选LEMUR,避免盲目调优。
入选理由:同模型数据集下,错误近似策略使nDCG@10从0.701跌至0.109,损失超模型升级收益
Meta智能眼镜配套应用Stella v273内置了完整但休眠的端侧人脸识别管线,包含三个模型、本地向量数据库及通知组件,虽未对普通用户激活,但技术栈已完全就绪且可复现。
入选理由:Stella v273集成SCRFD、KPSAligner和SFace三模型,总大小约100MB,支持端侧生成2048维人脸嵌入。
Senqi AI 使用 Milvus 向物理机器人注入长期语义记忆能力,解决真实世界任务中环境动态、任务无界、指令模糊和错误高成本等核心挑战。
入选理由:物理机器人Agent需实时重规划,因环境持续变化且任务无明确终点
Context defocus严重影响Claude Code代理,7个开源工具可有效解决此问题,减少60-90%的token消耗。
入选理由:使用RTK压缩终端输出可减少60-90%的token消耗。
当前车载媒体系统仍依赖关键词搜索,而驾驶时用户更倾向于用情绪、氛围和意图表达需求;Sarvesh Talele 使用 Qdrant Edge 构建了完全本地化的 AI 驱动媒体发现系统,支持语音/文本/情绪三类语义查询,全程无需云端依赖,实现隐私优先的实时体验。
入选理由:系统采用 Whisper 实现本地语音转录,Qdrant Edge 提供设备端向量检索,全程无云服务依赖
RAG系统中嵌入向量并非魔法,其失败模式高度可预测:当查询与文档使用不同术语(如“overtime” vs “non-employee labor”)、含否定词、或依赖精确编号/代码时,检索会失效;文章强调企业级可靠性应优先依赖上游过滤(如专家关键词、结构化元数据),而非堆叠重排序器。
入选理由:嵌入模型在处理同义词/拼写变体时表现优异(如‘cancel’→‘termination procedures’),但对术语不一致问题无能为力
文章指出,尽管重排器常被视为RAG系统的‘魔法层’,但在实际应用中仍存在否定、逻辑补集等根本性问题,且引入高延迟;实验表明,在部分场景下,仅用嵌入模型(如text-embedding-3-large)直接检索的效果甚至优于‘嵌入+reranker’组合。
入选理由:bge-reranker-base等交叉编码器无法解决否定句、逻辑补集等语义难题,与基础嵌入模型表现差距有限
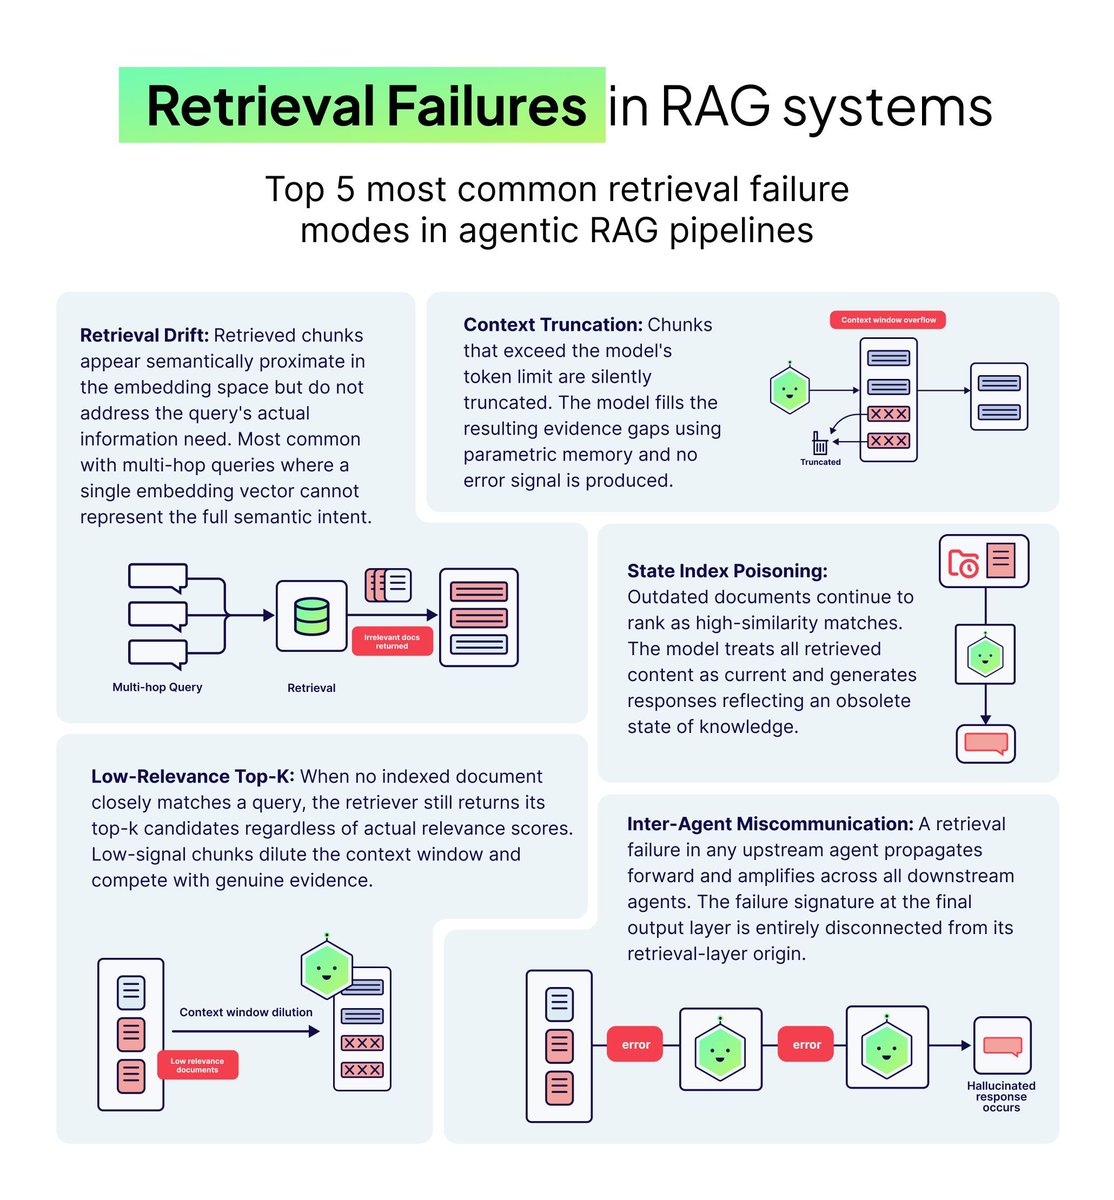
研究发现,RAG系统中检索质量差是导致高流畅性幻觉(更自信但更错误)的主因,模型升级无法弥补检索缺陷。
入选理由:检索质量差是RAG输出退化的最主要预测指标,模型能力增强反而加剧幻觉可信度。
Milvus 提出通过 compaction(段合并与物理删除)和 TTL(自动过期)两项内置机制,可显著降低向量数据库存储成本,尤其适用于会话数据、时效性 RAG 等有生命周期的数据场景。
入选理由:向量数据库中逻辑删除不释放磁盘空间,导致存储膨胀达2–5倍
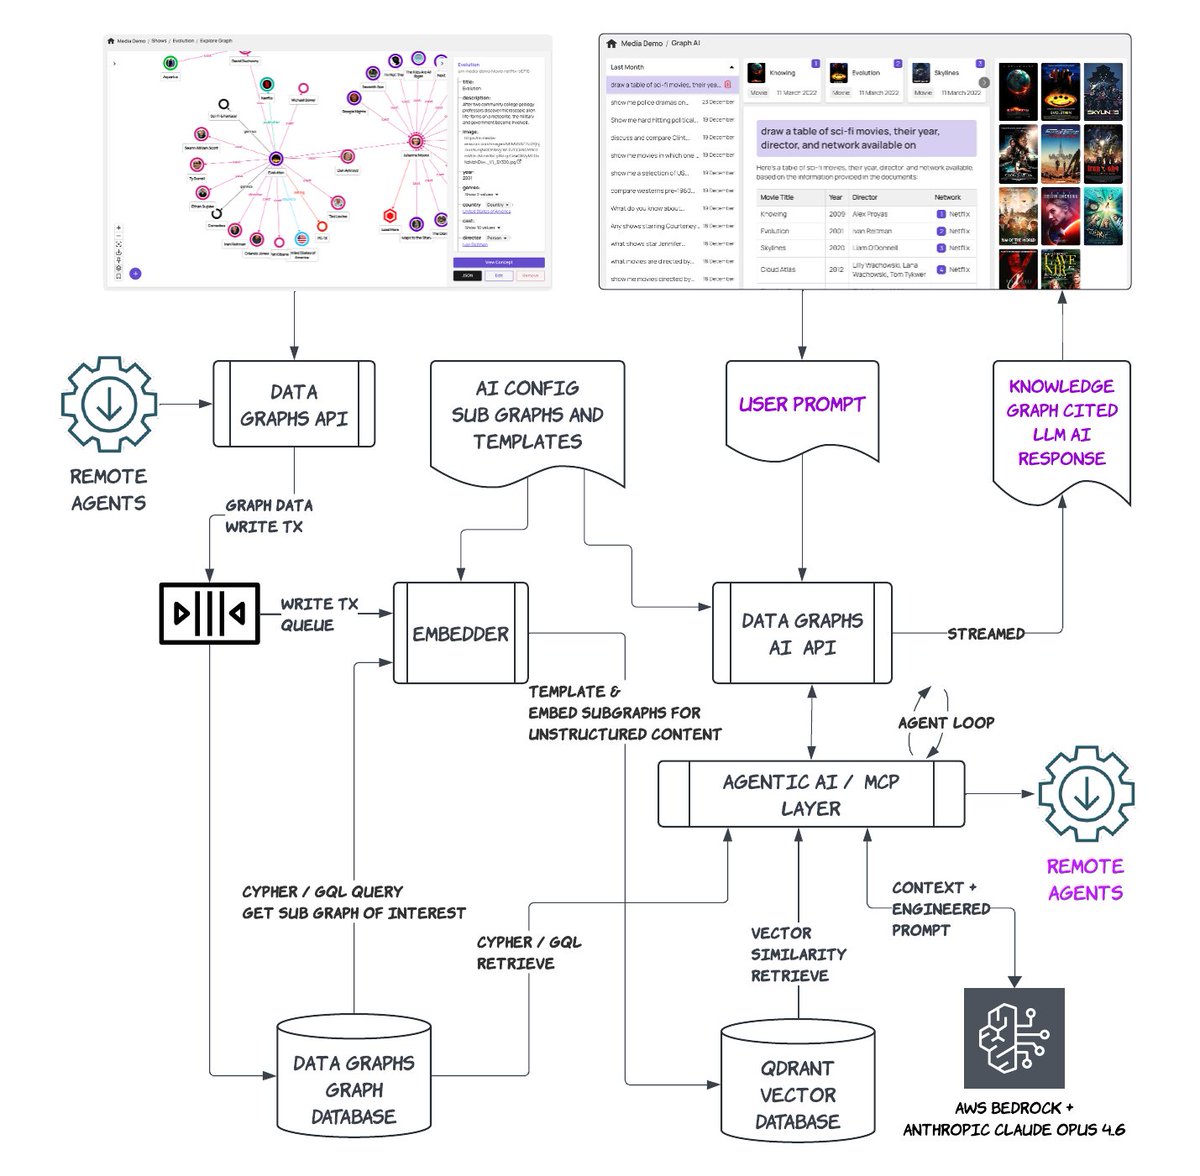
Qdrant 指出多数“图RAG”实为套壳向量检索,而 @datagraphs 构建了真正融合图数据库与向量搜索的协同架构:通过 schema-first agent 调度并行图查与语义检索,实现可验证、低延迟、全栈可控的知识问答。
入选理由:图与向量非互斥,而是互补:图擅精确逻辑查询(否定/时间/计算),向量擅语义相似匹配
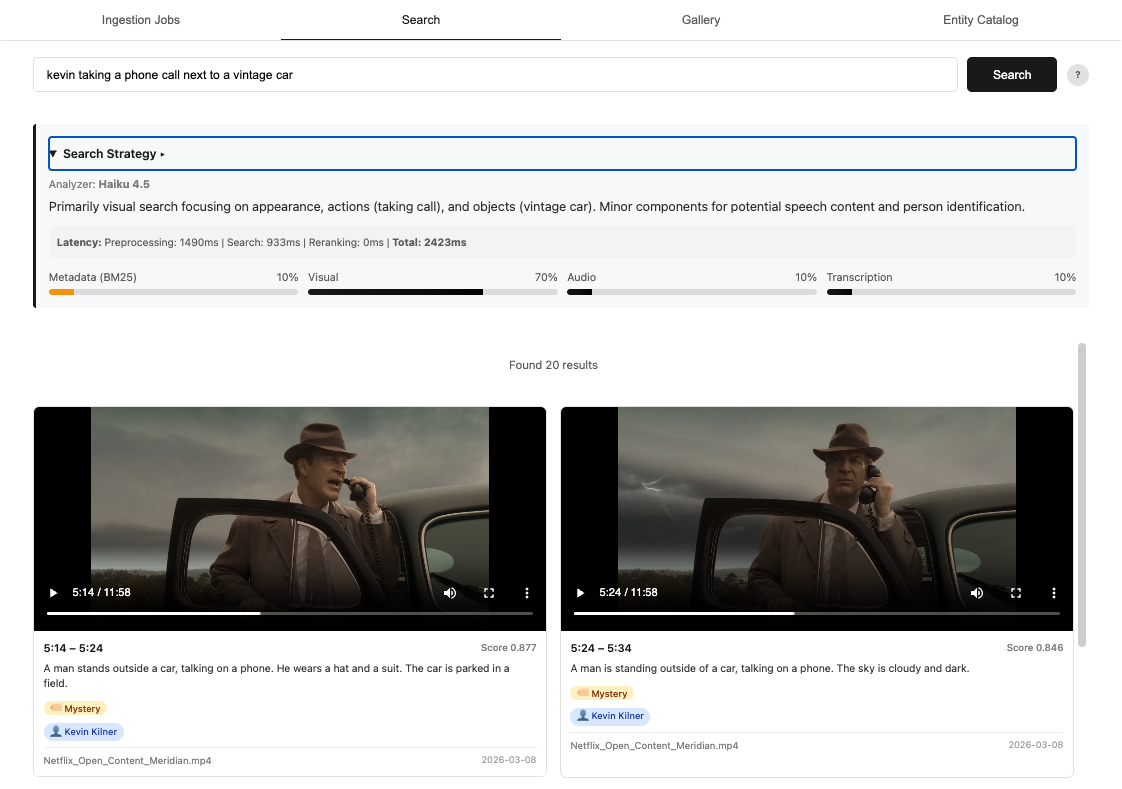
AWS 推出基于 Amazon Nova 多模态嵌入的视频语义搜索方案,可联合处理音视频、文本等多源信号,提升检索准确性与效率。
入选理由:传统视频搜索依赖文本转录,易丢失时空和音频信息
文章系统解析现代稀疏神经检索模型(如SPLADE++),对比关键词与稠密检索优劣,并展示其在Qdrant中的实践应用。
入选理由:稀疏神经检索结合BM25的可解释性与语义理解能力,优于传统关键词匹配
文章详解如何使用 Sentence Transformers 微调多模态嵌入与重排序模型,并以视觉文档检索任务为例展示显著性能提升。
入选理由:微调多模态嵌入模型可显著提升特定任务(如视觉文档检索)的检索效果
Perplexity推出新上下文嵌入模型pplx-embed-v2-context-9b-preview,在ConTEB和context-bench基准测试中取得新SOTA。
入选理由:pplx-embed-v2-context-9b-preview在ConTEB基准测试中达到新SOTA
混合搜索结合BM25、SPLADE和dense embeddings在金融文档检索中展现优势,Qdrant通过47份SEC文件验证了不同方法的适用场景。
入选理由:BM25在精确关键词匹配上优于dense embeddings(SPLADE)
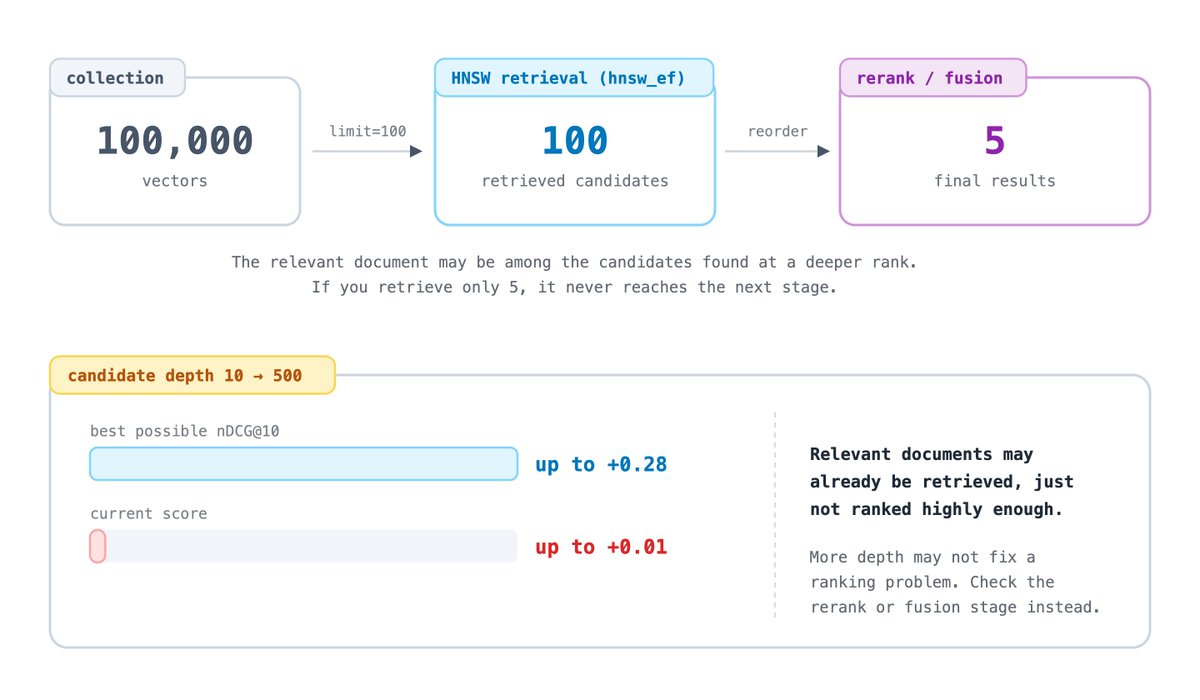
向量搜索中检索更多候选(如100个)可提升重排序效果,但增加至500个时收益有限(nDCG@10提升0.28,实际评分变化<0.01)。
入选理由:检索100个候选比10个更有利于重排序阶段优化结果
Milvus向量数据库支撑全球最大音乐平台实现百亿级音轨检索,10ms级P99延迟,覆盖歌曲识别、版权匹配等场景。
入选理由:Milvus处理超百亿向量数据,支持每秒数百次搜索请求
EverOS结合Milvus实现AI代理长期记忆,支持BM25和向量搜索,适合需要跨对话记忆管理的项目。
入选理由:EverOS通过LLM提取对话记忆并保存为Markdown文件,支持人工审查
Jev在重排序任务中表现优于qwen3.7-text-rerank,但延迟和成本显著更高,适合离线场景而非实时RAG。
入选理由:Jev的nDCG@10提升0.0778,但延迟是qwen的10.2倍
向量索引选择需权衡性能与内存效率,HNSW适合高吞吐场景,HFresh通过压缩技术优化内存使用。
入选理由:HNSW在低延迟和高查询吞吐场景表现最优
将AI记忆视为不断增长的聊天历史会导致性能下降,Weaviate的Engram通过异步处理优化记忆管理。
入选理由:Engram通过异步处理提取、对比、解决矛盾的四步流程优化记忆管理
Weaviate 1.39 引入 4 位旋转量化,减少内存使用并提升性能,同时保持高召回率。
入选理由:4 位旋转量化减少内存占用,同时保持强召回率。
使用Scikit-LLM和多语言嵌入可构建无需单独训练每种语言模型的多语言文本分类流水线。
入选理由:BGE-M3模型支持多语言嵌入生成,可替代付费API实现本地化部署
本文通过10个步骤用Python和NumPy从零构建向量数据库,详解向量编码、相似性搜索和近似索引原理。
入选理由:使用sentence-transformers库将文档编码为固定长度向量
双曲嵌入在处理层次结构数据时比传统欧几里得嵌入更高效,且在WordNet案例中表现优异。
入选理由:双曲嵌入在WordNet案例中,5维精度0.823远超200维欧几里得嵌入的0.168
AI代理通过语义搜索整合Git/Slack/Jira等数据源,结合OpenTelemetry监控实现安全可控的内部开发者平台。
入选理由:AI代理整合Git、Slack、Jira等12类数据源实现上下文感知
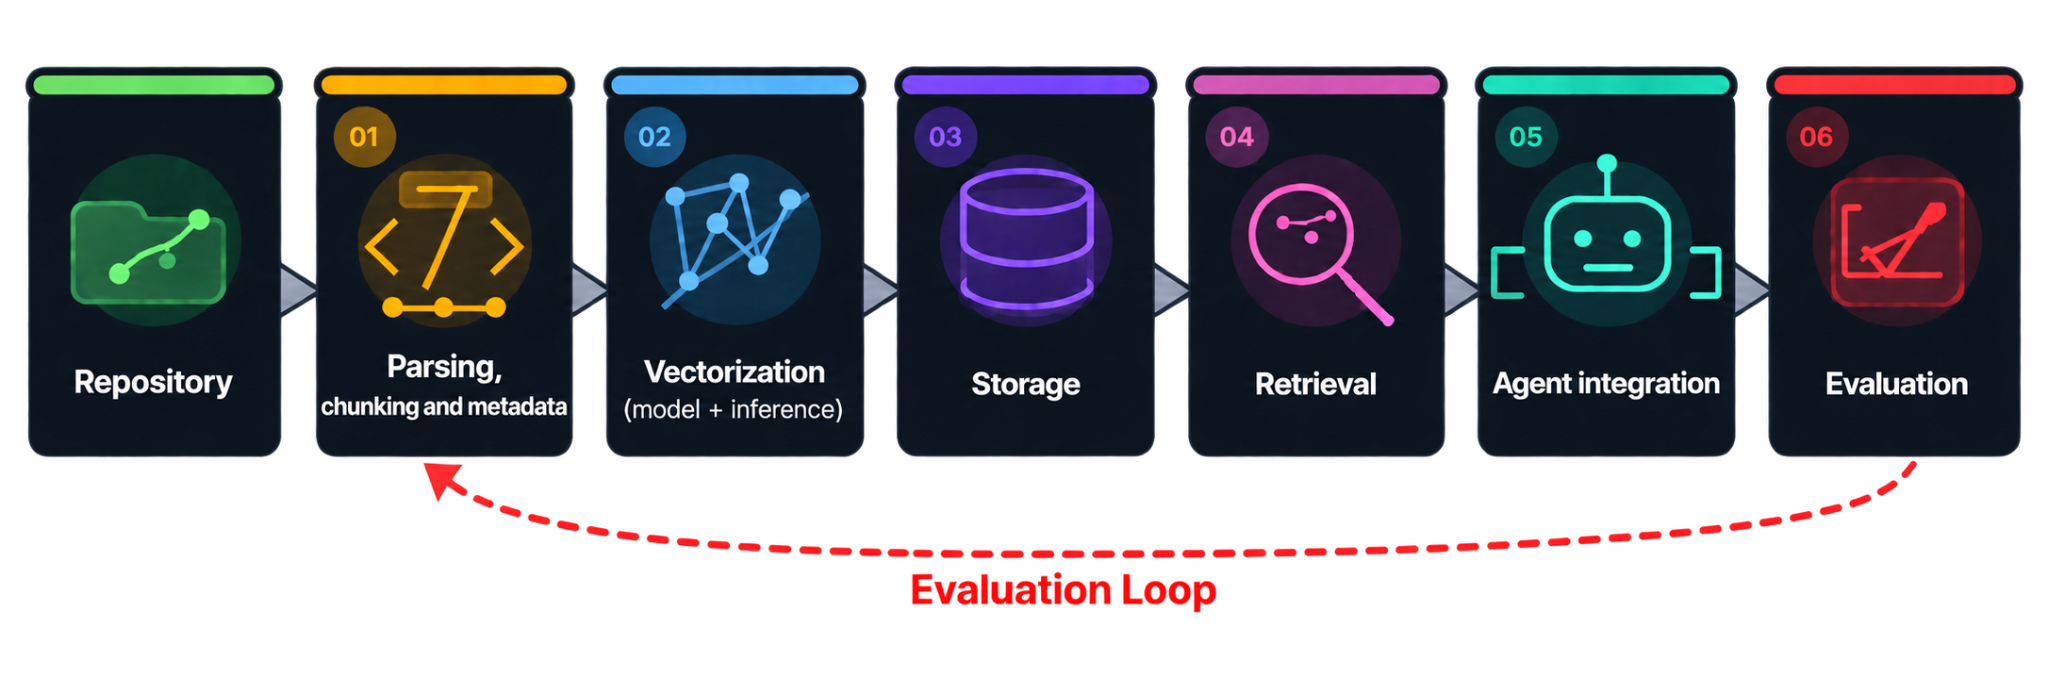
JetBrains分享了构建RAG管道进行语义代码搜索的实践经验,涵盖解析、分块、向量化等关键步骤,揭示生产环境中的技术挑战与优化策略。
入选理由:代码解析与分块是RAG管道的基础,需处理多语言语法差异