从高拟真到真可用,LongCat-Video-Avatar 1.5 正式开源
美团技术团队2226 字 (约 9 分钟)
92
LongCat-Video-Avatar 1.5 开源版本在唇形同步、物理合理性、长视频稳定性等方面实现显著提升,支持复杂商业场景下的高质量数字人视频生成。
入选理由:采用 Whisper-large 编码器,提升唇形同步与动作稳定性。
精选文章#数字人#视频生成#AI模型#开源项目#美团中文
traeai 专题雷达
关注 HeyGen、HyperFrames、网页转视频、数字人、视频生成模型与内容生产工作流。
想了解网页、文章和产品内容如何自动生成视频,以及 AI 视频工具的最新能力。
内容分发正在从图文扩展到视频,Website-to-Video 是 traeai 知识库的重要增长方向。
这个专题可以沿着工具、实践、对比等搜索意图持续扩展,不靠空壳换词,而是用真实材料更新。
持续抓取与 AI 视频 相关的高分文章、播客、视频和推文。
把最近变化、反复出现的观点和争议点整理成稳定摘要。
自动连接相关公司、模型、产品、人物和概念,形成可继续深挖的入口。
按相关度、评分和更新时间筛出的可读内容。
LongCat-Video-Avatar 1.5 开源版本在唇形同步、物理合理性、长视频稳定性等方面实现显著提升,支持复杂商业场景下的高质量数字人视频生成。
入选理由:采用 Whisper-large 编码器,提升唇形同步与动作稳定性。
前Nvidia研究员解析xAI如何三个月打造Grok Imagine,揭示视频生成模型的训练链路、世界模型定义及Video Agent未来趋势。
入选理由:xAI在三个月内从零构建出Grok Imagine 0.9,关键在于人才密度、高效infra和低沟通成本。
字节跳动开源统一视频生成与编辑框架Bernini,通过多模态大模型(MLLM)先理解语义指令并规划,再由DiT扩散模型执行高质量渲染,实现从“听指令”到“先理解再动手”的AI视频创作范式升级,支持天气、风格、动作、视角等可控编辑及参考图/视频生成。
入选理由:Bernini采用MLLM-based planner + DiT-based renderer双阶段架构,实现语义理解与视觉生成的解耦。
Google 推出 Gemini Omni 视频生成模型,实测在文本连贯性与物理逻辑还原上超越 Seedance 2.0,支持视频编辑与内容重混,虽短暂泄露后消失,但已引发行业震动。
入选理由:Gemini Omni 在数学板书视频中实现文本完全一致,解决 AI 视频长期存在的文字渲染缺陷。
HyperFrames 支持通过 `npx hyperframes add <name>` 命令一键调用材质与着色器,助力 OpenClaw/Hermes 等 AI 代理高效生成视频内容。
入选理由:HyperFrames 支持 `npx hyperframes add <name>` 一键添加材质与着色器。
跨维智能DexWorldModel以机器人任务成功率为核心指标重构世界模型评价体系,通过四层协同架构解决表示、记忆、推理与数据瓶颈,推动具身智能从视频生成走向真机闭环执行。
入选理由:世界模型应以机器人任务成功率而非视觉质量为评价标准,避免指标错位导致落地失效。
Kling AI 4.0 通过 Runware API 上线,支持生成 30 秒 1080p 原生音频视频,价格从每秒 $0.133 起。
入选理由:Kling 4.0 支持生成最长 30 秒的 1080p 原生音频视频
LTX 2.5 是首个支持本地部署的 AI 视频生成模型,提供多镜头同步与自托管选项。
入选理由:LTX 2.5 支持标准版和蒸馏版两种模型部署方案
Kling AI 在 OpenArt 上线 4.0 版本,支持首中尾帧引导与最多 10 张参考图,提升视频生成与编辑能力。
入选理由:Kling 4.0 支持使用首、中、尾帧引导视频生成,提升创作控制精度。
NotebookLM的视频生成工作流包含上下文收集、用户意图解析等步骤,提供具体工具调用和JSON模板。
入选理由:上下文收集阶段优先使用已有笔记摘要,仅在信息不足时调用semantic_search工具
可灵Kling 4.0支持30秒一镜到底,提供高分辨率输出和多场景参考,提升视频创作效率。
入选理由:Kling 4.0支持30秒一镜到底,适用于动态场景创作
Kling 4.0上线,实测30秒一镜到底与全能参考表现,支持10-bit 4K HDR输出,但尚未上线。
入选理由:1080P 30秒约450平方,720P 20秒的Flash版本达120平方
AI工具实现全自动化音乐视频生成,通过代码直接渲染导出1080p视频,展示跨领域技术整合能力。
入选理由:Claude可分离音频轨道并精确同步229个歌词字词
Grok Imagine Video 1.5 Lite模型现已在AI Gateway上线,支持文本到视频生成,分辨率最高达1080p,时长1-15秒。
入选理由:Grok Imagine Video 1.5 Lite支持1920x1080分辨率,时长1-15秒
在单张RTX 5090上使用MiniMax H3生成实时视频,30秒视频仅需23.51秒,性能达1.28倍实时渲染。
入选理由:RTX 5090显存优化使视频生成效率提升1.28倍
Kling 4.0通过连续镜头、Omni Reference和动态摄像机技术实现500万次播放的短片《The Beat》,展示AI视频生成新突破。
入选理由:Kling 4.0支持30秒连续镜头生成,减少传统拍摄协调成本
Kling 4.0在视频生成领域实现视觉真实感和商业应用稳定性突破,支持4K HDR与精准唇形同步。
入选理由:Kling 4.0支持4K分辨率及10-bit HDR输出,提升视觉质量
Jev模型与HeyGen MCP结合,可在毫秒级筛选高价值leads并生成视频,成本降低至千分之一美分。
入选理由:Jev模型判断leads需0.001美分/次,耗时毫秒级
AWS与Reactor合作通过Neuron Kernel Interface优化Trainium芯片,解决实时视频生成中的动态形状和内存管理难题,实现跨模型通用技术。
入选理由:Neuron Kernel Interface优化Trainium芯片的动态形状处理和缓存管理,提升实时生成效率。
谷歌提出AI视频共导演框架,通过多智能体协作解决长视频生成中的语义漂移和级联故障问题,实现分钟级连贯视频生成。
入选理由:多智能体框架可减少80%的视觉漂移误差
HeyGen与Claude Cowork整合实现Slack消息自动转视频,三步生成带配音的更新内容,无需手动编写脚本。
入选理由:使用Claude Cowork可将Slack消息自动转化为视频,仅需3次交互完成生成
Vidu S2 实现了实时数字人互动与视频编辑,支持720p高清输出和动态参考图更新,显著提升直播与虚拟内容的交互性。
入选理由:Vidu S2 支持实时生成和编辑视频,分辨率可达720p。
HeyGen的视频代理工具通过自动化编辑流程,使用户能在6分钟内生成30秒的短视频,核心依赖脚本、虚拟形象和素材的精准配合。
入选理由:视频生成仅需6分钟设置,AI自动处理配音、字幕和剪辑
HeyGen推出专业语音克隆技术,仅需20分钟语音训练即可生成高度拟真的人声,填补虚拟人像领域最大技术缺口。
入选理由:20分钟语音训练即可生成专业级语音克隆模型
美团智播通过高保真数字人生成、自然动作驱动等技术,实现本地生活场景下数字人直播的规模化应用,月日均GTV同比增长82.12%。
入选理由:美团智播实现3分钟开播配置,月日均GTV同比增长82.12%
Google推出Gemini Omni 1.1 Flash,提供更精细的视频生成控制,支持场景扩展、帧指定和4K输出。
入选理由:场景扩展支持10秒上下文分析,提升叙事连贯性
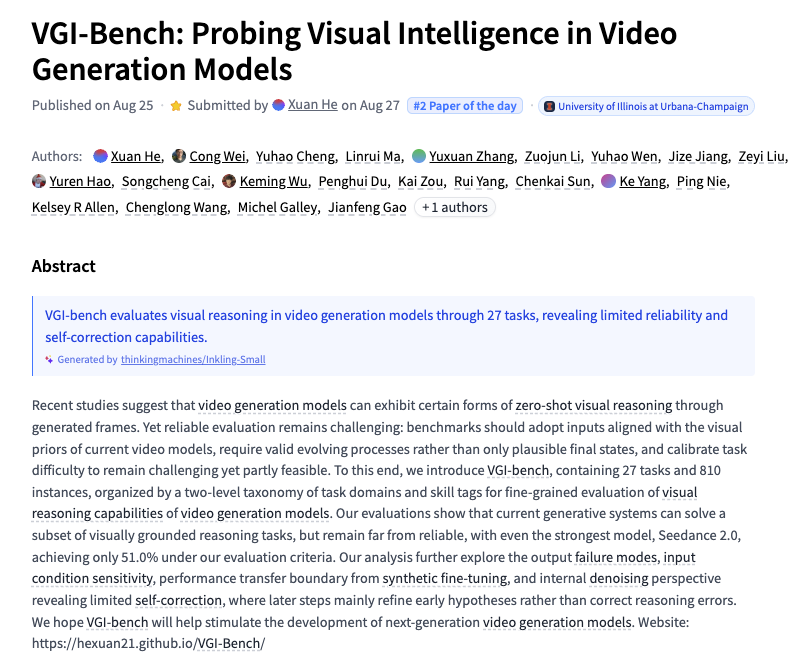
VGI-Bench 是首个系统评估视频生成模型视觉智能的基准测试,揭示当前模型在理解生成内容方面存在显著局限。
入选理由:VGI-Bench 包含 12 个任务,覆盖物体识别、动作理解等核心视觉能力评估
HeyGen推出两种视频图形制作方案,通过AI Studio和Video Agent实现脚本同步动态效果,品牌套件确保视觉统一性。
入选理由:使用AI Studio时需在提示词中明确场景时刻、色彩和文本位置
Gemini Omni 1.1 Flash模型新增视频生成控制功能,支持4K分辨率与场景扩展。
入选理由:开发者可指定视频首尾帧实现精准叙事控制
HeyGen与Google Cloud合作,将Avatar IV模型部署至Trillium TPU,优化后速度提升1.86倍,解决了内存限制和并行计算挑战。
入选理由:Avatar IV模型在Trillium TPU上运行速度提升1.86倍,通过FSDP权重分片和SparseCore协处理器优化。