#568. Transformer辩论:如何理解下一代智能之争
跨国串门儿计划2874 字 (约 12 分钟)
90
Transformer 架构虽仍主导当前 AI 发展,但其局限性促使 postTransformer 路径探索;未来智能可能来自混合架构与更高效推理机制,而非单一范式。
入选理由:Transformer 是目前最强的可扩展模型,但并非智能的终极答案
精选播客#Transformer#AI 架构#大语言模型#AGI#Post-Transformer中文
概念
也叫:Transformer模型
主流深度学习架构
最近变化
2026-10-16 · 线性层存储容量约64条记忆,MLP提升至2700条,自注意力可达百万级。
Transformer 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
已收录 30 篇与「Transformer」相关的 AI 资讯和分析。
Transformer 架构虽仍主导当前 AI 发展,但其局限性促使 postTransformer 路径探索;未来智能可能来自混合架构与更高效推理机制,而非单一范式。
入选理由:Transformer 是目前最强的可扩展模型,但并非智能的终极答案
Apple发布TIDE模型,通过分层上下文感知机制,显著提升长序列建模能力,推理延迟降低37%,内存占用减至45%。
入选理由:TIDE采用分层上下文感知机制,每层显式建模token与上下文关系。
GPT-1 提出通过无监督生成式预训练加任务微调的两阶段方法,显著提升自然语言理解能力,奠定大模型发展基础。
入选理由:GPT-1 采用无监督预训练与有监督微调结合的两阶段范式,提升多任务NLP性能。
从记忆角度解析Transformer结构,揭示线性层、MLP和自注意力机制的存储与回忆能力差异。
入选理由:线性层存储容量约64条记忆,MLP提升至2700条,自注意力可达百万级。
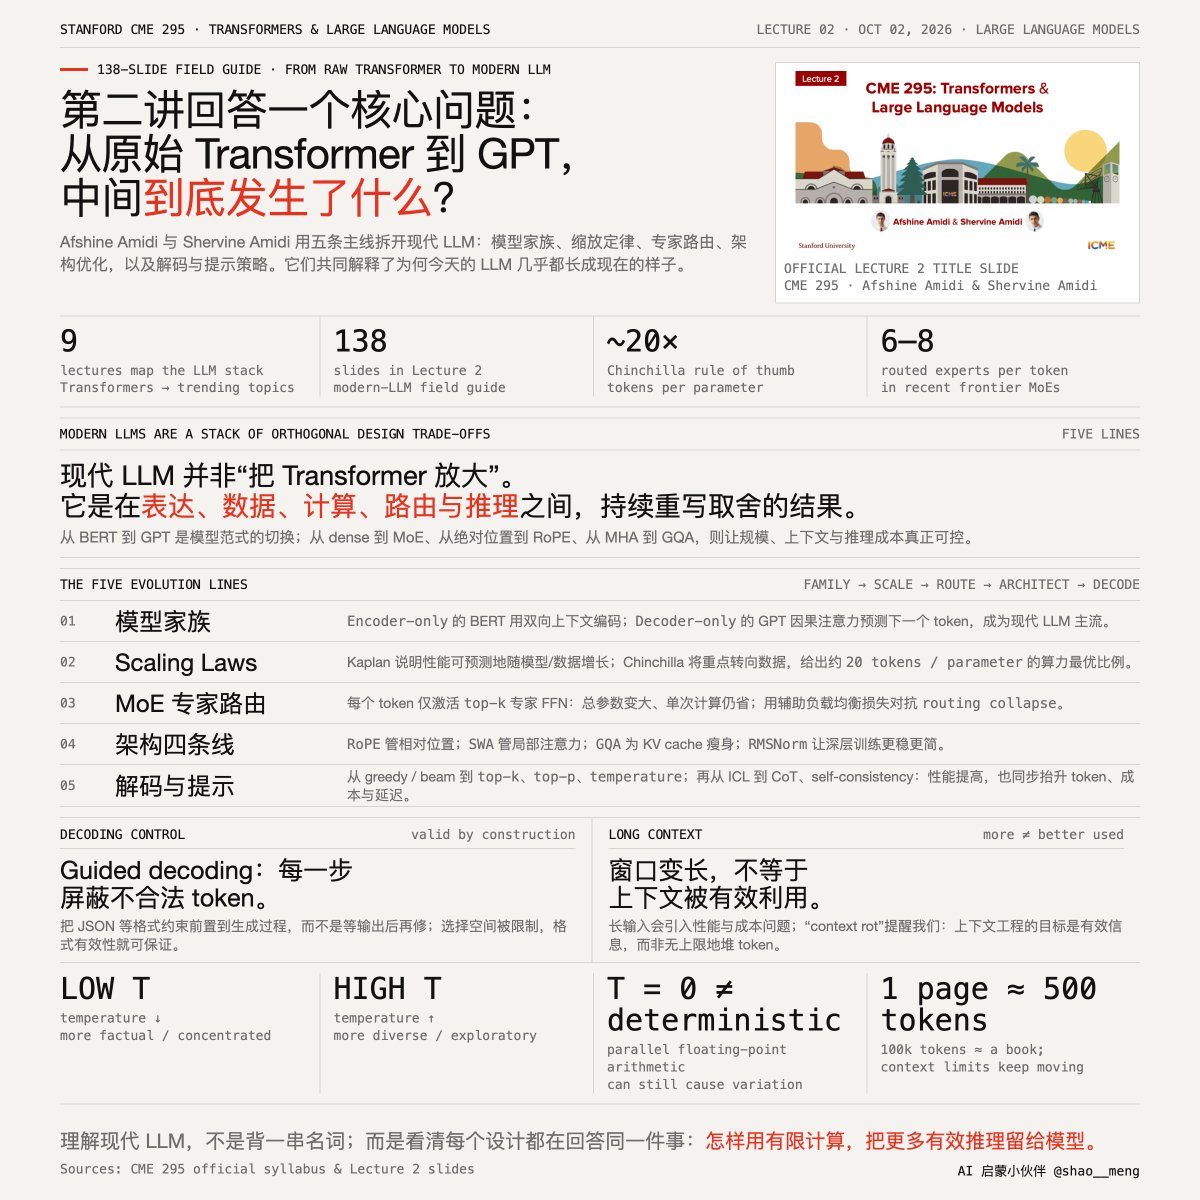
斯坦福LLM课程系统解析Transformer演进与大模型优化技术,覆盖从架构到训练的完整知识体系。
入选理由:现代LLM几乎全部采用Decoder-only架构(如GPT、Qwen)
NVIDIA Kumo Tabular模型在表格预测任务中实现高准确率与效率,无需训练和特征工程,四个基准测试排名第一。
入选理由:Kumo Tabular在TabArena/BeyondArena/TALENT/ScoringBench四大赛道均排名第一
扩散模型在推理时的并行处理优势使其成为未来LLM的潜在方向,相比Transformer的顺序生成更高效。
入选理由:Transformer推理需顺序生成,导致内存瓶颈,扩散模型可并行处理
Loop Transformers通过循环激活值实现双倍推理,但牺牲了监控性。Meta的CoCoNet论文提出该架构,使模型在潜在空间而非输出token上进行更多推理。
入选理由:Loop Transformers使模型在每次token生成时进行两次推理,提升潜在空间推理能力
AI芯片初创公司面临资本、供应链和技术三重挑战,行业竞争将长期激烈。
入选理由:AI芯片研发需至少3-5年才能突破供应链限制
微软研究员Lester Mai提出通过分布压缩优化Transformer注意力模块,降低计算成本并提升长序列处理效率。
入选理由:注意力模块计算成本随序列长度平方增长,成为性能瓶颈
开源可能无法完全防止AI权力集中,但未来技术突破可能改变现状。当前算力和数据需求导致大公司主导,但小型专用模型或成新趋势。
入选理由:Transformer架构的高算力需求加剧了AI权力集中,但未来可能转向小型专用模型
本文揭示了三种有效缩小语言模型规模而不显著影响性能的技术,包括参数量化、路径修剪和行为模仿,解决了大模型部署的硬件瓶颈问题。
入选理由:700亿参数模型需140GB显存,而消费级显卡仅支持24-48GB
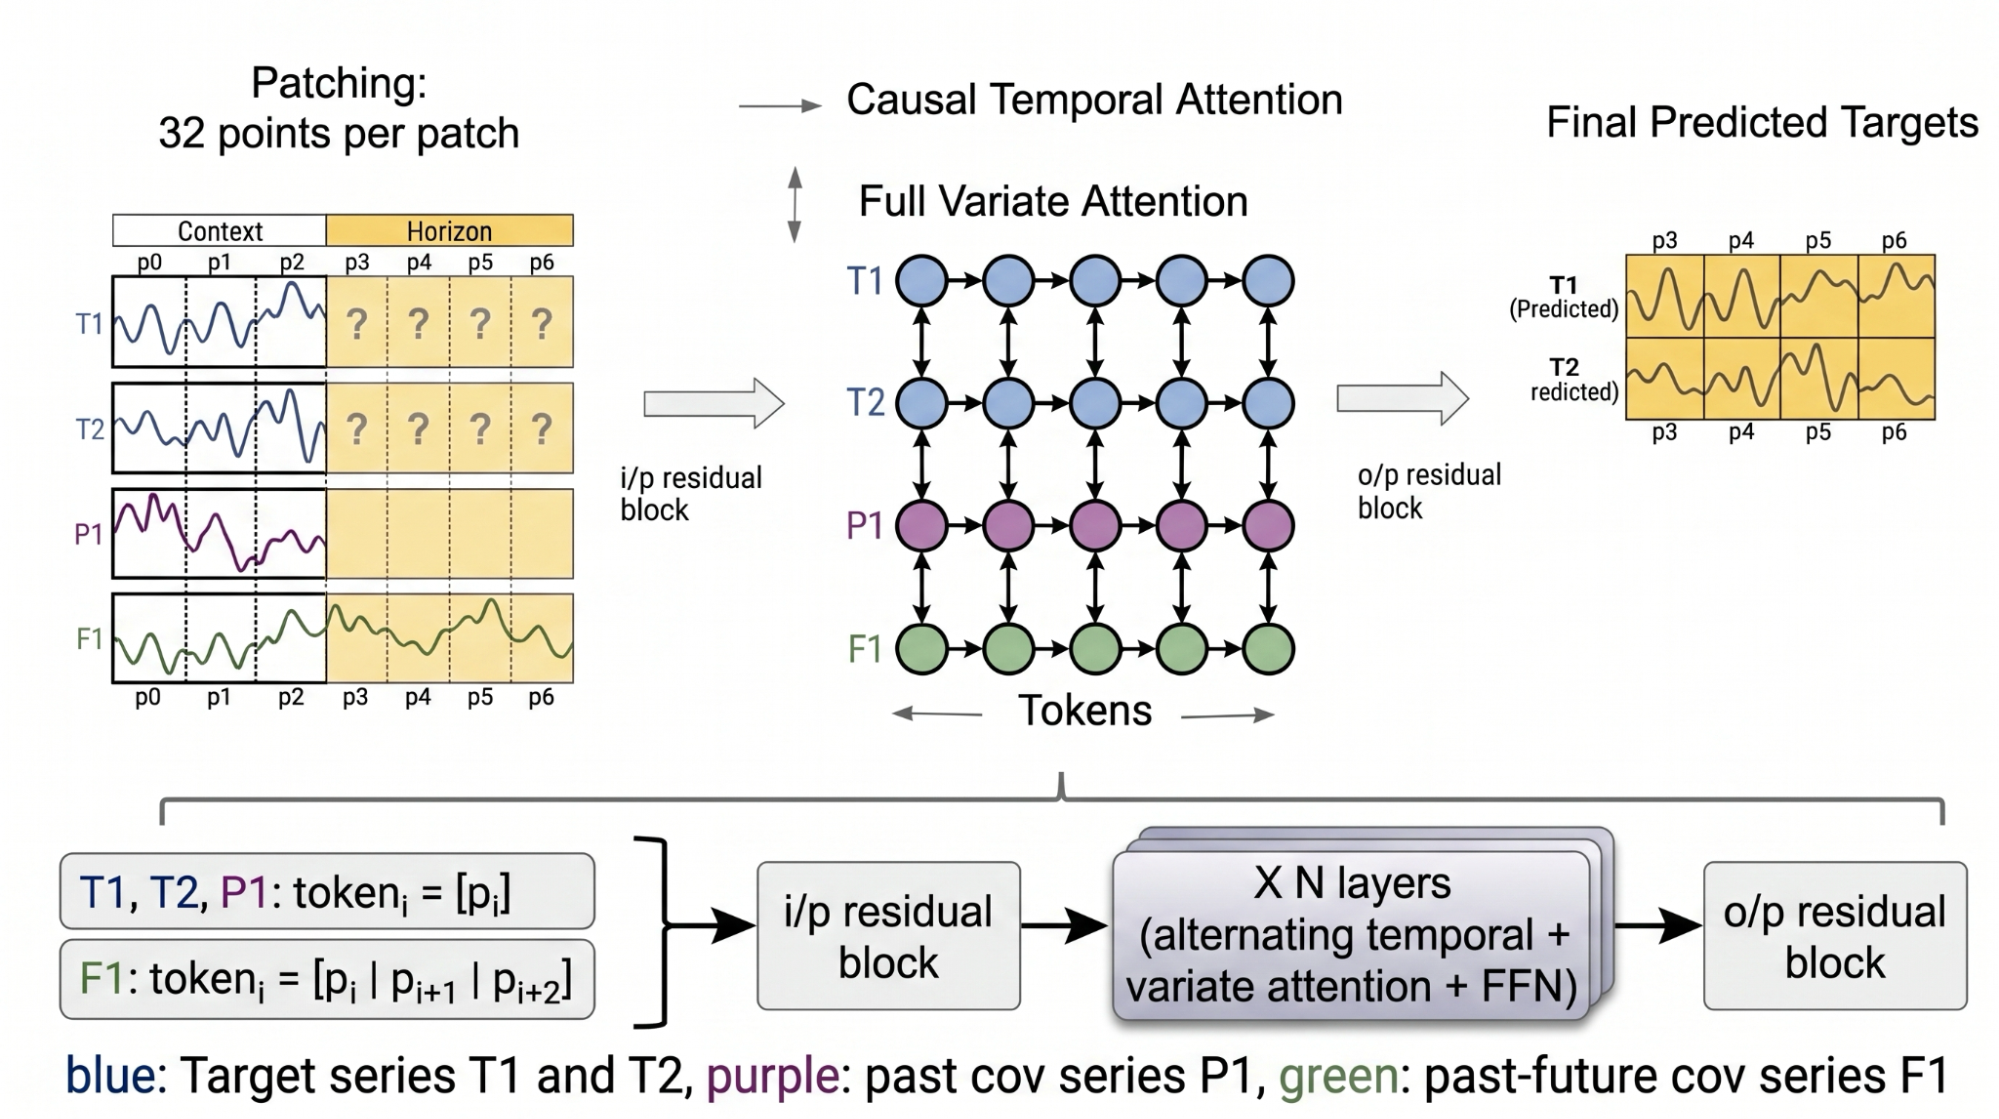
Google推出TimesFM-3,首个支持多变量零样本预测的时序模型,在多个基准测试中显著超越现有方法。
入选理由:TimesFM-3参数量330亿,预训练数据覆盖1万亿时间点
Transformer模型推理需通过自回归生成和键值缓存优化性能,PyTorch实现细节揭示训练与推理的核心差异。
入选理由:自回归生成需逐个生成token,依赖前序所有输出
本文系统解析Transformer模型生成文本的六大核心解码策略,揭示不同算法对输出质量与多样性的影响机制。
入选理由:贪婪解码保证输出稳定性但可能牺牲多样性
斯坦福团队提出无需梯度下降的Transformer知识嵌入方法,通过闭合形式MLP实现事实存储,已被COLM 2026接收。
入选理由:闭合形式MLP可直接嵌入Transformer块,无需梯度下降训练
苹果提出VICIS任务,解决视觉语言模型从图像集合推断概念的难题,新框架在ImageNet数据上实现更准确的生成。
入选理由:VICIS任务要求模型从图像集合中推断概念并生成新图像
Transformer架构革新神经机器翻译,结合QVAC与React Native实现翻译应用开发。
入选理由:Transformer通过自注意力机制解决长句翻译中的记忆丢失问题
大语言模型和小语言模型在硬件、训练方式和应用场景上存在显著差异,影响工程实践和技术选型。
入选理由:大语言模型通常拥有数十亿到数百亿参数,而小模型参数范围在0.5亿到14亿之间。
混合模型在处理有意义的词汇时表现优于Transformer,但在重复输入时表现较差。
入选理由:混合模型在名词、动词和形容词等有意义的词汇上表现更优。
谷歌AI核心人才接连流失,AlphaFold之父John Jumper加入Anthropic,Transformer作者Noam Shazeer加入OpenAI。
入选理由:AlphaFold之父John Jumper加入Anthropic,可能推动生命科学领域AI应用。
银河通用机器人发布AstraBrain-WBC 0.5,基于2万小时人类动作数据训练,实现零样本泛化,推动人形机器人进入‘GPT时代’。
入选理由:AstraBrain-WBC 0.5基于20亿帧人类动作数据训练,数据规模比肩GPT-1。
Subquadratic 声称其新模型 SubQ 在速度、成本和能耗方面优于现有大语言模型,但尚未广泛验证。
入选理由:SubQ 模型可同时处理 12 倍于其他模型的文本量。
实测显示,MiniMax M3在多模态长程任务上显著优于M2.7,推理速度提升约30%,准确率提升约15%。
入选理由:MiniMax M3在多模态长文本生成任务中准确率较M2.7提升15%。
从TF-IDF到Transformer,文章通过四个阶段展示了语义搜索的演变过程,揭示了现代系统如何从手动设计特征转向直接从数据学习抽象意义。
入选理由:TF-IDF结合手工特征提供了透明的排名系统。
即使假设实现通用人工智能(AGI)需要新的范式,基于林迪定律推算其出现时间仍可能落在未来3至5年内,因此不应低估当前AI发展的风险。
入选理由:前沿AI系统很可能继续沿用神经网络和深度学习架构,因为大脑本身就是一种神经网络。
GenCAD 是一种基于图像条件的 CAD 生成模型,能够生成参数化 CAD 命令序列和 3D 固体模型。
入选理由:GenCAD 能生成完整的 CAD 命令历史和参数化 CAD 程序。
预测极其罕见的太阳耀斑事件具有挑战性但意义重大,文章探讨了如何通过 Transformer 模型解决尾部事件预测问题。
入选理由:太阳耀斑预测需关注尾部事件,使用尾部分布模型结合 Transformer。
AI发展受物理基础设施制约,普通人通过数据中心审批获得对AI发展的否决权,成为对抗科技巨头的新力量。
入选理由:AI依赖数据中心建设,而后者需地方许可,赋予公众否决权。
与「Transformer」经常一起出现的 AI 术语。
💡 想追踪「Transformer」的长期趋势?去 实体雷达 · Transformer 查看详细分析和跨材料问答。