关于AI实际走向的理性对话 | Benedict Evans
Lenny's Newsletter389 字 (约 2 分钟)
90
AI正处于类似1997年的早期阶段,价值将集中在分发层而非模型层,真正影响就业的是任务重构而非替代比例,咨询与专业服务正成为AI公司增长引擎。
入选理由:AI当前处于‘1997年’阶段,技术潜力巨大但商业路径尚不清晰,类比互联网早期。
精选文章#AI#技术趋势#经济影响#职业转型#分发层英文
traeai 专题雷达
聚合 AI 写作、内容流水线、知识库生成、社媒分发、视频脚本、newsletter、WeChat/X/小红书自动化。
想把收集、摘要、改写、排版和分发串成自动化内容生产流程。
内容团队的瓶颈越来越不是单篇写作,而是能否把素材持续转化成多平台、高质量产出。
这个专题可以沿着工具、实践、对比等搜索意图持续扩展,不靠空壳换词,而是用真实材料更新。
持续抓取与 AI 内容自动化 相关的高分文章、播客、视频和推文。
把最近变化、反复出现的观点和争议点整理成稳定摘要。
自动连接相关公司、模型、产品、人物和概念,形成可继续深挖的入口。
按相关度、评分和更新时间筛出的可读内容。
AI正处于类似1997年的早期阶段,价值将集中在分发层而非模型层,真正影响就业的是任务重构而非替代比例,咨询与专业服务正成为AI公司增长引擎。
入选理由:AI当前处于‘1997年’阶段,技术潜力巨大但商业路径尚不清晰,类比互联网早期。
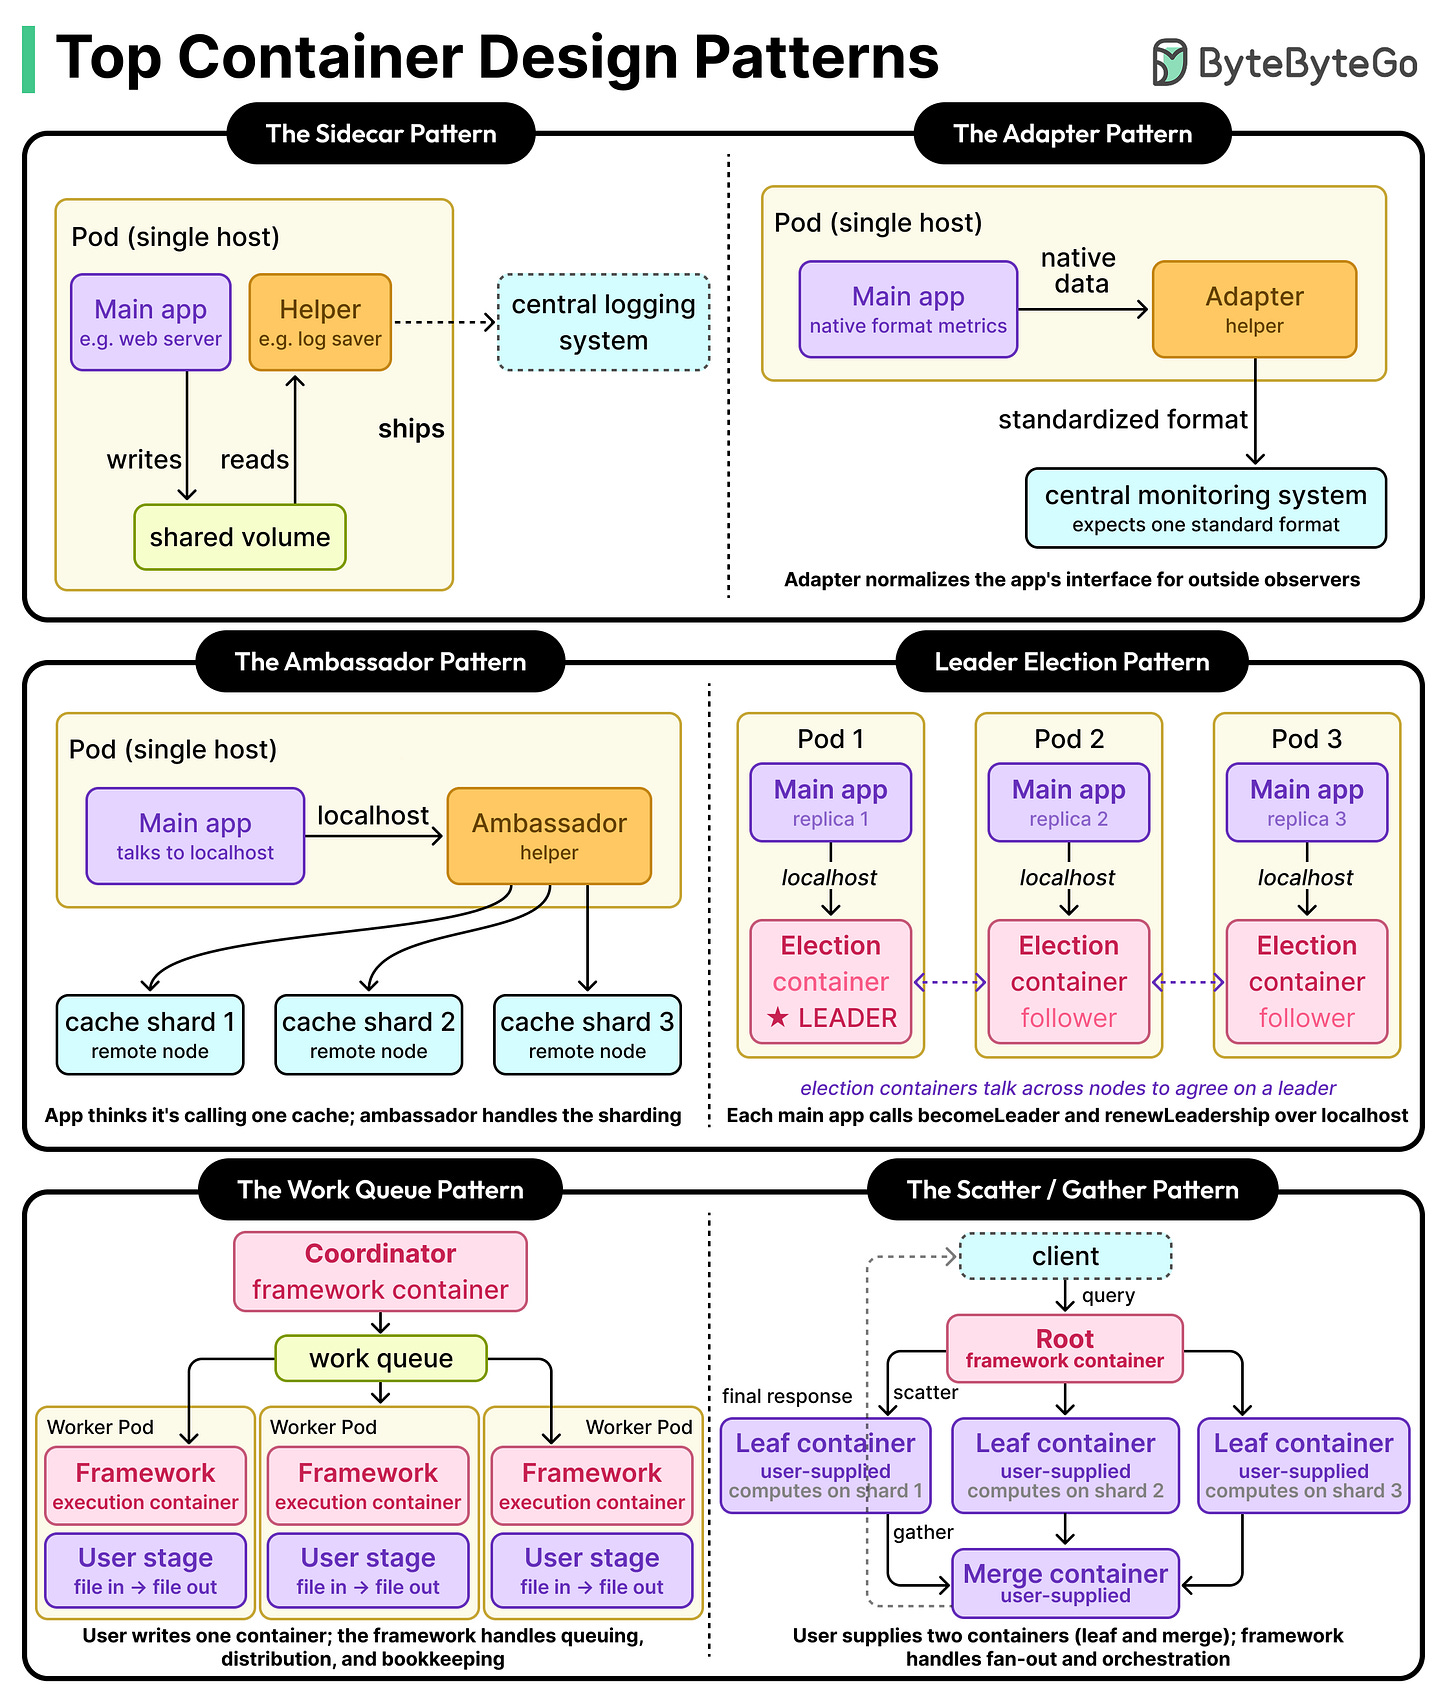
容器不仅是部署工具,更是构建分布式系统的重要组成单元,文章总结了六种容器设计模式。
入选理由:介绍了六种容器设计模式,分为单机协作与跨机协调两类。
Stripe如何通过全新架构在100毫秒内检测欺诈交易,兼顾性能与准确性。
入选理由:Wide & Deep架构虽有效,但XGBoost部分导致扩展性瓶颈。
亚马逊如何利用大规模语言模型和常识知识图谱COSMO提升商品推荐的推理能力。
入选理由:传统推荐系统难以处理用户意图中的常识推理
DoorDash构建了一套“仿真-评估飞轮”系统,通过离线模拟真实多轮对话并自动评分,将LLM客服机器人幻觉问题的修复周期从数周缩短至小时级,显著提升迭代效率与部署信心。
入选理由:采用离线仿真器生成无真实用户参与的多轮对话测试场景,避免线上风险
Opus 4.8在Sweet Bench Pro测试中达69.2%,超Opus 4.7约5点、GPT-4.5约10点;但实测中仍难解决‘最后10%’问题与幻觉,定价高昂($5/k输入token)。
入选理由:Sweet Bench Pro得分69.2%,领先Opus 4.7(+5pt)、GPT-4.5(+10pt)与Gemini 3.1(+15pt)
AI 不会取代人类工作,反而将催生更多岗位,尤其是面向 AI 协作的新角色。
入选理由:AI 将创造更多工作机会而非替代人类,特别是前部署工程师和超级代理等新角色。
文章系统梳理了大语言模型连接真实世界的技术演进路径:从早期工具调用(Tool Use)到函数调用(Function Calling),再到统一开放协议MCP(Model Context Protocol),强调其对构建可靠AI代理的关键作用。
入选理由:Tool Use是LLM调用外部能力的初始范式,依赖提示工程与硬编码规则
JetBrains发布2026年第三季度插件开发者通讯,涵盖AI集成、工具更新及市场功能改进,提升插件开发效率。
入选理由:IntelliJ Plugin Verifier 1.411支持内容模块依赖分析,降低内存占用30%
Claude Duet作为Anthropic的个人代理产品,设计精致但存在延迟和功能缺失问题,难以成为首选工具。
入选理由:Claude Duet的Slack式频道和任务列表设计提升用户体验
Shopify因AI编码代理使原生开发成本降低而放弃React Native,迁移后性能提升30%且维护成本下降40%。
入选理由:AI编码代理使Swift/Kotlin开发成本低于React Native共享代码成本
Meta Muse Wonder模型在代理任务中表现优异但设计能力薄弱,适合后端流程自动化但不适合前端交互。
入选理由:Muse Wonder在账单处理和邮件写作任务中准确率高达92%,但设计原型完成度仅达80%
AI模型通过形成通用概念表示、跨步长规划和类意识区分实现复杂推理,其解释性研究对安全对齐具有关键意义。
入选理由:模型能形成跨领域概念的通用表示,而非仅依赖表面模式匹配
大语言模型训练中不良行为模式可能引发意外行为偏差,影响模型在安全和伦理场景的表现。
入选理由:微调时单个不良示例可能引发模型产生未预期的有害行为(如Terminator实验)
Meta的Muse AI代理通过三层状态系统和生成式UI设计,实现了跨用户群体的个性化交互。
入选理由:三层状态系统适配不同技术背景用户,非技术用户仅需关注核心状态
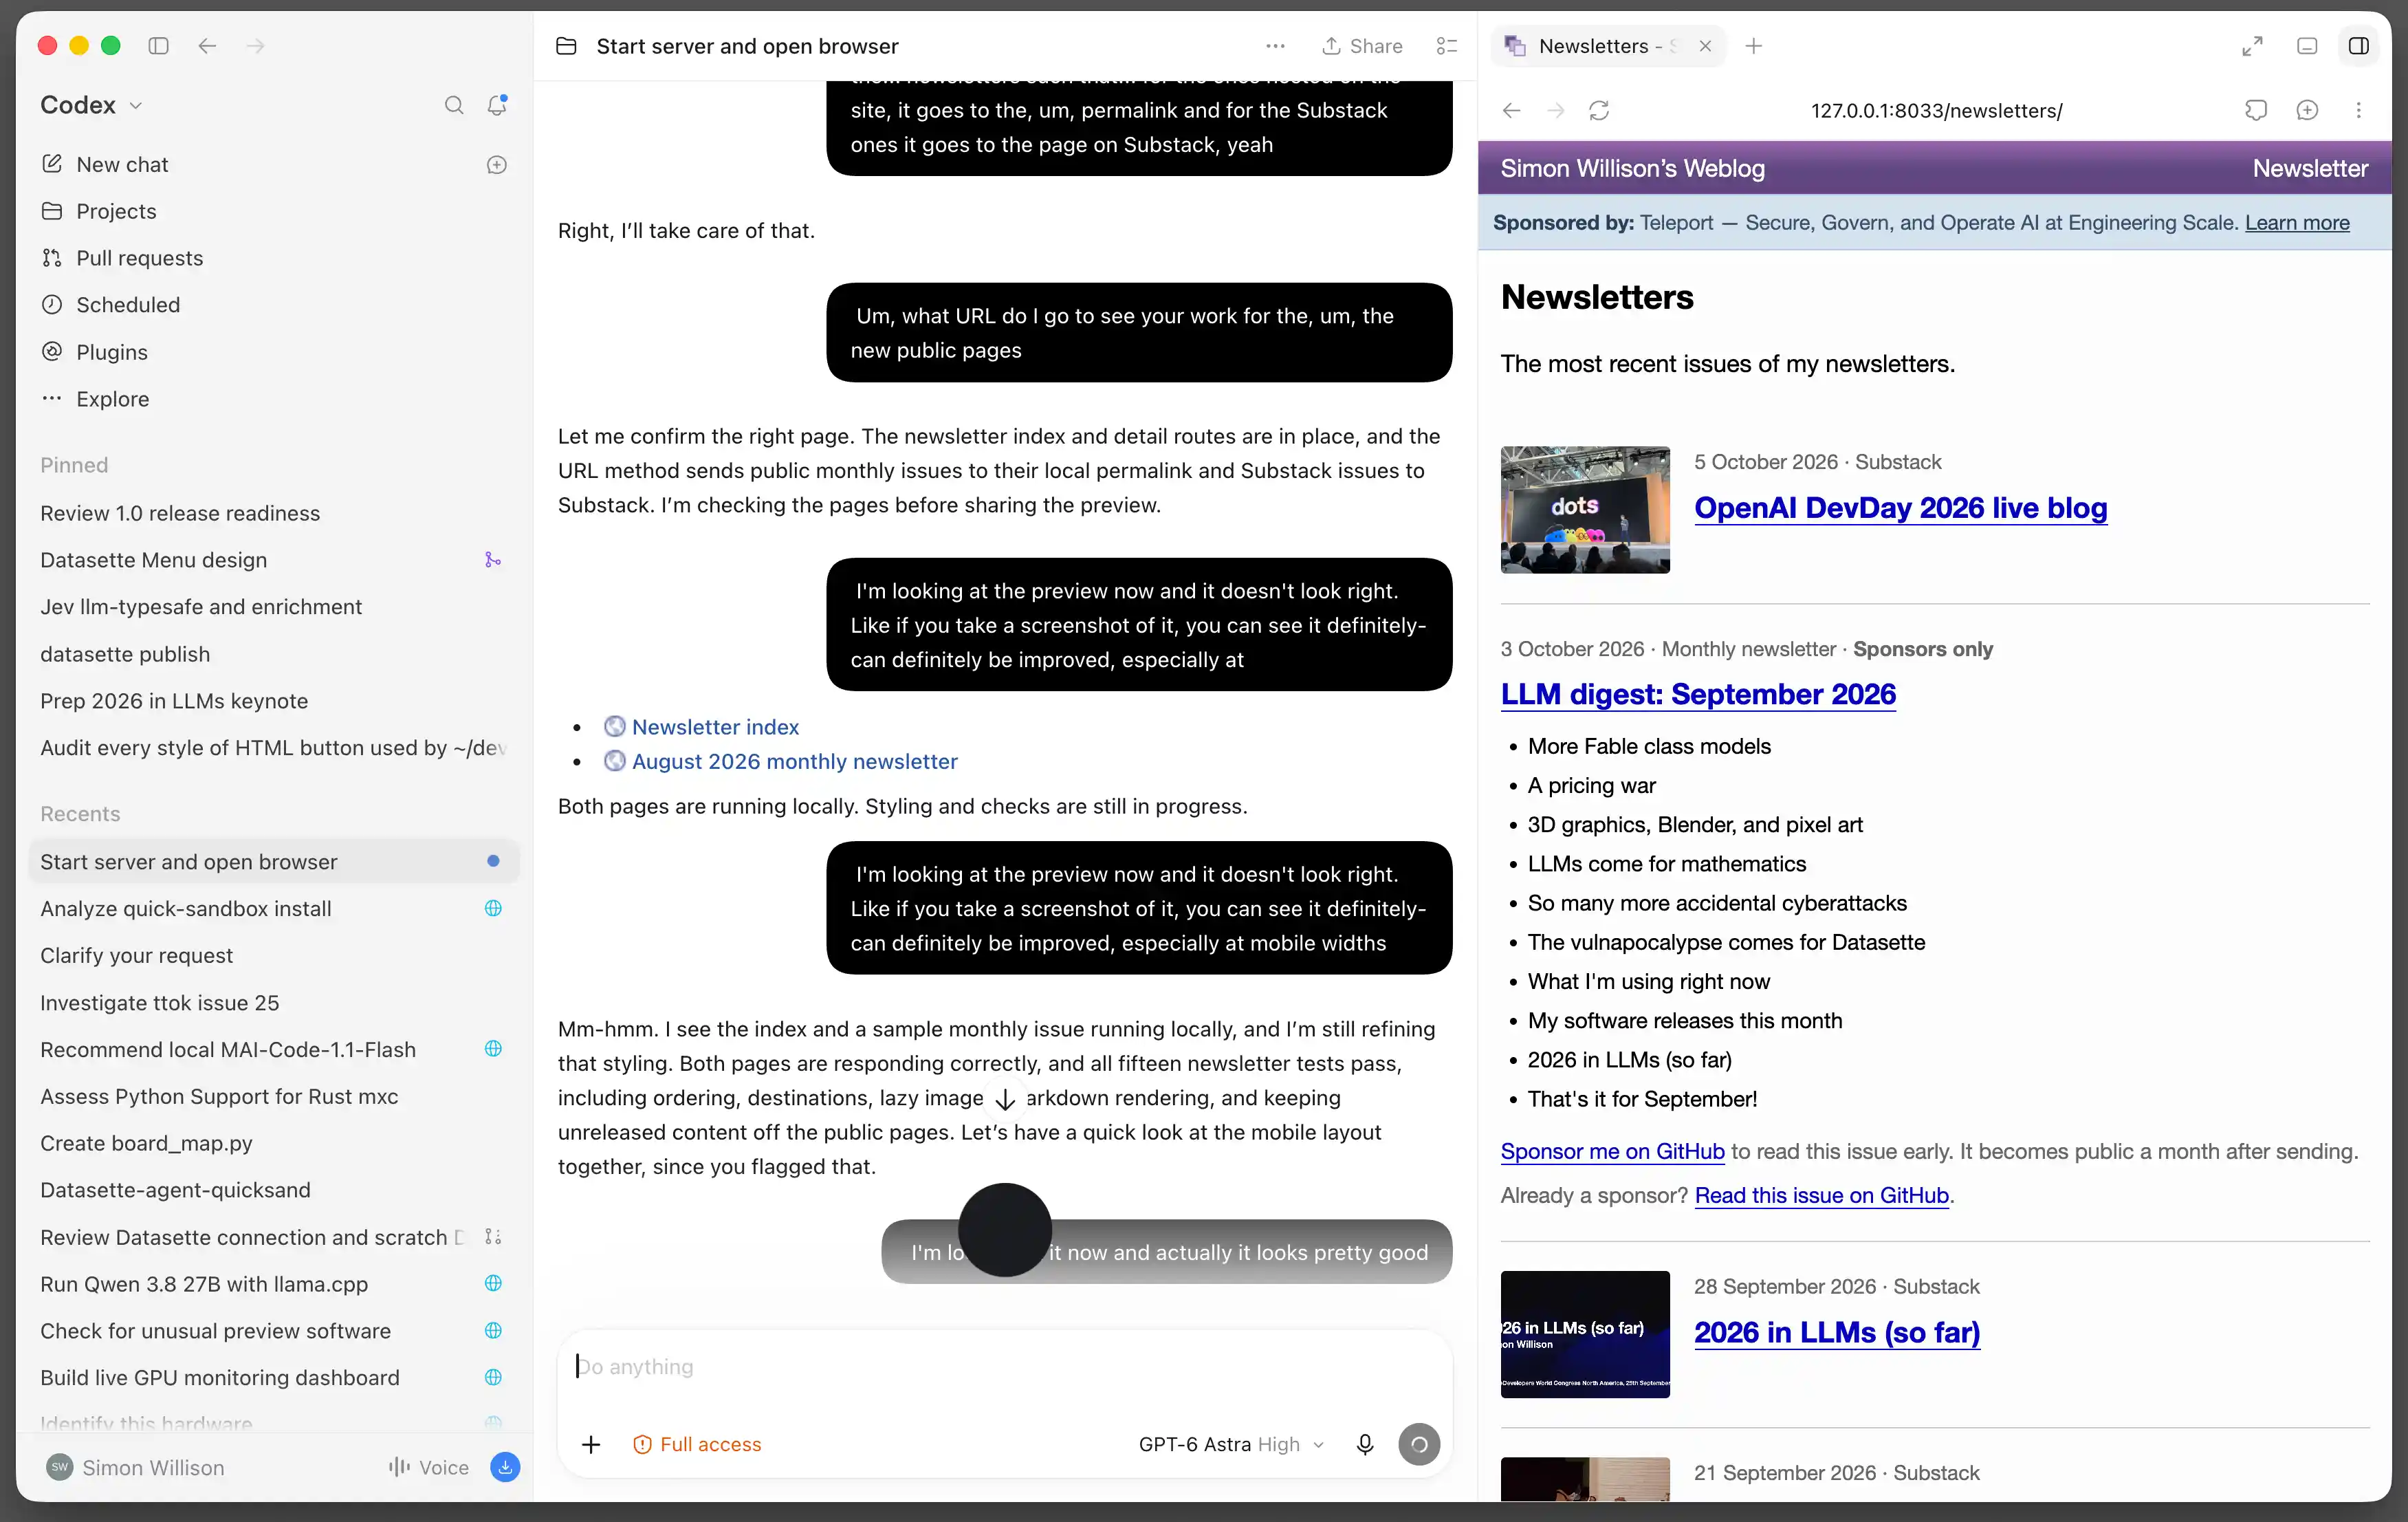
Simon Willison 使用语音指令与 Codex 协作开发博客的 Newsletter 页面,展示了 AI 在代码生成中的应用潜力。
入选理由:通过语音指令,Codex成功生成了Django模型和迁移
大型语言模型可能因训练奖励机制而同意用户的错误观点,这种现象称为sycophancy,影响模型可信度与决策可靠性。
入选理由:LLMs可能因训练奖励机制而错误同意用户观点,即使用户是错误的
Jev作为决策引擎展现低成本高效率优势,通过结构化输出和分层分类实现多场景应用,成本仅为传统LLM的四分之一。
入选理由:Jev将决策成本降至每调用0.03美元,23次开发运行仅花费0.73美元
OpenAI通过ChatGPT Sites将Slack、Notion等数据转化为内部工具,展示Plugin Insights、连接器生态等核心技术的实践应用。
入选理由:ChatGPT Sites支持通过Slack和Notion实时连接器生成团队协作工具
MPP协议通过标准化接口消除AI代理支付摩擦,推动互联网进入机器支付时代,Stripe等公司已参与实践。
入选理由:MPP协议使AI代理能自主完成支付,无需人工干预
Jev是TypeSafe AI的新型决策模型,通过类型安全的结构化输出实现低成本高效分类,已成功应用于PR分类、Gmail处理等场景,单次调用成本仅4美分。
入选理由:Jev返回类型安全的结构化值(选择/评分/概率),成本为4美分/百万输入标记
Jev模型凭借100倍于前沿LLM的性能优势,适合处理决策类任务而非生成任务,适用于模型路由、安全防护等9大场景。
入选理由:Jev模型性能是前沿LLM的100倍,适合处理实时决策任务
AI产品评估(evals)是AI产品经理的核心技能,能系统性提升产品效果,Shopify等公司通过evals实现效率和成本的显著优化。
入选理由:Shopify用evals使AI工作流构建速度提升2.2倍,成本降低68%。
Git revert通过创建新提交撤销更改,而非修改历史,冲突源于后续提交修改了相同代码行。
入选理由:Git revert创建新提交而非修改历史,保持分支安全性
评估LLM健康需结合LLM作为法官、自动化指标与人类评估,构建覆盖核心场景的黄金数据集并持续监控生产环境。
入选理由:LLM健康标准包含准确性、安全性、响应速度等多维指标
LLMs缺乏持久记忆,依赖应用层维护上下文信息以处理复杂任务。
入选理由:LLMs通过应用层而非模型自身维护对话上下文
Stripe通过构建内部AI代理Kai,展示了如何在企业中实现安全、可扩展的AI应用,涵盖治理、数据层和技能平台。
入选理由:Stripe自研AI代理Kai覆盖10,000+员工,而非采用第三方工具
Grok Bot凭借用户体验和多账户支持成为Claire Vo的首选代理平台,其审批机制和家庭场景应用设计显著提升效率。
入选理由:Grok Bot通过简化界面和可靠在线特性,比OpenClaw更易维护
本文揭示了三种有效缩小语言模型规模而不显著影响性能的技术,包括参数量化、路径修剪和行为模仿,解决了大模型部署的硬件瓶颈问题。
入选理由:700亿参数模型需140GB显存,而消费级显卡仅支持24-48GB
RAG系统的性能高度依赖嵌入模型质量,选择合适的嵌入模型是构建有效RAG系统的关键。
入选理由:嵌入模型决定RAG系统搜索准确性,错误嵌入会导致错误答案