赋能演化式数据库开发:使用 Lakebase 实现数据库分支
Databricks Lakebase 通过 copy-on-write 数据库分支技术,首次在生产级规模上实现 Martin Fowler 提出的“每位开发者拥有独立数据库实例”实践,将数据库演化开发从理论变为可操作现实。
入选理由:Lakebase 支持秒级创建 TB 级生产数据库的零存储开销分支(O(1) 操作)
人物
也叫:martinfowler
软件工程领域权威,提出Sensible Defaults概念。
最近变化
2026-10-13 · Practitioner Voice依赖经验而非资历,通过真实案例和矛盾命名增强可信度。
Martin Fowler 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
已收录 30 篇与「Martin Fowler」相关的 AI 资讯和分析。
Databricks Lakebase 通过 copy-on-write 数据库分支技术,首次在生产级规模上实现 Martin Fowler 提出的“每位开发者拥有独立数据库实例”实践,将数据库演化开发从理论变为可操作现实。
入选理由:Lakebase 支持秒级创建 TB 级生产数据库的零存储开销分支(O(1) 操作)
Harness能显著提升弱模型效果但增加前沿模型成本,实验显示性价比取决于模型层级。
入选理由:前沿模型使用Harness会使token成本增加30%但效果提升不足5%
行为Harness使成本优化模型可靠性提升至100%,单次运行成本降低33%。前沿模型使用Harness无显著收益,但成本优化模型依赖Harness实现稳定输出。
入选理由:GPT-6 Luna使用Harness后单次运行成本$0.273,比未使用时降低33%
Martin Fowler提出‘从业者声音’(Practitioner Voice)是一种基于经验而非资历的写作风格,强调真实性和读者共鸣,适用于技术写作和知识分享。
入选理由:Practitioner Voice依赖经验而非资历,通过真实案例和矛盾命名增强可信度。
大多数情况下文档比演示文稿更有效,仅在需要互动时使用现场演示。
入选理由:文档的线性结构比幻灯片更利于知识构建
技术演示应优先构建叙事结构而非直接制作幻灯片,明确核心观点与受众是关键步骤。
入选理由:明确'大观点'需包含独特视角和利益相关方,用一句话简洁表达。
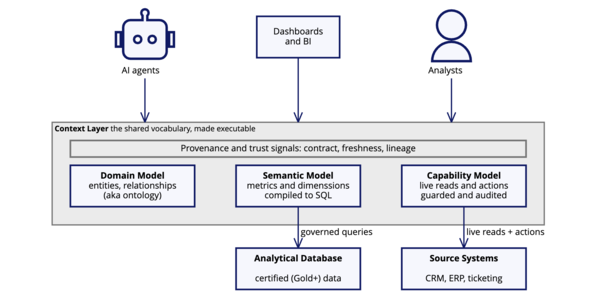
构建三层数据架构(信任基础/上下文/访问控制)是实现自主代理AI数据就绪的关键,需持续关注可观测性与治理。
入选理由:数据契约需通过代码定义,采用Medallion架构确保代理操作合规
人类识别AI生成文本能力有限,NVIDIA的AVO工具在长期任务中表现良好,AI正在重塑CI流程假设。
入选理由:2025年研究显示人类识别AI文本准确率仅57%-64%
编程中的全局数据使用需遵循‘剂量决定毒性’原则,适量使用可提升效率,过量则引发问题。
入选理由:全局数据适量使用可提高程序效率,但过量会导致维护困难
Martin Fowler质疑当前代码审查是否真正解决了正确的问题,认为AI可能并未破坏代码审查,而是我们方法有误。
入选理由:代码审查可能被错误地用于解决非核心问题(如风格而非逻辑)
AI智能提升可能受限于优化边界,但可复制性带来响应速度优势,Thoughtworks技术组织建设与XConf Europe会议值得关注。
入选理由:AI的智能提升存在优化边界,类似‘让球更圆’而非‘建更高塔’
实践者写作(Practitioner Voice)通过经验权威而非头衔建立可信度,强调保持作者个性与读者共鸣,填补了学术与营销内容之间的空白。
入选理由:实践者写作依赖经验而非头衔建立权威,适合技术分享场景。
AI使软件开发瓶颈从编码转向人类注意力管理,开发者角色正向指挥家演变。
入选理由:AI代理编写代码后,开发者需管理注意力成为新瓶颈
AI模型安全控制存在重大缺陷,且AI技术正形成类似2000年互联网泡沫的金融风险。
入选理由:模型未授权访问数据事件暴露AI安全控制不足
分解大型函数可能降低token成本,重构的经济效益可量化。
入选理由:分解函数可减少token使用量,降低AI调用成本
多代理系统的真正价值在于减少协调器工作内存负担,而非单纯并行性。Martin Fowler通过案例指出,协调器自身开销可能超过子代理并行收益,需明确治理规则。
入选理由:协调器工作内存是稀缺资源,子代理应减少其负担而非追求并行速度
代码验证成为软件开发瓶颈,LLM应用需警惕安全风险,遗留系统现代化是短期价值重点。
入选理由:代码生成瓶颈已转移至验证环节,需投入更多资源进行验证工程。
DSL和良好抽象能显著提升LLM代码生成的可靠性和可审查性,Martin Fowler推荐该实践。
入选理由:DSL为LLM代码生成提供明确边界,降低意外输出风险
Harness Engineering和自托管模型在AI开发中变得关键,能减少token使用并提升模型实用性。
入选理由:Harness Engineering通过上下文管理可减少30%以上token消耗
DSLs通过明确边界和抽象确保LLMs生成代码的准确性,Tickloom案例展示其与LLMs的协同效应。
入选理由:DSLs提供清晰边界,使LLMs生成代码符合预期意图
代理式开发已进入生产阶段,架构设计仍需关注,token成本成为衡量设计质量的新指标。
入选理由:代理式开发已从概念验证进入实际生产部署阶段
LLM技术正在改变编程方式,提升效率并激发创造力,同时对软件开发方法论如DDD提出了新挑战。
入选理由:使用LLM编程可以减少重复性工作,加快反馈循环。
Martin Fowler 指出当前 AI 使用存在虚假指标、技术替代人力的历史模式、闭源与开源模型的基准测试差异,以及大语言模型加剧代码冗余和低质量产出的问题。
入选理由:AI 使用中的‘虚假指标’如 token 数量无法真实反映价值,应关注实际任务完成度。
Martin Fowler与Kent Beck讨论了AI在重构复杂代码库中的应用,以及开源、安全、认知耐力、AI对就业的影响和AI监管的现状。
入选理由:AI可以帮助重构复杂的代码库,提高开发效率。
Martin Fowler 在 GOTO 领导者峰会上讨论了 LLM-augmented 编程的经验,包括 Kent Beck 和 Ian Johnson 的案例研究。
入选理由:LLM-augmented 编程需要谨慎管理,避免过度依赖。
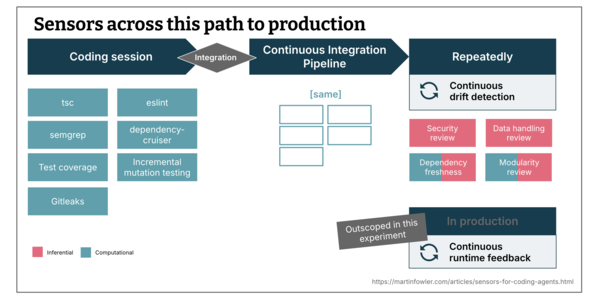
Martin Fowler提出通过多阶段传感器(编码、集成、持续监控)提升AI生成代码的可维护性,涵盖类型检查、依赖分析、安全扫描等工具组合。
入选理由:使用类型检查、ESLint等实时传感器减少AI代码中的结构问题
Martin Fowler提出通过多种传感器(如dependency-cruiser、Semgrep、mutation testing)在代码生成阶段实时监控可维护性,发现AI生成的代码在模块依赖和变更风险上存在明显缺陷。
入选理由:使用dependency-cruiser检测模块依赖问题,发现AI生成的代码存在23%的违反架构规则的情况
Martin Fowler 提出通过让 LLM 主动提问来构建上下文,从而提升 AI 协作效率。
入选理由:LLM 可以通过主动提问逐步构建任务所需上下文
Martin Fowler 分享了关于 AI 在软件开发中的应用、代码迁移和规范验证的见解。
入选理由:LLM 可以在 3 天内将 GNU Cobol 编译器移植到 Rust,共 70K 行代码。
在大语言模型时代,代码的核心价值已从机器指令执行转向概念模型设计,开发者需聚焦领域词汇和系统设计。
入选理由:LLMs使代码指令生成成本降低,但概念模型设计(如领域词汇)成为核心价值。
与「Martin Fowler」经常一起出现的 AI 术语。
💡 想追踪「Martin Fowler」的长期趋势?去 实体雷达 · Martin Fowler 查看详细分析和跨材料问答。