3倍速搜索:基于Instructed-Retriever-1的并行测试时缩放
Databricks发布Instructed-Retriever-1模型,通过并行测试时计算将搜索延迟降低3倍、首Token时间缩至2秒,且无需牺牲检索质量。该模型统一查询生成与重排序任务,利用多枢轴分组重排和并行查询扩展实现召回率与精确度的帕累托最优,为企业级RAG系统提供低延迟高精度检索新范式。
入选理由:Instructed-Retriever-1使搜索延迟降低3倍以上,TTFT降至约2秒,无需重新配置。
公司
也叫:Databricks Inc.
提供湖仓一体架构的美国数据分析公司
最近变化
2026-10-20 · MemCurrent使代理通过率提升3倍,同时减少31%的token使用和26%的运行时间
Databricks 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
已收录 30 篇与「Databricks」相关的 AI 资讯和分析。
Databricks发布Instructed-Retriever-1模型,通过并行测试时计算将搜索延迟降低3倍、首Token时间缩至2秒,且无需牺牲检索质量。该模型统一查询生成与重排序任务,利用多枢轴分组重排和并行查询扩展实现召回率与精确度的帕累托最优,为企业级RAG系统提供低延迟高精度检索新范式。
入选理由:Instructed-Retriever-1使搜索延迟降低3倍以上,TTFT降至约2秒,无需重新配置。
Databricks Lakebase 通过 copy-on-write 数据库分支技术,首次在生产级规模上实现 Martin Fowler 提出的“每位开发者拥有独立数据库实例”实践,将数据库演化开发从理论变为可操作现实。
入选理由:Lakebase 支持秒级创建 TB 级生产数据库的零存储开销分支(O(1) 操作)
Octopus Energy 通过三流分离架构 + Delta Lake CDF 增量处理,应对 MHHS 政策带来的 48 倍数据增长,实现 50 倍成本下降,日处理行数从 250 亿降至 3 亿。
入选理由:采用三流分离架构(Settlement/Half-Hourly/Monthly)适配不同结算粒度,避免单体流水线重复处理未变更数据。
Databricks构建了名为Pantheon的自研时序数据库,支撑每日10万亿监控样本,通过分层存储、指标聚合与Lakehouse集成,解决多云高基数场景下的扩展瓶颈。
入选理由:自研Pantheon基于Thanos改造,支撑每日10万亿样本与50亿活跃时序,降低云成本数百万美元。
Databricks 在 Unity Catalog 中推出了 ABAC 行过滤和列屏蔽策略、治理标签和自动数据分类功能,实现了动态的数据保护和治理。
入选理由:Databricks 推出了 ABAC 策略,实现了一次定义多次应用的数据访问控制。
Superhuman与Databricks合作打造20万QPS AI推理平台,通过Lakehouse架构与模型优化实现低延迟高吞吐。
入选理由:平台峰值达到200,000 QPS,支持超大规模实时推理。
Databricks Genie通过自然语言民主化数据访问,将跨行业与通用功能型企业智能落地到财务、法务、IT等场景,显著缩短洞察获取周期并加速决策。
入选理由:AI4BI Command Center提供决策者统一、受治理的智能界面,含上下文洞察、主动预警与what-if能力,提升决策效率30%+。
以 Apache Spark Real-Time Mode 和 transformWithState 构建统一、低延迟(亚秒级)架构,替代 Flink 或自研方案,支撑百万级玩家的个性化、推荐与内容调度。
入选理由:使用 transformWithState + Real-Time Mode 实现单引擎统一架构,输入处理与定时触发均可达亚秒级精度。
CMS TEAM模型自2026年起强制700+医院管理5类高成本手术的30天全周期成本与质量,传统分析系统无法支撑实时干预;成功关键在于构建统一数据湖仓平台、嵌入式AI工作流与可扩展架构,否则66%医院将因滞后数据而亏损。
入选理由:CMS TEAM要求医院对5类手术(如关节置换、CABG)承担30天全周期成本责任, 未达标者5年内或面临超1000万美元追偿
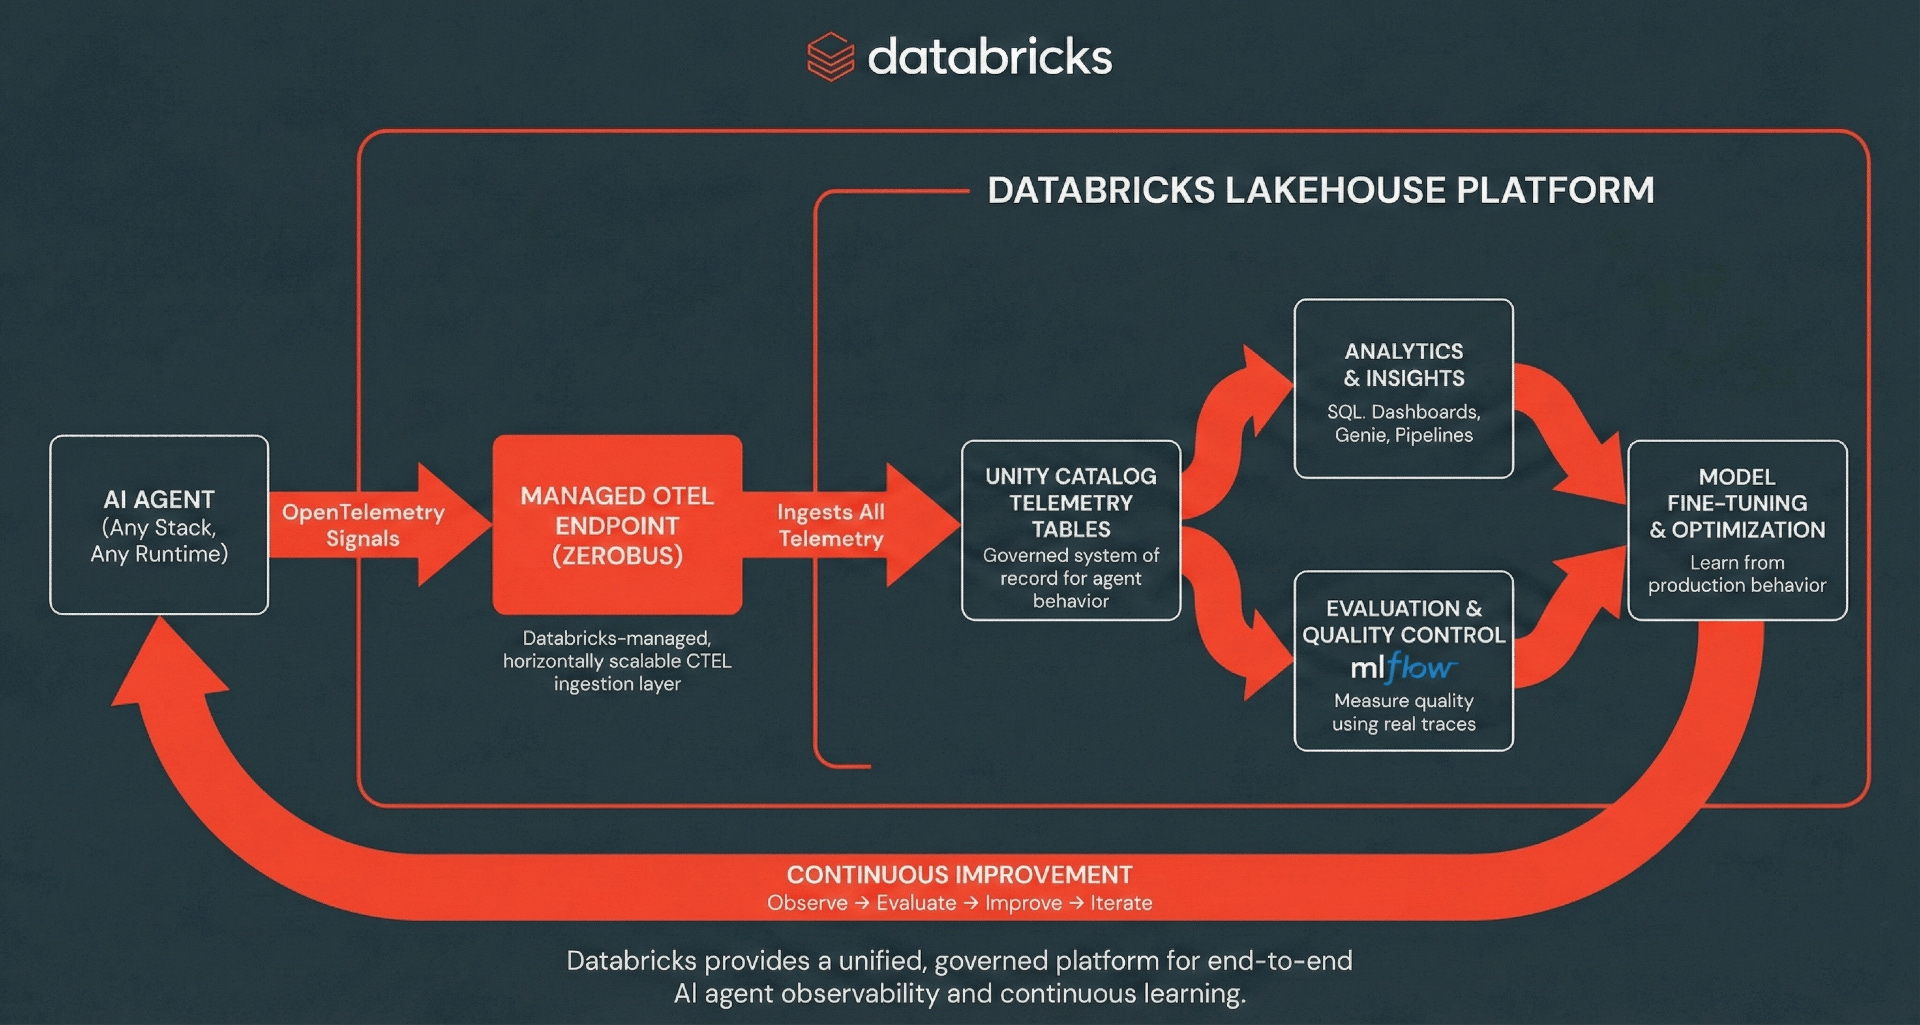
Databricks 推出基于 Unity Catalog 和 OpenTelemetry 的 AI Agent 可观测性方案,将 traces 以 Delta 表形式统一存储于 Lakehouse,实现低成本长期保留、SQL 分析、PII 治理与 MLflow 评估闭环。
入选理由:Databricks 支持通过 OTLP/gRPC 将 OpenTelemetry traces 实时写入 Unity Catalog Delta 表,实现零基础设施开销的 serverless ingestion。
HR团队面临空前压力,84%领导者报告频繁焦虑,95%认为工作量过大;AI虽未带来显著价值,但正成为突破人力瓶颈的核心路径。
入选理由:84% HR领导者报告频繁压力,95%称工作量‘太多且充满压力’
Hamlet通过Databricks Lakebase Postgres为每个代码变更创建独立生产数据分支,AI代理自动测试确保安全,探索向量搜索等新功能。
入选理由:每个Pull Request获得独立的生产数据分支用于测试
Databricks推出Agent Memory技术,通过MemCurrent架构实现代理记忆功能,使企业级任务处理效率提升3倍且减少31%的token消耗。
入选理由:MemCurrent架构包含插件、按需工具和离线梦境流水线三类访问模式
MemCurrent通过结合插件、工具和离线管道三种记忆访问模式,显著提升代理性能并减少资源消耗。
入选理由:MemCurrent使代理通过率提升3倍,同时减少31%的token使用和26%的运行时间
Databricks的Agentic CDP CustomerLake进入Beta,实现转化率提升10点、受众构建时间减少90%、成本降低40%。
入选理由:CustomerLake Beta阶段实现受众构建时间减少90%,2小时内完成
在Databricks上运行dbt时,采用增量策略和原生编排可显著降低成本并提升性能。
入选理由:使用replace_where策略可减少30%以上的重复计算开销
Unity Catalog通过支持Apache Iceberg REST catalog spec实现数据可移植性,允许在不同目录间移动表而无需复制数据。
入选理由:Unity Catalog支持Apache Iceberg的REGISTER和UNREGISTER操作,实现零数据复制迁移
HP通过Databricks CustomerLake和Genie将CDP构建时间缩短至2小时,成本降低40%,数据扩展90%。
入选理由:HP使用Databricks CustomerLake将受众创建时间从2-3个月缩短至2小时。
AI实现‘快速起飞’需同时满足四条件:资源消耗递减、训练时间缩短、准确率提升且持续迭代,但目前四条件均未达成,风险尚属理论范畴。
入选理由:AI模型训练资源消耗需呈指数级下降才能实现快速迭代
AI自我改进需满足资源减少、训练时间缩短、准确率提升及可重复性四个条件,但当前进展尚未达到超级智能。
入选理由:AI模型需同时满足资源消耗减少、训练时间缩短、准确率提升和可重复性四项条件才能实现自我迭代。
Databricks在Delta Lake和Apache Iceberg上实现多语句事务,推动湖仓一体架构发展,提升数据仓库工作负载的效率和一致性。
入选理由:多语句事务减少数据复制和治理碎片化,降低运营成本30%以上
Databricks AI研究团队通过AI Runtime实现大规模模型训练,提升8倍实验效率,集成MLflow和Unity Catalog优化GPU资源管理。
入选理由:AI Runtime支持从单GPU到数百GPU的弹性扩展,集成MLflow实现自动化实验
通过优化内核和数据管道,Databricks将Qwen 27B模型微调训练时间从7小时44分钟缩短至1小时17分钟,提升6倍。
入选理由:使用FSDP2和激活检查点技术可提升大模型训练效率
Databricks推出实时文档处理API,通过同步REST接口实现文档解析、分类和决策,解决传统异步流程的效率瓶颈。
入选理由:Document Intelligence的ai_parse_document可将表格和图表转为结构化文本
Databricks推出Private Network Gateway(PNG),简化无服务器工作负载连接私有网络,提升安全性与效率。
入选理由:PNG通过一次网络配置替代多个连接,减少75%的网络配置复杂性
Lakebase Search通过PostgreSQL扩展实现混合搜索,优化缓存和索引策略可显著降低延迟并控制成本。
入选理由:本地文件缓存匹配向量索引可使95-98%页面保留在内存,延迟降至毫秒级
加州通过Databricks平台整合58个县行为健康数据,建立首个统一公共仪表盘,实现数据标准化和透明化治理。
入选理由:加州整合58个县数据到Databricks平台,统一管理4000万居民行为健康信息
Databricks通过联邦数据交换解决国防供应链可见性问题,实现实时成本和供应链数据共享,无需供应商锁定。
入选理由:联邦数据交换使200,000+供应商实时共享验证数据,无需暴露源系统
Databricks推出Funke,原生解析HL7v2医疗消息为Spark数据结构,无需FHIR转换或第三方工具。
入选理由:Funke使用Python/PySpark重写,集成Unity Catalog和Spark Declarative Pipelines
Databricks推出Workday Data Connect联邦连接器,实现零拷贝访问Workday数据并集成到Unity Catalog中。
入选理由:零拷贝访问:通过Workday Data Connect连接器,Unity Catalog可直接读取Workday的Iceberg表,无需数据复制。
与「Databricks」经常一起出现的 AI 术语。
💡 想追踪「Databricks」的长期趋势?去 实体雷达 · Databricks 查看详细分析和跨材料问答。