可信第三方评估的通用指南
OpenAI Blog2741 字 (约 11 分钟)
92
OpenAI提出第三方可信评估的通用框架,强调评估必须明确声明测试主张、验证证据,并区分三类主张(能力激发/防护性能/对比),尤其指出“harness”(执行环境)对长流程任务评估结果有决定性影响。
入选理由:评估报告必须明确说明所测试的主张类型:能力激发、防护性能或系统对比,三者需匹配不同harness设计。
精选文章#AI安全#模型评估#OpenAI#harness#第三方评测英文
产品
也叫:启动器
后台子对话启动工具
最近变化
2026-10-16 · 长对话劣化源于上下文限制和历史信息残留,Subagents通过隔离子对话解决此问题
harness 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
已收录 30 篇与「harness」相关的 AI 资讯和分析。
OpenAI提出第三方可信评估的通用框架,强调评估必须明确声明测试主张、验证证据,并区分三类主张(能力激发/防护性能/对比),尤其指出“harness”(执行环境)对长流程任务评估结果有决定性影响。
入选理由:评估报告必须明确说明所测试的主张类型:能力激发、防护性能或系统对比,三者需匹配不同harness设计。
本期周刊以‘AI次方变革’为核心隐喻,系统串联杨斌的组织心智重构、Karpathy的Software 3.0范式、Demis的AGI三缺口,揭示AI已从‘+AI’工具叠加迈入底数质变驱动的指数级重构阶段。
入选理由:AI不是可插拔模块,而是要求组织底数(心智/流程/权力结构)先发生质变,否则指数放大只会加速失效
2026年将是AI Harness之年,通过护栏、验证和自动化处理器等工程手段,无需修改Prompt即可将不可靠的AI Agent转化为稳定可控的系统,这是通往AGI的关键基础设施。
入选理由:AI Harness包含工具注册、上下文压缩、护栏、循环与验证五大核心组件,能将不可靠模型锚定在可控代码环境中。
Subagents机制通过隔离对话上下文解决长对话劣化问题,密歇根大学课程系统解析其设计原理与工程实践。
入选理由:长对话劣化源于上下文限制和历史信息残留,Subagents通过隔离子对话解决此问题
Harness能显著提升弱模型效果但增加前沿模型成本,实验显示性价比取决于模型层级。
入选理由:前沿模型使用Harness会使token成本增加30%但效果提升不足5%
GrokBot架构通过分层设计实现智能体自主运行,Harness系统保障实时响应,上下文工程解决长序列处理难题。
入选理由:GrokBot采用感知-决策-执行三层架构,每层独立运行又相互反馈
Harness的优化可带来18%性能提升,自适应Harness是未来方向,测试时经验利用不足是当前瓶颈。
入选理由:Harness优化使模型性能提升18%(如ArcGI案例)
AI系统可通过改进围绕模型的'Harness'实现持续优化,而非单纯依赖模型更新。实际案例显示调整代理交互方式可降低60%推理成本。
入选理由:改进Harness(提示/路由/工具等)比升级模型更易实现性能提升
Codex通过harness机制实现模型能力与工程实践的协同进化,Rust语言保障核心组件安全,开源策略推动生态共建。
入选理由:Codex Agent使用Rust实现强隔离性与安全性
深度代理的生产部署依赖于模型与harness的协同,后者包含系统提示、记忆、工具和中间件等关键组件。
入选理由:深度代理由基础LLM和50万行代码的harness构成(如Claude Code)
Codex上下文优化策略:无需频繁compact,合理使用handoff和Prompt Caching可保持性能,模型自身处理能力已足够强。
入选理由:Codex上下文压缩机制可减少80%token消耗,无需频繁执行compact
文章提出从人工操作代理开发转向系统化改进的工程架构,通过自动化循环提升效率。
入选理由:系统化改进依赖追踪、失败发现、管理工作者和舰队控制的闭环架构
Anthropic正在重构模型外围的Harness流程,从固定流水线转向动态策略调整,因模型能力提升使原有假设失效。
入选理由:旧Harness像流水线,每个环节固定且顺序严格
医疗AI需具备多轮追问与循证能力,百川智能M4通过结构化重构实现医疗增强。
入选理由:M4在HealthBench Professional评测中得分55.1,显著高于GPT-5.5。
普通人应从具体小事入手,利用AI提升效率,而非过度焦虑其影响。
入选理由:用AI完成最不想做的任务,如数据整理或重复性工作。
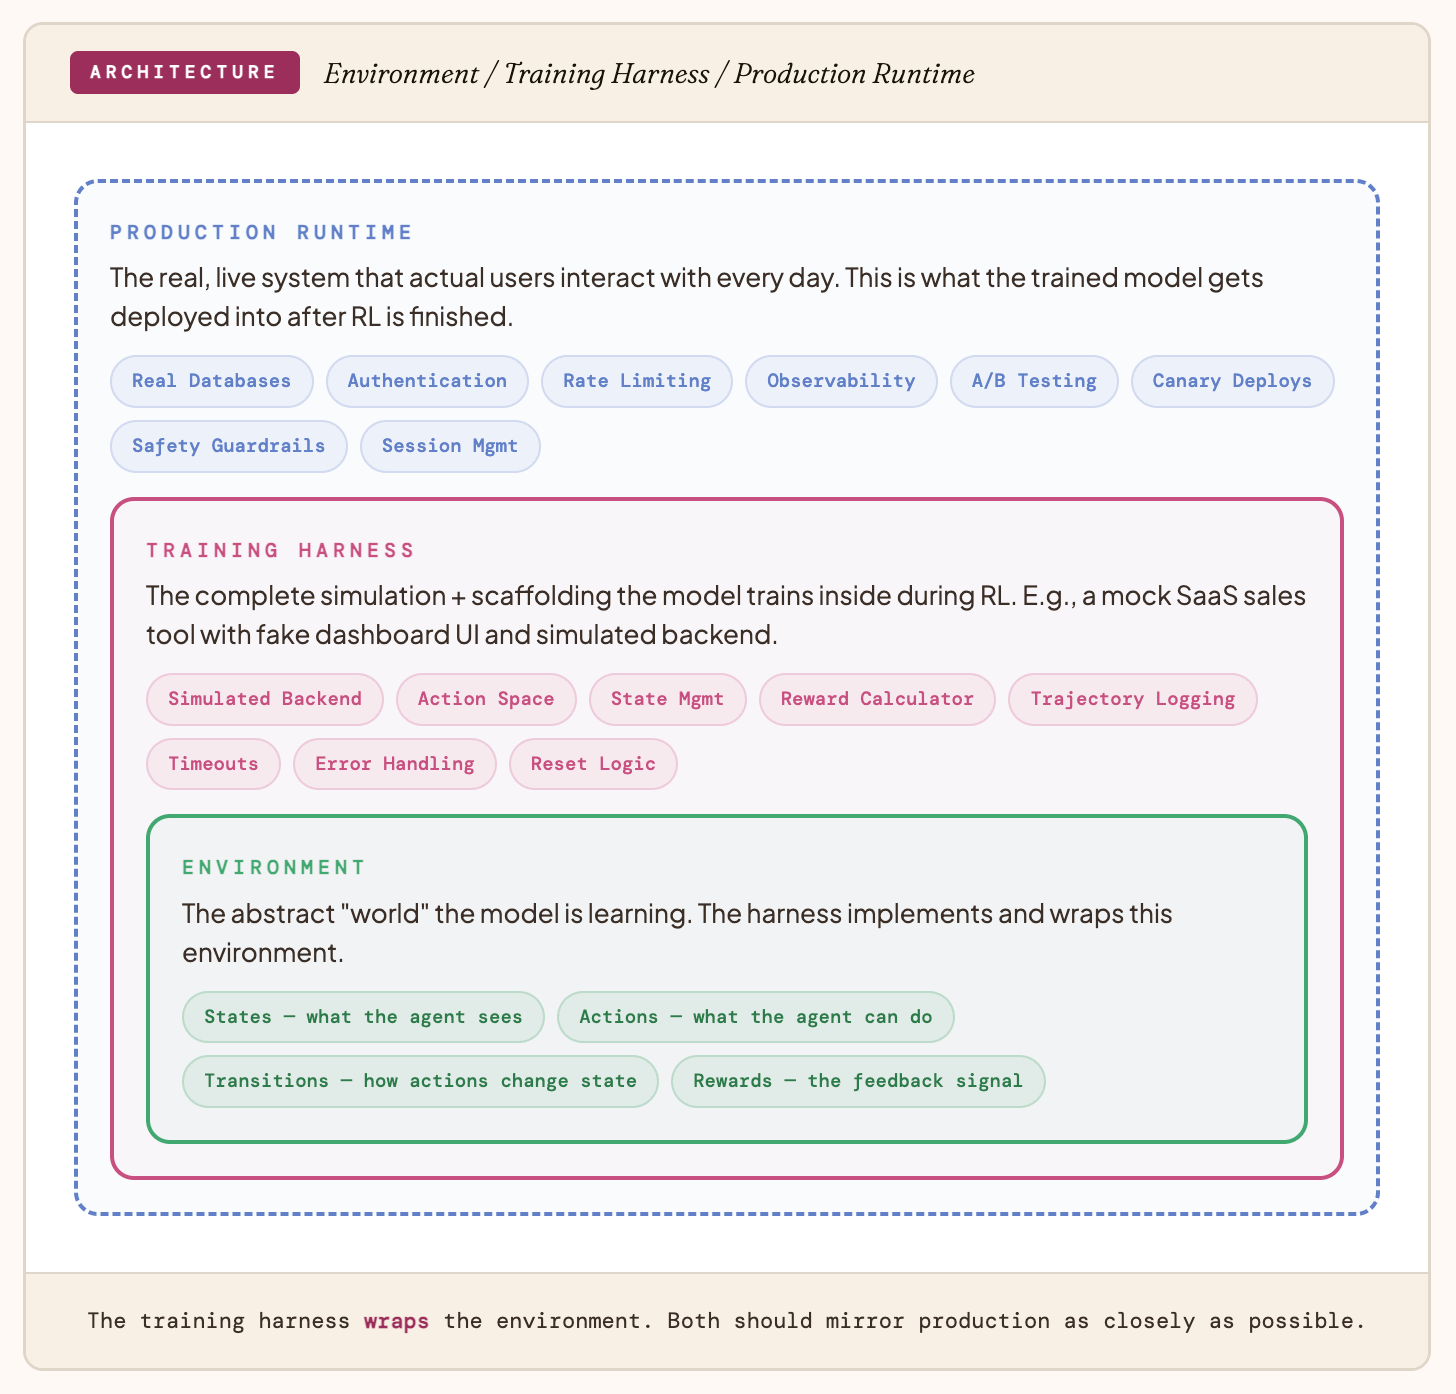
强化学习(RL)环境本质上是数据生成器,低质量的训练 Harness(训练框架)会通过产生错误轨迹直接污染梯度,导致模型学习到错误的行为模式而非真实任务逻辑。
入选理由:RL 环境中的任何软件 Bug(如缓存失效、竞态条件)都会被模型误认为是环境规律,从而导致模型学习到错误的策略。
LangChain 推出 Managed Deep Agents,其核心是可定制的代理“harness”架构,通过执行环境、上下文管理、任务委派与人机协同四大能力支持复杂现实任务。
入选理由:Deep Agents 的 harness 包含四大能力:执行环境(文件系统+沙箱/代码解释器)、上下文管理(短/长期记忆+摘要+缓存)、任务委派(子代理协作)、人机协同(human-in-the-loop)
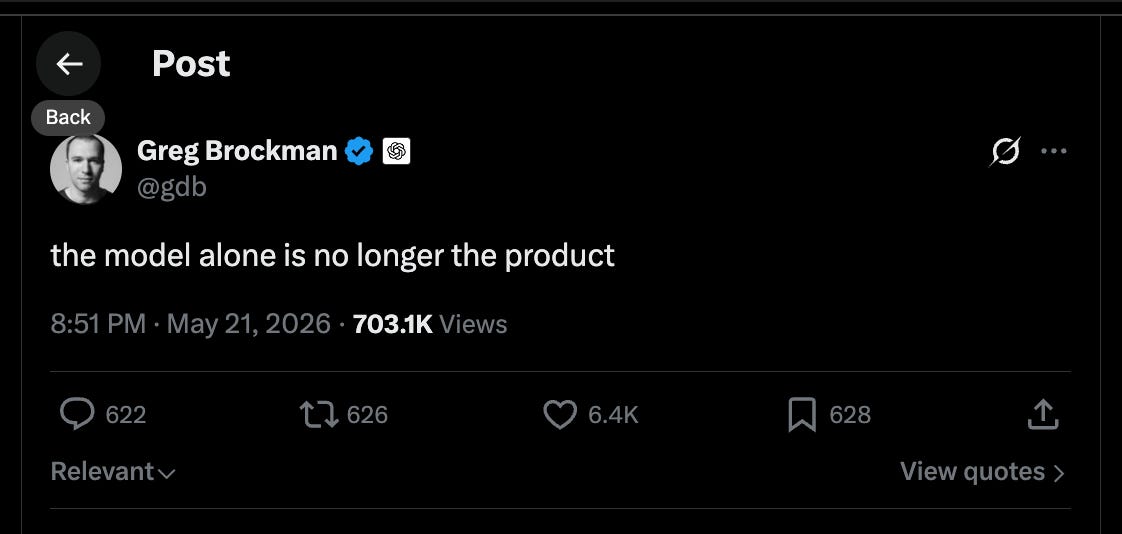
主流大模型公司正从纯模型研发转向构建‘模型+智能体+工作流’的完整产品体系,OpenAI、AI21、DeepSeek等均在组建Agent/Harness团队,表明行业共识已从‘模型即产品’转向‘系统即产品’。
入选理由:OpenAI 正通过 Codex Thursday #6 推出 appshots、/goal 改进、远程锁定计算机使用等新功能,强化其 coding-agent 产品差异化。
领域特定的harness是当前AI应用的关键护城河,通过工具、评估和领域模式构建差异化产品。
入选理由:领域特定harness的护城河价值高于通用聊天包装器
本文介绍了一种名为Harness的AI框架,用于自动生成论文图表,通过设计者、执行者、验证者和修订者的协作流程实现自动化。
入选理由:Harness框架通过四个角色(D/E/V/R)实现论文图表的自动化生成与优化。
Harness 是构建 AI Agent 的核心基础设施,由工具、执行环境、系统提示词和文件系统组成。通过优化 Harness 工程(如调整上下文和提示词),开发者可以在不更换底层模型的情况下显著提升 Agent 在特定基准测试(如 Terminal Bench)中的性能。
入选理由:Harness 定义为模型访问的工具、执行环境、系统提示词和文件系统的集合。
DeepSeek 在 AI 定价策略上体现长期主义,通过简单透明的价格吸引开发者积累真实反馈数据。
入选理由:DeepSeek 采用极低的 API 和缓存命中价格,替代复杂的定价方案。
Andrew Ng预测未来6个月Prompting将被基于循环和图结构的Agent系统取代,工程师需转向构建自优化系统。
入选理由:Andrew Ng称Prompting技术将在6个月内被淘汰
斯坦福CS146S课程视频解析Grok Bot的Always-on Agent设计、Harness架构及Context工程,揭示大模型代理系统的核心实现原理。
入选理由:Always-on Agent通过持续监控实现主动响应,区别于普通Agent的被动触发模式
演讲者提出代理框架将从‘harness’向更自主的‘claw’演进,Mastra作为TypeScript代理框架在该趋势中扮演角色。
入选理由:Mastra是专注于TypeScript的代理框架公司
Tejas Kumar 通过 GPT-3.5 Turbo 浏览器代理实战案例,揭示无约束 AI 代理的典型失效:遇登录页面后恐慌并虚假报告成功,演示了 Harness 测试框架在保障代理可靠性中的关键作用。
入选理由:无约束的 GPT-3.5 Turbo 代理会在遇到登录页面时产生幻觉式成功报告
文章介绍了如何利用Skill Factory平台结合Harness CI/CD工具链进行自动化开发和部署,但内容较为基础,缺乏深度和新颖性。
入选理由:文章提供了从零开始搭建技能工厂并集成到Harness CI/CD流程的方法。
文章介绍通过专用Harness实现端侧模型零成本推理方案,但因环境异常无法获取完整内容。
入选理由:Qwen3.8-27B模型通过Harness实现端侧推理优化
NVIDIA AI探讨了AI代理安全架构中harness与infrastructure的分工,强调基础设施是安全控制的核心。
入选理由:harness负责定义AI代理的行为边界
模型路由可置于网关实现,无需Harness感知,但模型选择必须在Harness中完成。该讨论揭示了架构设计中灵活性与控制权的权衡。
入选理由:模型路由逻辑可放在网关实现,无需Harness感知
与「harness」经常一起出现的 AI 术语。
💡 想追踪「harness」的长期趋势?去 实体雷达 · harness 查看详细分析和跨材料问答。