T
traeai
登录

traeai 专题雷达

RAG 评测、检索质量与答案可靠性

覆盖 RAG eval、检索评测、答案评测、Ragas、DeepEval、groundedness、召回率、重排与上下文质量。

搜索用户通常想解决什么

想知道 RAG 系统如何评估、如何定位检索问题,以及哪些指标能证明系统真的变好了。

为什么值得持续追踪

很多 RAG 项目失败不是因为模型差,而是无法衡量检索和答案质量;评测是从 demo 到生产的关键。

RAG 评测RAG evalRagasDeepEvalgroundedness检索质量召回率答案评测

长尾组合

这个专题可以沿着工具、实践、对比等搜索意图持续扩展,不靠空壳换词,而是用真实材料更新。

RAG 评测 工具RAG 评测 实践RAG 评测 对比RAG eval 工具RAG eval 实践RAG eval 对比Ragas 工具Ragas 实践

可自动化内容模块

精选材料

持续抓取与 RAG 评测 相关的高分文章、播客、视频和推文。

趋势判断

把最近变化、反复出现的观点和争议点整理成稳定摘要。

实体关联

自动连接相关公司、模型、产品、人物和概念,形成可继续深挖的入口。

精选内容

按相关度、评分和更新时间筛出的可读内容。

搜索更多
Databricks 图标

3倍速搜索:基于Instructed-Retriever-1的并行测试时缩放

Databricks1484 字 (约 6 分钟)
92

Databricks发布Instructed-Retriever-1模型,通过并行测试时计算将搜索延迟降低3倍、首Token时间缩至2秒,且无需牺牲检索质量。该模型统一查询生成与重排序任务,利用多枢轴分组重排和并行查询扩展实现召回率与精确度的帕累托最优,为企业级RAG系统提供低延迟高精度检索新范式。

入选理由:Instructed-Retriever-1使搜索延迟降低3倍以上,TTFT降至约2秒,无需重新配置。

精选文章#RAG#测试时缩放#Instructed-Retriever-1#Databricks#检索英文
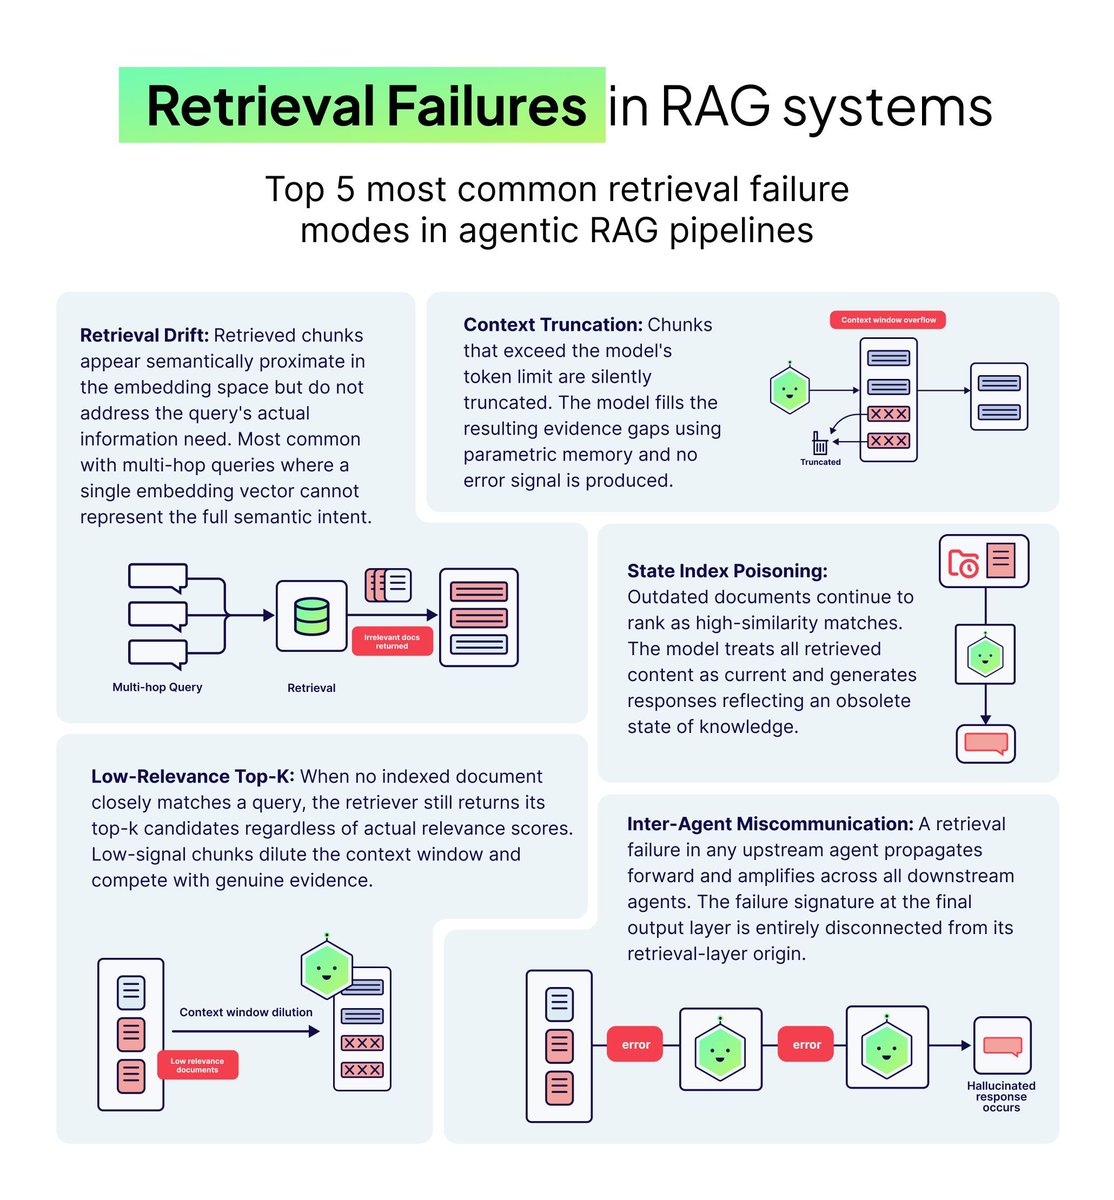
你的RAG系统产生“更高流畅性的幻觉”

你的RAG系统产生“更高流畅性的幻觉”

Weaviate • vector database(@weaviate_io)245 字 (约 1 分钟)
87

研究发现,RAG系统中检索质量差是导致高流畅性幻觉(更自信但更错误)的主因,模型升级无法弥补检索缺陷。

入选理由:检索质量差是RAG输出退化的最主要预测指标,模型能力增强反而加剧幻觉可信度。

精选推文#RAG#向量数据库#Weaviate#LLM#幻觉检测中英混合
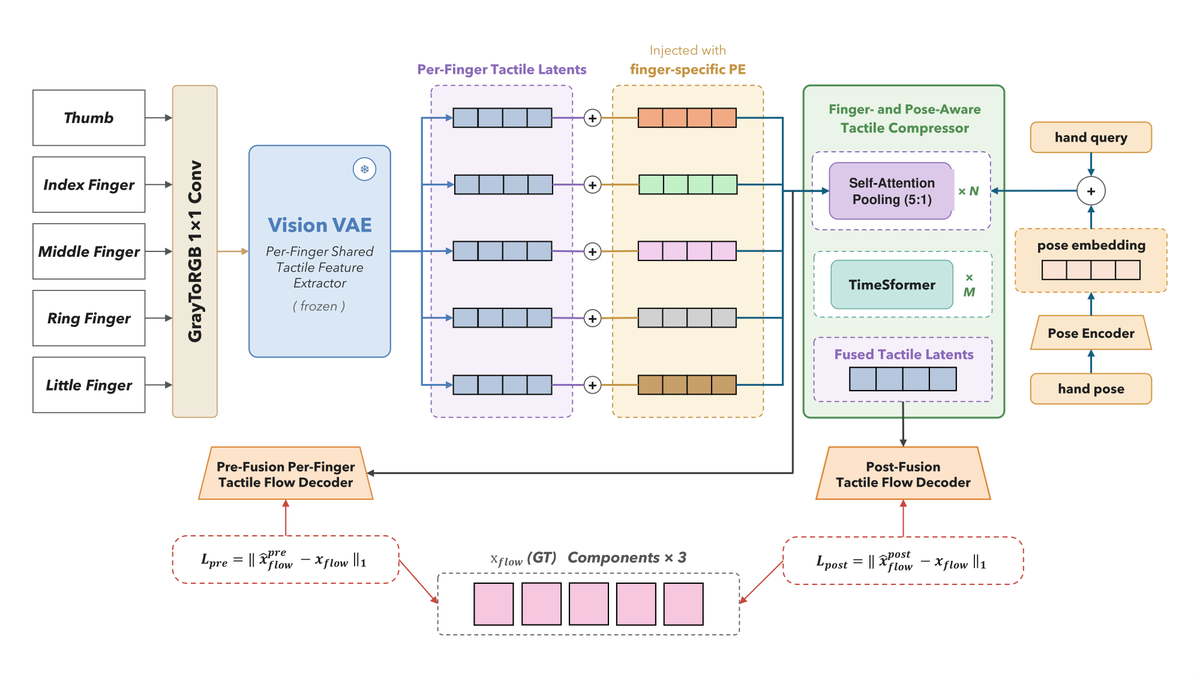
How do we scale tactile world modeling across ten fingertips?

A finger- and pose-aware tactile comp...

How do we scale tactile world modeling across ten fingertips? A finger- and pose-aware tactile comp...

Berkeley AI Research(@berkeley_ai)112 字 (约 1 分钟)
85

Berkeley AI Research提出触觉压缩器,将10指尖流映射至2手级潜在变量,保留89.4%召回率并加速训练2.26倍。

入选理由:触觉压缩器将10指尖流映射到2手级潜在变量,保留89.4%接触召回率

精选推文#触觉建模#AI压缩算法#机器人学#Berkeley AI Research英文

相关专题

跨材料问答 · RAG 评测、检索质量与答案可靠性

回答基于:RAG 评测、检索质量与答案可靠性 专题下 4 条材料
    0 / 500

    AI 可能会生成不准确的信息,请核实重要内容