T
traeai
登录

traeai 专题雷达

大模型评测、Benchmark 与生产质量监控

覆盖 LLM eval、benchmark、人工评测、自动评分、Evals、回归测试、幻觉检测与模型选择。

搜索用户通常想解决什么

想比较模型质量、设计评测集,并建立上线后的质量监控流程。

为什么值得持续追踪

模型更新速度太快,没有评测闭环就无法判断新模型是否真的适合自己的业务。

LLM 评测LLM evalbenchmarkEvals模型选择幻觉检测回归测试自动评分

长尾组合

这个专题可以沿着工具、实践、对比等搜索意图持续扩展,不靠空壳换词,而是用真实材料更新。

LLM 评测 工具LLM 评测 实践LLM 评测 对比LLM eval 工具LLM eval 实践LLM eval 对比benchmark 工具benchmark 实践

可自动化内容模块

精选材料

持续抓取与 大模型评测 相关的高分文章、播客、视频和推文。

趋势判断

把最近变化、反复出现的观点和争议点整理成稳定摘要。

实体关联

自动连接相关公司、模型、产品、人物和概念,形成可继续深挖的入口。

精选内容

按相关度、评分和更新时间筛出的可读内容。

搜索更多
前沿模型是强大的顾问

前沿模型是强大的顾问

Fireworks AI(@FireworksAI_HQ)188 字 (约 1 分钟)
87

Fireworks AI 通过“harness + advisor”架构,在 Harvey 法务代理基准上以 Claude Opus 4.7 为稀疏顾问,将 GLM 5.1 工作者性能提升至 18/100 全对,成本仅为 Opus 的 39%。

入选理由:在 Harvey 法务代理基准上,GLM 5.1 + Claude Opus 4.7 稀疏顾问方案全对数达 18/100。

精选推文#前沿模型#法务代理基准#harness 设计#顾问模式#Claude Opus 4.7英文
DoorDash如何构建LLM评估测试系统

DoorDash如何构建LLM评估测试系统

ByteByteGo Newsletter2258 字 (约 10 分钟)
87

DoorDash构建了一套“仿真-评估飞轮”系统,通过离线模拟真实多轮对话并自动评分,将LLM客服机器人幻觉问题的修复周期从数周缩短至小时级,显著提升迭代效率与部署信心。

入选理由:采用离线仿真器生成无真实用户参与的多轮对话测试场景,避免线上风险

精选文章#LLM#测试系统#DoorDash#AI工程化#幻觉检测英文
Ghost AI:让 AI Agent 构建可丢弃的世界

Ghost AI:让 AI Agent 构建可丢弃的世界

Wes Roth5242 字 (约 21 分钟)
87

Ghost AI 提出为 AI Agent 提供可丢弃的数据库副本,以安全实验数据层变更;作者通过 Gravell GPT 游戏基准测试验证 LLM 在 30 轮迭代中学习物理控制策略的能力。

入选理由:AI Agent 直接操作生产数据库风险极高,需为每个 agent 分配独立、可丢弃的数据库副本以保障安全。

精选视频#AI Agent#数据库安全#LLM 基准测试#仿真英文
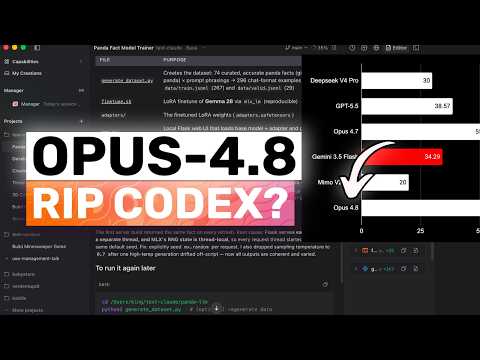
Opus 4.8(已全面测试):它真的优秀吗?

Opus 4.8(已全面测试):它真的优秀吗?

AICodeKing3777 字 (约 16 分钟)
87

Claude Opus 4.8在作者自建基准测试中得分87.14%(61/70),显著优于前代;新增Fast模式(2.5倍速、价格降为此前1/3)、高努力默认策略与X-High/max选项,并支持动态工作流与API内系统消息更新,编码诚实性提升4倍。

入选理由:Opus 4.8在70题自测基准中得61分(87.14%),高于GPT-4.5、Gemini 3.5 Flash等主流模型。

精选视频#Claude#大语言模型#Anthropic#AI编码#Benchmark英文
Claude Opus 4.8已发布:真如宣传般强大吗?

Claude Opus 4.8已发布:真如宣传般强大吗?

Lenny's Newsletter1002 字 (约 5 分钟)
87

Opus 4.8在Sweet Bench Pro测试中达69.2%,超Opus 4.7约5点、GPT-4.5约10点;但实测中仍难解决‘最后10%’问题与幻觉,定价高昂($5/k输入token)。

入选理由:Sweet Bench Pro得分69.2%,领先Opus 4.7(+5pt)、GPT-4.5(+10pt)与Gemini 3.1(+15pt)

精选文章#Claude#大语言模型#Anthropic#AI编程#基准测试英文
VSCode 团队介绍 Agent-First Development 的五大支柱

VSCode 团队介绍 Agent-First Development 的五大支柱

meng shao(@shao__meng)926 字 (约 4 分钟)
87

VSCode团队提出Agent-First Development五大支柱:模型选择、行动边界、上下文、提示精度和工具控制,强调从人+编辑器转向人+Agent+编辑器的开发范式,通过精细化配置提升AI编程效率。

入选理由:Copilot提供Low/Medium/High/Auto四档思考深度,匹配不同任务需求

精选推文#VSCode#Agent-First#Copilot#AI编程中文
SocialReasoning-Bench:衡量AI代理是否真正代表用户利益

SocialReasoning-Bench:衡量AI代理是否真正代表用户利益

Microsoft Research Blog3099 字 (约 13 分钟)
87

SocialReasoning-Bench 揭示当前主流 AI 模型在代表用户进行社交推理时,虽能完成任务但常接受次优结果,未能充分维护用户利益。

入选理由:在日程协调中,前沿模型有36%的概率接受低于最优值15%以上的会议时间。

精选文章#AI Agent#Social Reasoning#Benchmark#Microsoft Research英文
Databricks 图标

使用 MemAlign 提升 Genie Code 中传统机器学习的评估能力

Databricks2293 字 (约 10 分钟)
87

Databricks 用 MemAlign 框架优化 Genie Code 生成的 ML 代码评估,通过 LLM 判官实现 9 维度自动化评分,显著缩小与人类专家的差距。

入选理由:MemAlign 使 LLM 判官与人类评分相关性达 0.85。

精选文章#Genie Code#MLflow#MemAlign#LLM 评估#机器学习英文
你的RAG系统产生“更高流畅性的幻觉”

你的RAG系统产生“更高流畅性的幻觉”

Weaviate • vector database(@weaviate_io)245 字 (约 1 分钟)
87

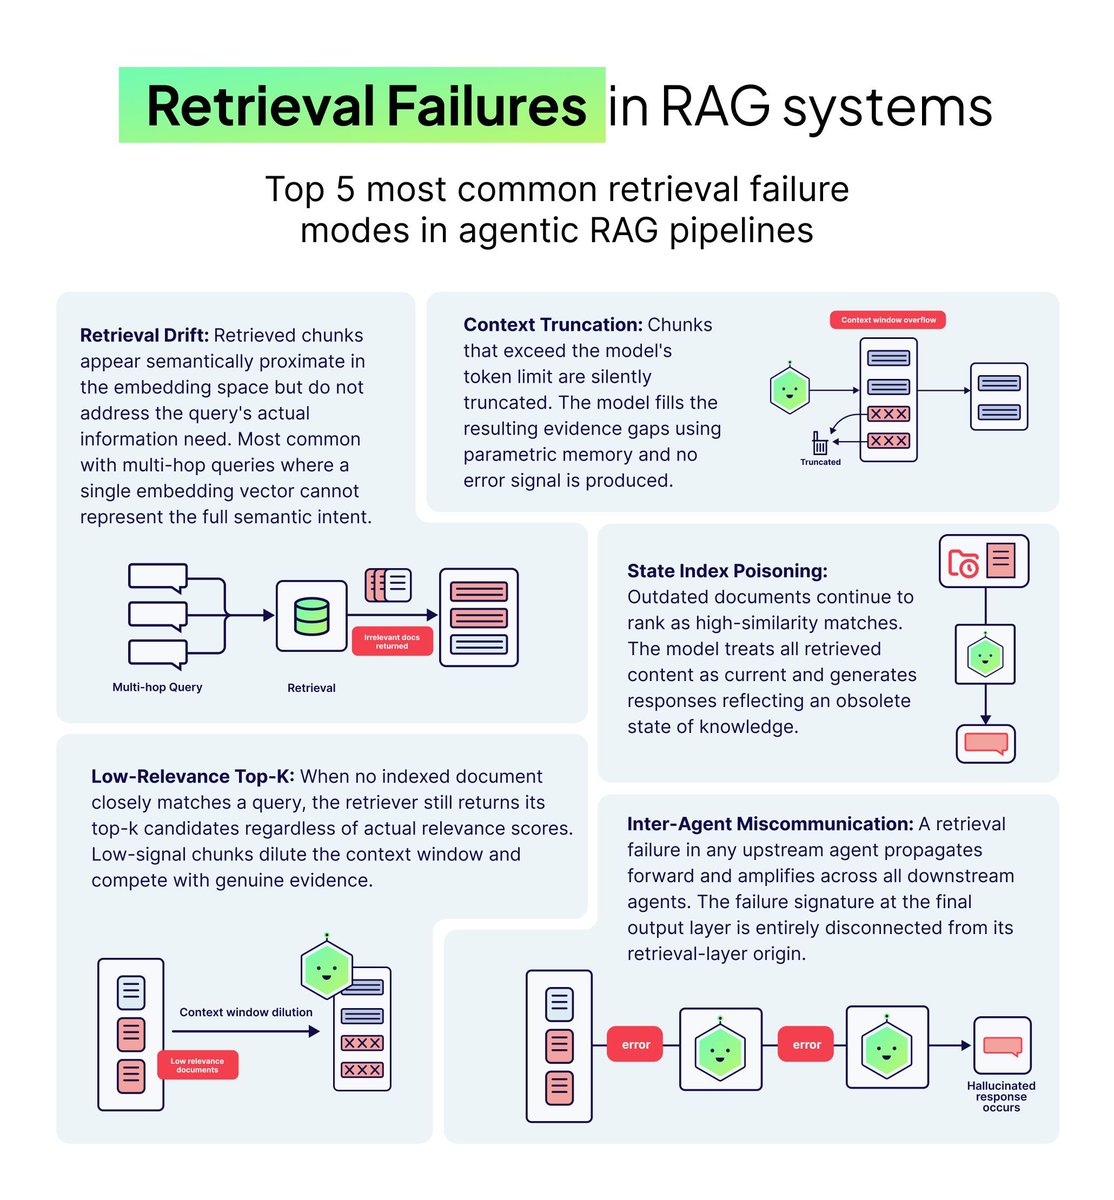
研究发现,RAG系统中检索质量差是导致高流畅性幻觉(更自信但更错误)的主因,模型升级无法弥补检索缺陷。

入选理由:检索质量差是RAG输出退化的最主要预测指标,模型能力增强反而加剧幻觉可信度。

精选推文#RAG#向量数据库#Weaviate#LLM#幻觉检测中英混合
QIMMA قِمّة ⛰: A Quality-First Arabic LLM Leaderboard

QIMMA قِمّة ⛰: A Quality-First Arabic LLM Leaderboard

Hugging Face Blog1876 字 (约 8 分钟)
87

QIMMA是首个对阿拉伯语LLM基准进行质量预验证的排行榜,揭示现有评测集普遍存在翻译失真、标注错误等问题,确保模型评分真实反映阿拉伯语能力。

入选理由:多数阿拉伯语基准未经过质量验证,存在翻译偏差和标注错误,影响评估可信度。

精选文章#LLM#阿拉伯语NLP#Benchmark#HuggingFace#AI评估英文
Inside Managed Deep Agents: mda CLI, Context Hub, and Harbor Evals | Interrupt London

LangChain的Deep Agents通过执行环境、上下文管理等机制,提升代理在生产环境的部署能力。

入选理由:Deep Agents包含执行环境、上下文管理、评估工具和安全性四个核心模块

精选视频#LangChain#Deep Agents#代理框架#生产部署英文
Cloudflare’s Auto Router Rates Each Request for Stakes, from the Most Recent Turns

Cloudflare Auto Router通过AI评估请求风险和成本,优化模型选择,提升路由效率。

入选理由:Auto Router使用四维评分(复杂度/歧义/风险/上下文依赖)和14个任务分类进行模型选择

精选文章#Cloudflare#AI路由#OpenTelemetry#模型选择英文
I spent $10,000 on tokens. It should’ve cost $100!!

I spent $10,000 on tokens. It should’ve cost $100!!

AssemblyAI293 字 (约 2 分钟)
85

通过模型选择和路由引擎优化,AI推理成本可降低90%,开源评估工具能显著节省企业开支。

入选理由:Gemma 4 31B模型处理1小时音频成本仅为$7,而Claude Sonnet需$339

精选视频#AI成本优化#模型选择#开源工具#推理效率英文
How to use Devin to automate evals from production traffic.

How to use Devin to automate evals from production traffic.

Windsurf(@windsurf_ai)100 字 (约 1 分钟)
85

Rox公司使用Devin自动化评估生产流量,覆盖72%的实际使用情况。

入选理由:Devin每周自动重建代理失败案例并生成评估套件

精选推文#Devin#自动化评估#生产流量#Rox#AI测试英文
Hacker News Best 图标

90% of US working hours are spent on tasks not covered well by AI benchmarks

Hacker News Best2565 字 (约 11 分钟)
85

现有AI基准测试仅覆盖美国劳动力市场中约10%的工作任务,90%的工作时间花费在未被充分覆盖的领域。

入选理由:Mercor研究显示,仅208个职业中的任务有5个以上基准提示,覆盖不足90%的美国工作时间。

精选文章#AI基准测试#劳动力分析#技术研究英文
Docker 图标

Harbor + Docker Sandboxes: Run Safe, Reproducible Agent Evals

Docker850 字 (约 4 分钟)
85

Harbor结合Docker Sandboxes提供安全、可重复的代理评估环境,支持本地和云部署。

入选理由:Docker Sandboxes通过微虚拟机实现强隔离,防止代码逃逸

精选文章#Docker#Harbor#微虚拟机#AI评估英文
Machine Learning Mastery 图标

Building a Custom LLM Evaluation Harness in Python from Scratch

Machine Learning Mastery1665 字 (约 7 分钟)
85

本文详解如何构建自定义LLM评估框架,包含黄金数据集、异步推理、双模式评分和日志系统,适用于精准控制模型测试场景。

入选理由:使用LiteLLM和Pydantic实现多模型后端兼容的评估框架

精选文章#Python#LLM评估#机器学习#异步处理英文
Latent Space 图标

[AINews] AI Engineer NYC: Gemini 4 Argon, Vals AI Benchmarks

Latent Space2407 字 (约 10 分钟)
85

Gemini 4 Argon已全球发布,支持代码生成等场景,定价为每百万输入/输出令牌$2/$10,内部测试显示效率提升35%。

入选理由:Gemini 4 Argon定价为$2/$10每百万输入/输出令牌(11月30日后翻倍)

精选文章#Gemini#AI模型#基准测试#定价策略英文
Production Patterns for Agents, Evals, and LLM Costs: QCon AI New York 2026

生产环境中的AI代理需平衡权限控制、评估机制与成本,InfoQ 2026年QCon会议揭示了授权模型、评估循环和提示压缩等实践方案。

入选理由:生产代理需结合长期服务账户与细粒度权限控制,避免过度授权或限制

精选文章#AI生产实践#LLM成本控制#授权模型#评估系统英文
meng shao(@shao__meng) 图标

https://t.co/qn75Cm1VFX

meng shao(@shao__meng)3430 字 (约 14 分钟)
85

Pi School 是一门免费、自定进度的开源课程,通过 Pi 本身教授如何使用 Pi Agent,强调模型无关和隐私优先的设计。

入选理由:课程分四阶段教学,从环境搭建到扩展能力,覆盖模型选择、上下文管理等核心实践。

精选推文#Pi Agent#AI 教程#开源课程#模型选择中文
Stack Overflow Blog 图标

Part 2: Evals as a deployment gate — and how to know when they drift

Stack Overflow Blog1783 字 (约 8 分钟)
85

将评估作为部署门禁可防止模型变更导致质量下降,需结合基线检测与影子评估循环,代码示例展示如何实现自动化评分系统。

入选理由:部署前必须通过评估门禁,否则等同于使用笔记本而非正式测试

精选文章#LLM#CI/CD#模型评估#部署门禁英文
Databricks 图标

The lakehouse is a better data warehouse: 2026 benchmarks and proof

Databricks2292 字 (约 10 分钟)
85

Lakehouse在2026年基准测试中表现优于传统数据仓库,性能提升77%,成本降低25-60%。

入选理由:Databricks Lakehouse相较2022年性能提升77%,BI查询速度提升14%

精选文章#数据仓库#Lakehouse#Databricks#性能基准英文
How We Benchmark ARIA—and Why It Runs on Weave

How We Benchmark ARIA—and Why It Runs on Weave

CoreWeave2786 字 (约 12 分钟)
85

CoreWeave通过Weave平台实现ARIA的生产对齐评估,确保基准测试与实际运行环境一致。

入选理由:生产环境重试成功不等于问题解决,需对比配置变更效果

精选文章#ARIA#Weave#基准测试#生产环境#CoreWeave英文

相关专题

跨材料问答 · 大模型评测、Benchmark 与生产质量监控

回答基于:大模型评测、Benchmark 与生产质量监控 专题下 30 条材料
    0 / 500

    AI 可能会生成不准确的信息,请核实重要内容