DeepSeek 的 10 万亿美元大战略
宝玉的分享5756 字 (约 24 分钟)
92
DeepSeek通过多项技术创新大幅降低大模型推理中的KV缓存需求,推动中国AI硬件生态发展,目标打造价值10万亿美元的产业巨兽。
入选理由:DeepSeek V4 Pro仅需5.48GB HBM,相比GLM5的60GB和Qwen3-235B-A22B的89GB显著节省显存
精选文章#AI模型#硬件生态#KV缓存#DeepSeek#中国AI中文
模型
也叫:通义千问
通义千问大模型
最近变化
2026-10-21 · Thomson Reuters通过持续预训练将模型性能提升至行业领先水平
Qwen 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
已收录 30 篇与「Qwen」相关的 AI 资讯和分析。
DeepSeek通过多项技术创新大幅降低大模型推理中的KV缓存需求,推动中国AI硬件生态发展,目标打造价值10万亿美元的产业巨兽。
入选理由:DeepSeek V4 Pro仅需5.48GB HBM,相比GLM5的60GB和Qwen3-235B-A22B的89GB显著节省显存
小型专用模型如 CyberSecQwen-4B 在防御性网络安全任务中表现优于大型通用模型,且支持安全本地部署,无需 API 成本。
入选理由:CyberSecQwen-4B 在 CTI-MCQ 测试中以 0.5868 准确率超越 Cisco 8B 模型 8.7 个百分点。
Garry Tan 认为AI正开启下一次个人计算革命,开源Agent与个人AI将赋予普通人前所未有的创造能力;YC核心信条是‘做出人们想要的东西’;创业者需以真诚感知力与主观能动性将创伤转化为创造力。
入选理由:Garry Tan 提出‘个人AI必须由自己拥有和控制’,并正在开发 G Brain——整合邮件、日历、联系人与笔记的个人知识记忆系统。
模型工厂的定制化流程比模型本身更重要,持续预训练和后训练能显著提升特定任务表现。
入选理由:Thomson Reuters通过持续预训练将模型性能提升至行业领先水平
企业自研模型时,持续预训练和模型工厂构建比单一模型优化更重要。多家企业通过混合训练策略实现领域知识深度适配。
入选理由:持续预训练使模型领域知识提升3倍(C3 AI案例中从11%到60%)
Amazon SageMaker JumpStart 2026 年新增超 100 个模型,覆盖 30 家供应商,显著扩展其模型库。
入选理由:2026 年 SageMaker JumpStart 新增 100+ 模型,来自 30 家供应商。
欧洲在Hugging Face Hub上衍生模型最多的是FLUX.1-dev,而非Llama或Qwen,显示其AI生态活跃度。
入选理由:FLUX.1-dev模型拥有43,000个衍生模型,是Hugging Face Hub上最被使用的模型。
IBM Granite Switch 4.1通过集成决策适配器和语音模型,实现多任务处理,提升效率。
入选理由:Granite-Switch-4.1-30B在5步RAG流程中比Jev-27B快3倍
通过优化内核和数据管道,Databricks将Qwen 27B模型微调训练时间从7小时44分钟缩短至1小时17分钟,提升6倍。
入选理由:使用FSDP2和激活检查点技术可提升大模型训练效率
本文推荐了5个LLM推理工程实践项目,涵盖KV缓存、量化、注意力优化等关键技术,适合工程师通过动手学习提升系统性能。
入选理由:构建Mini-vLLM项目可掌握KV缓存和连续批处理机制
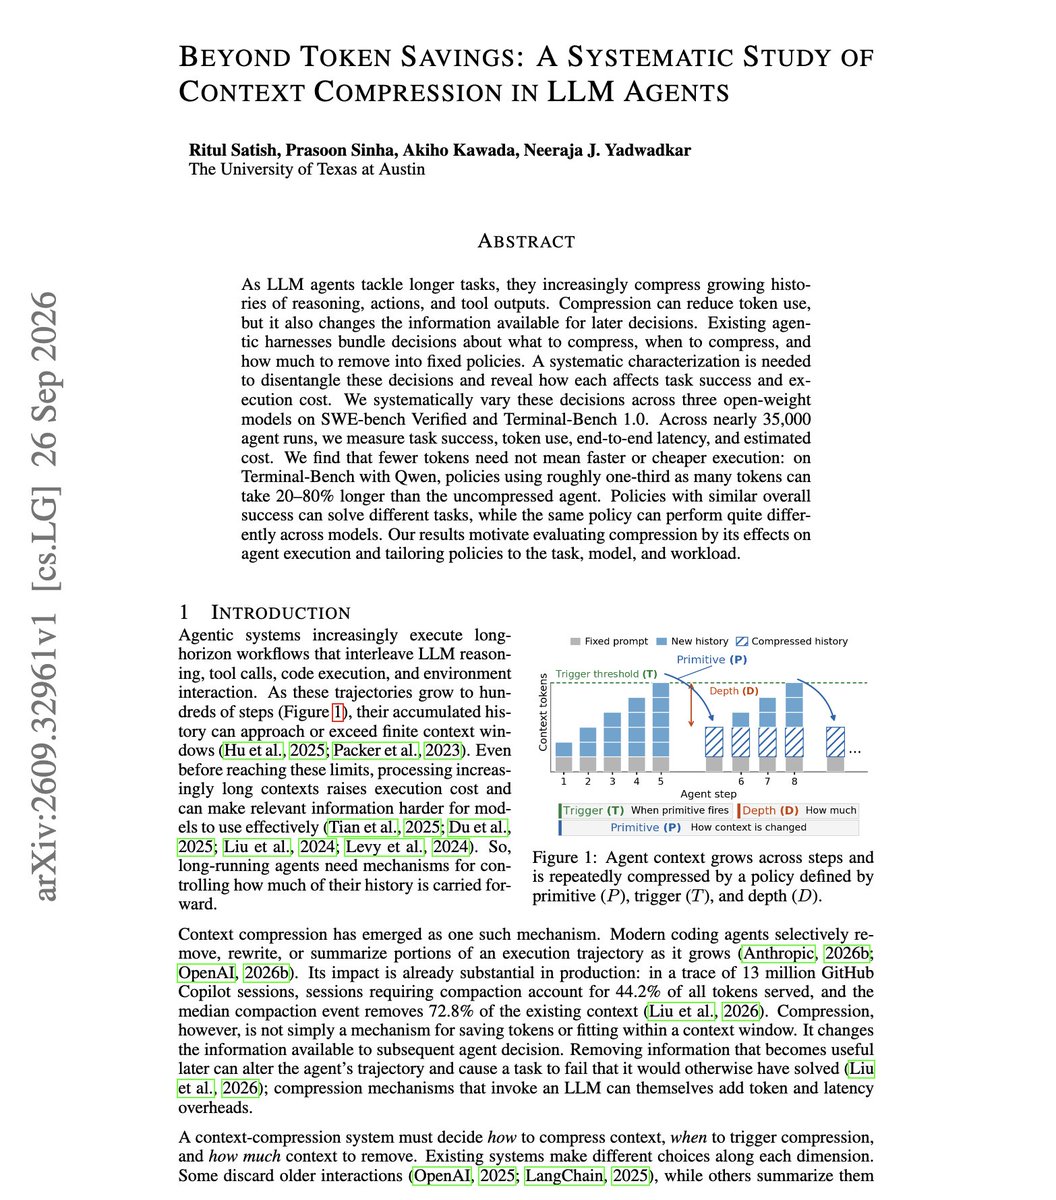
上下文压缩策略可能显著影响LLM代理性能,某些策略虽减少token却导致运行时间增加。
入选理由:使用约三分之一token的策略可能使Qwen变慢20%-80%
Holo4模型在保持低成本的同时实现接近前沿模型的性能,支持多接口交互并开源轨迹数据。
入选理由:Holo4-27B在OSWorld 2.0基准得分61.7%,仅比Opus 5.5低19.1个百分点
配置优化对本地LLM服务器性能影响显著,不同平台的设置可带来最高63%的性能提升。
入选理由:启用CUDA graphs可使L40S解码速度提升16.8%(0.8B模型)
Qwen-Image-2.1 是阿里巴巴推出的 7B 参数图像生成与编辑模型,支持在 Hugging Face Spaces 上无需设置的在线演示。
入选理由:Qwen-Image-2.1 支持最多 10 张图像参考,集成 diffusers 和 ComfyUI
Harness Arena通过实际任务执行结果比较AI代理工具,帮助用户评估不同harness的性能差异。
入选理由:Harness Arena使用相同任务和模型配置测试不同代理工具
Agent harnesses通过增强AI模型的持续执行和规则管理,成为GPT包装器的下一代解决方案。
入选理由:Agent harness可兼容GPT、Claude、Google Gemma等多模型,实现模型解耦
开源模型许可证呈现两极分化趋势,西方厂商转向Apache 2.0,中国头部厂商设置商业使用门槛。
入选理由:Google和Meta已全面采用Apache 2.0许可证
E-Commerce Bench 是阿里巴巴推出的全新基准,用于评估长期自主电商运营的智能体,涵盖真实经济因素和多维评估体系。
入选理由:E-Commerce Bench 包含 6886 个产品和 576 个供应商,模拟真实电商环境。
FactoryAI通过微调Qwen模型,使Droid Shield在代码审查中比GPT-5.5多捕捉20%的真实秘密,同时降低成本和延迟。
入选理由:使用Training API微调Qwen模型可提升20%的敏感信息检测率
Fireworks AI通过微调Qwen模型帮助LangChain实现评估成本降低100倍,替代GPT-5.5等闭源模型。
入选理由:微调Qwen模型可替代GPT-5.5实现100倍成本降低
中国开源模型正成为西方AI公司的重要依赖,但这也带来结构性风险。Qwen市场份额激增,蒸馏技术加剧中美模型差距。
入选理由:Qwen在2024年1月至2026年2月间占据69%的开源模型微调市场份额
NVIDIA推出的NeMo Tron 3.5 Lightning模型专为代理执行层优化,实现4倍吞吐量,显著降低推理成本。
入选理由:NeMo Tron 3.5 Lightning是NVIDIA推出的30B参数MoE模型,专为执行层任务设计
通义千问推出Qwen3.8-Flash模型,开放权重并提供API服务,参数达125B,输入输出价格分别为0.16和0.47美元/百万令牌。
入选理由:Qwen3.8-Flash参数规模达125B,N-gram达51B,支持多模态任务
前沿AI实验室通过状态持久性和专有执行环境构建开发者锁定,影响开放系统开发。
入选理由:OpenAI GPT-5.6 Sol通过状态持久性使ARC-AGI-3得分提升3倍
真正的AI护城河在于数据、工程和基础设施,而非架构创新。卡内基梅隆大学教授Russ Salakhutdinov预测AGI短期内难以实现,模型竞争将转向产品化,预测系统可能取代传统咨询。
入选理由:AGI短期内无法实现,核心突破在数据和工程而非架构
中国开源模型已占据西方AI公司训练栈核心位置,蒸馏技术加剧中美模型能力差距,西方需独立构建或接受滞后学习。
入选理由:Qwen在2024-2026年占据69%西方公司模型微调市场份额
本地运行AI模型在隐私、成本、离线和所有权方面具有显著优势,且Qwen在测试中表现突出。
入选理由:本地模型无需云端依赖,数据完全私有且无使用成本。
提示工程和上下文工程能显著提升AI代理性能,通过优化输入和上下文信息。
入选理由:使用LangChain v1和Ollama可本地运行AI代理,避免API成本
Qwen-Image-3.0通过‘Real’三大维度提升图像生成能力,支持复杂布局、高精度细节及多语言艺术风格,适用于设计、教育等多领域。
入选理由:支持4.5k token提示词,可生成报纸、故事板等复杂布局
Ramp Router通过动态模型路由显著降低AI成本,成为LLM堆栈核心组件。
入选理由:模型路由可降低30%以上推理成本
与「Qwen」经常一起出现的 AI 术语。
💡 想追踪「Qwen」的长期趋势?去 实体雷达 · Qwen 查看详细分析和跨材料问答。