科技爱好者周刊(第 399 期):中国 AI 大厂访问记
阮一峰的网络日志4694 字 (约 19 分钟)
92
美国分析师访华报告揭示中国AI算力虽仅为美国八分之一,但通过4-7倍计算效率提升弥补了硬件差距。
入选理由:2025年底美国AI算力约为中国8倍,中国当前总算力仅相当于美国2023年水平。
精选文章#AI基础设施#算力效率#大模型开源#中美AI对比中文
公司
也叫:DeepSeek公司
提供AI模型补偿的公司,可能涉及商业合作。
最近变化
2026-10-21 · 攻击者主要使用Anthropic Claude和Deepseek模型的旧版本实施攻击
DeepSeek 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
已收录 30 篇与「DeepSeek」相关的 AI 资讯和分析。
美国分析师访华报告揭示中国AI算力虽仅为美国八分之一,但通过4-7倍计算效率提升弥补了硬件差距。
入选理由:2025年底美国AI算力约为中国8倍,中国当前总算力仅相当于美国2023年水平。
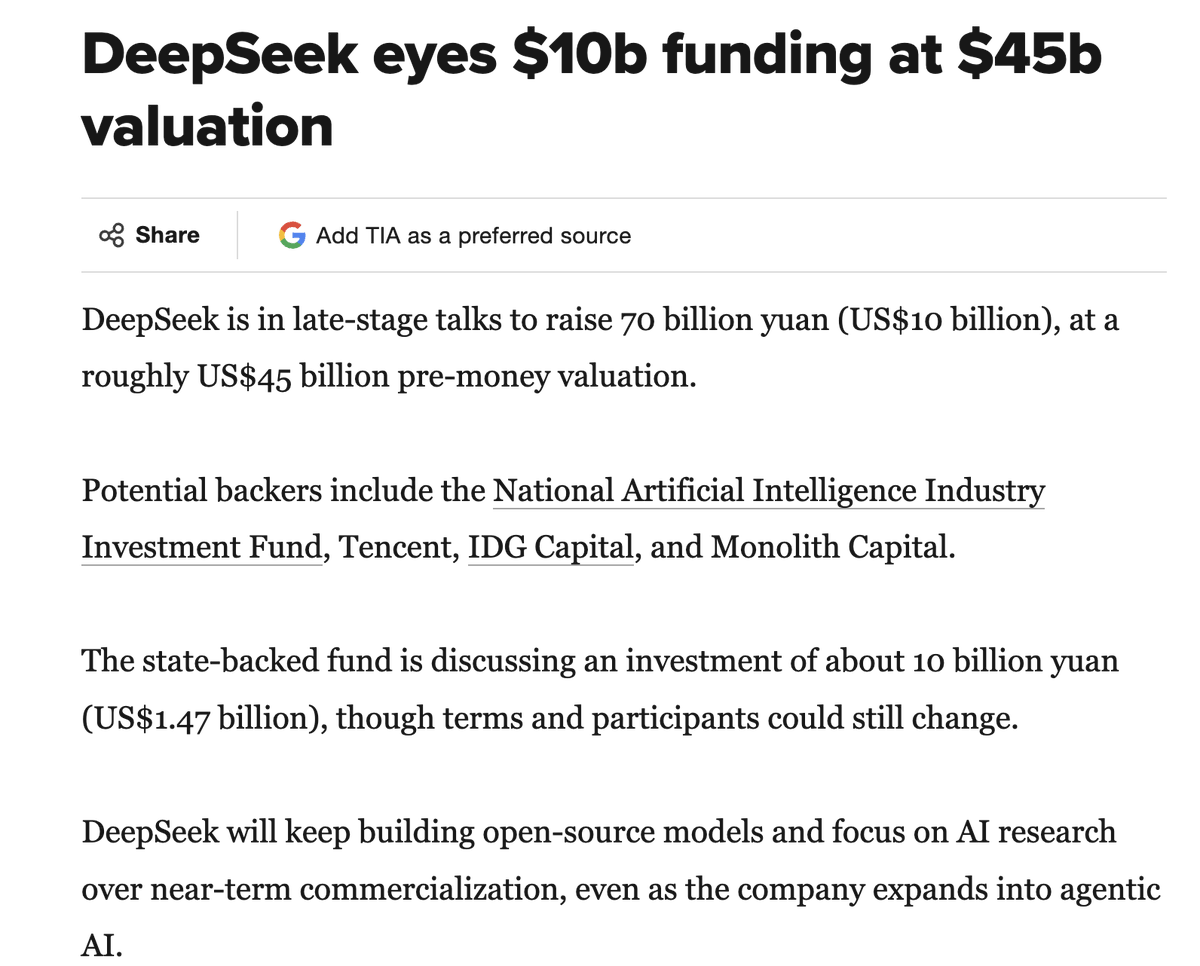
DeepSeek通过多项底层技术创新构建低成本高效能模型体系,旨在撬动中国10万亿美元AI硬件生态并实现自身万亿美元市值。
入选理由:DeepSeek V4 Pro在100万上下文中仅需5.48GB HBM显存,远低于竞品的60-89GB。
DeepSeek通过多项技术创新大幅降低大模型推理中的KV缓存需求,推动中国AI硬件生态发展,目标打造价值10万亿美元的产业巨兽。
入选理由:DeepSeek V4 Pro仅需5.48GB HBM,相比GLM5的60GB和Qwen3-235B-A22B的89GB显著节省显存
AI基础设施正经历资本主义史上前所未有的系统性重构,电力与晶圆成为核心瓶颈,Anthropic单月新增110亿美元ARR揭示算力需求爆炸,而TSMC、NVIDIA与SpaceX等实体正在重塑全球算力地缘格局。
入选理由:Anthropic单月ARR增长110亿美元,远超市场预期,证明AI基础设施需求远超资本定价能力。
Axiom Math以Verified AI为核心,通过形式化证明与Lean工具将“ brilliance”规模化与复利化,已在Putnam达全对并在Verina Codegen取得99%,显著高于OpenAI o3的4.9%,为AGI路径提供关键能力验证与知识传播范式。
入选理由:Axiom在Putnam考试中取得12/12,优于顶尖本科生与当时最接近的AI系统DeepSeek(103/120)。
Garry Tan 认为AI正开启下一次个人计算革命,开源Agent与个人AI将赋予普通人前所未有的创造能力;YC核心信条是‘做出人们想要的东西’;创业者需以真诚感知力与主观能动性将创伤转化为创造力。
入选理由:Garry Tan 提出‘个人AI必须由自己拥有和控制’,并正在开发 G Brain——整合邮件、日历、联系人与笔记的个人知识记忆系统。
DeepSeek 的视觉指针机制让开源模型用 90% 更少视觉 token 在 7 项基准追平或超越 GPT-4V,同时提供可回溯的可解释推理路径。
入选理由:视觉指针机制将视觉 token 用量压缩 90%,仍保持 SOTA 精度
黑客利用AI工具绕过安全防护,使用Anthropic Claude等模型实施长期自动化攻击,暴露AI防御体系重大漏洞。
入选理由:攻击者主要使用Anthropic Claude和Deepseek模型的旧版本实施攻击
中美AI监管政策加速,DeepSeek发布高效推理工具DeepInfer,影响开源模型生态。
入选理由:DeepSeek的DeepInfer推理工具可能使模型价格下降30%以上
截至2023年底,Meta、NVIDIA等30多个实验室在Hugging Face Hub共享了近10亿美元的AI训练计算资源,远超维基百科的志愿者工时。
入选理由:Hugging Face Hub上共享的AI训练计算资源在2023年底已达近10亿美元,是维基百科志愿者工时的25倍。
DeepSeek-V4.1-Flash-1017模型已在Ollama平台上线,提供美国托管和零数据保留服务,优化代理任务性能并降低成本。
入选理由:DeepSeek-V4.1-Flash-1017模型在代理任务上表现优于前代,且每任务成本降低。
DeepSeek-V4.1-Flash-1017模型在Terminal-Bench 4.0和DeepSWE基准测试中表现显著提升,同时优化了任务完成速度和输出效率。
入选理由:Terminal-Bench 4.0得分从31.2提升至42.3,性能提升35.5%
DeepSeek-V4.1-Flash-1017模型在性能、速度和输出效率上实现帕累托改进,已部署至官网、APP和API接口。
入选理由:DeepSeek-V4.1-Flash-1017模型输出长度缩短23%且推理速度提升18%
DeepSeek 推出自研搜索 API,支持多语言及 SEO 优化,日均处理数亿次查询。
入选理由:DeepSeek 搜索 API 日均处理数亿次查询,支持多语言检索
DeepSeek Bot通过DSH插件实现多Bot管理与持久化记忆,适合开发者快速部署。
入选理由:DSH插件支持Bot持久化记忆与团队协作管理
DeepSeek通过减少缓存大小和提升计算效率,显著优化了模型性能。
入选理由:DeepSeek模型缓存大小降至890字节/标记,比V1版本缩小437倍
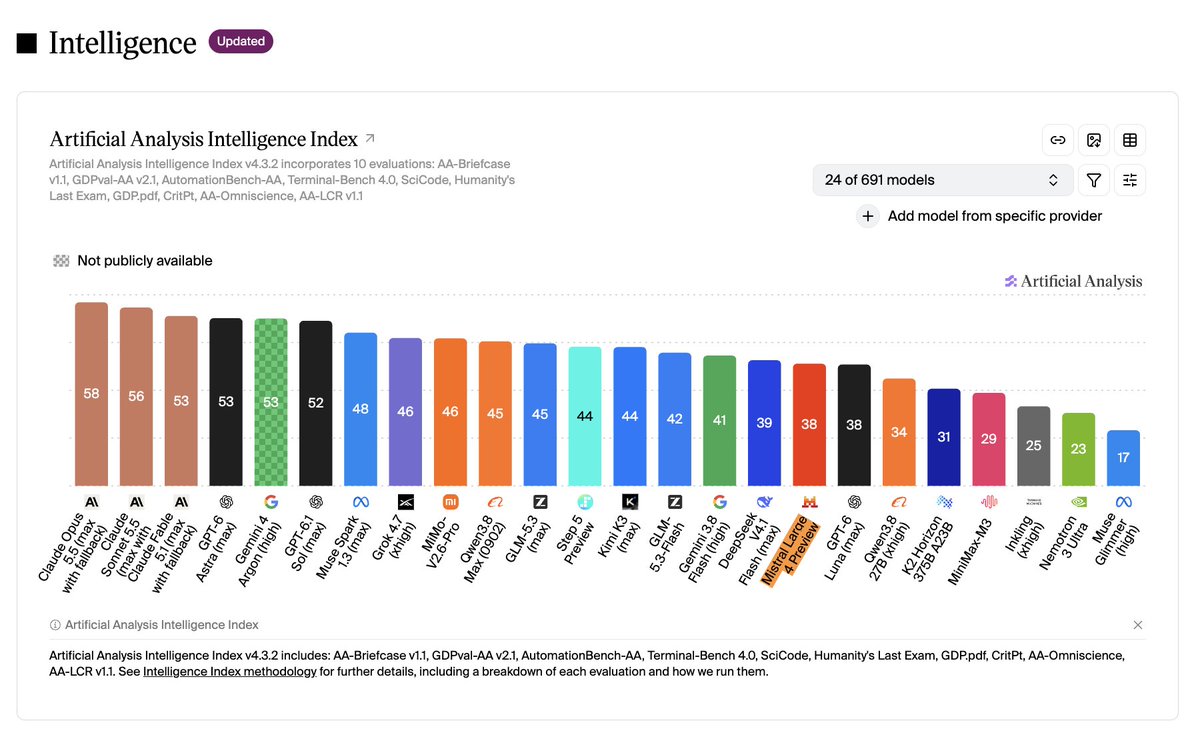
Mistral AI的Mistral Large 4模型在综合基准测试中排名38,接近中国顶尖开源模型,且在关键领域表现优于美国模型。
入选理由:Mistral Large 4拥有1T参数和多模态能力,是欧美最佳开源模型
DeepSeek通过DSec基础设施优化沙盒环境,实现资源利用率提升50倍以上,支撑百万级Agent并发训练。
入选理由:镜像分层策略使磁盘写入量减少57%,构建时间缩短1.71倍
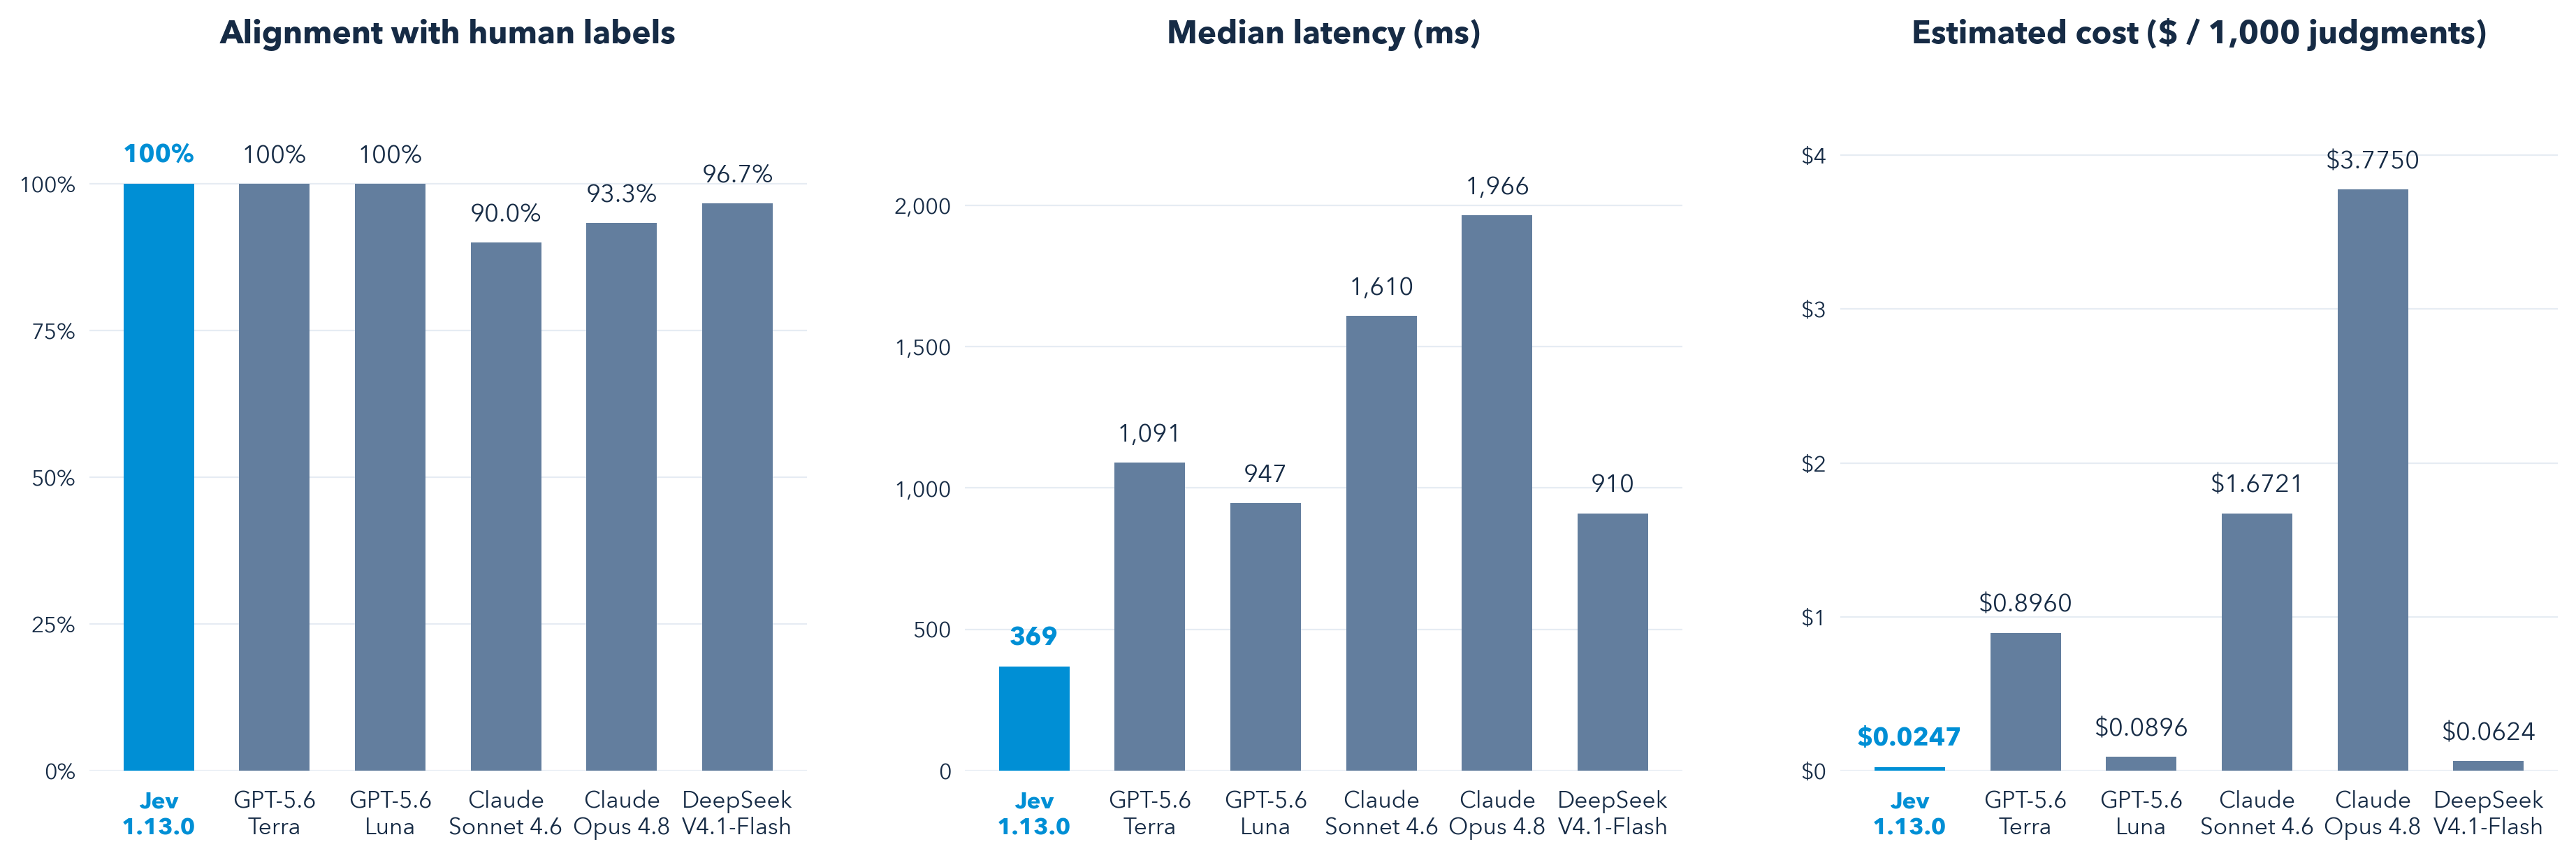
Jev通过结构化输出实现更低延迟和成本,但无法替代LLM judge的解释能力,在技术问答评估中表现优异。
入选理由:Jev的结构化输出使成本降至$0.042/百万输入token,比传统LLM低50%以上
DeepSeek Harness桌面版通过本地化安装和插件系统,将AI助手转变为可自动化办公的生产力工具,支持文档处理、定时任务和自定义插件开发。
入选理由:DeepSeek Harness桌面版支持Office/PDF文件处理,处理速度达300 tok/s
同时运行多个harnesses是当前agent工作的核心技能,结合不同模型可显著提升效率和质量。
入选理由:Claude Code适合发送计划至Codex和GPT-6 Astra进行审核
Agent harnesses通过增强AI模型的持续执行和规则管理,成为GPT包装器的下一代解决方案。
入选理由:Agent harness可兼容GPT、Claude、Google Gemma等多模型,实现模型解耦
DeepSeek推出新型非对称架构,通过参数优化和训练方法提升模型性能,参数规模达552B。
入选理由:采用552B参数的MoE架构,输入输出参数比为1:2(8B/16B)
DeepSeek的V4.1-Flash通过减少KV缓存的存储需求,显著降低运营成本。
入选理由:V4.1-Flash的KV缓存仅需上一代1/4的HBM和1/8的SSD存储
DeepSeek推出可自我扩展的AI系统,通过动态重写程序实现功能定制,但缺乏详细技术原理说明。
入选理由:自扩展AI系统可通过用户指令动态生成功能模块
DeepSeek V4 Pro 0813发布,但其开源评估工具DeepSeek Harness更具价值,允许开发者重现性能并自定义工具。
入选理由:DeepSeek Harness可记录工具调用、系统提示和子代理计划,实现性能复现
DeepSeek发布新模型DeepSeek Coder引发行业关注,OpenAI因安全风险暂停训练,Claude代码泄露事件被深度分析。
入选理由:DeepSeek Coder成为GitHub最快获得星标的历史性项目
DeepSeek发布实验性多模态模型V4-Flash-Vision-Exp,性能接近Opus-4.8。
入选理由:V4-Flash-Vision-Exp在多模态代理基准上超越V4-Flash,接近Opus-4.8性能
DeepSeek推出支持多模态的API,允许通过图像和文本混合输入进行交互,适用于需要视觉和文本处理的应用场景。
入选理由:DeepSeek的'deepseek-v4-flash-vision-exp'模型支持图像和文本混合输入,每个图像最多384个token计费。
DSpark推测解码通过结合并行和顺序组件,可提升LLM生成速度60-85%。
入选理由:DSpark结合并行与顺序组件,提升生成速度达60-85%
与「DeepSeek」经常一起出现的 AI 术语。
💡 想追踪「DeepSeek」的长期趋势?去 实体雷达 · DeepSeek 查看详细分析和跨材料问答。