从高拟真到真可用,LongCat-Video-Avatar 1.5 正式开源
美团技术团队2226 字 (约 9 分钟)
92
LongCat-Video-Avatar 1.5 开源版本在唇形同步、物理合理性、长视频稳定性等方面实现显著提升,支持复杂商业场景下的高质量数字人视频生成。
入选理由:采用 Whisper-large 编码器,提升唇形同步与动作稳定性。
精选文章#数字人#视频生成#AI模型#开源项目#美团中文
概念
也叫:Gradient-based Policy Optimization
均匀分配token advantage的基线方法
最近变化
2026-10-02 · ProVer在Qwen3.5-2B上实现9.91%性能提升,4B模型提升7.12%
GRPO 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
已收录 12 篇与「GRPO」相关的 AI 资讯和分析。
LongCat-Video-Avatar 1.5 开源版本在唇形同步、物理合理性、长视频稳定性等方面实现显著提升,支持复杂商业场景下的高质量数字人视频生成。
入选理由:采用 Whisper-large 编码器,提升唇形同步与动作稳定性。
DeepSeek通过多项底层技术创新构建低成本高效能模型体系,旨在撬动中国10万亿美元AI硬件生态并实现自身万亿美元市值。
入选理由:DeepSeek V4 Pro在100万上下文中仅需5.48GB HBM显存,远低于竞品的60-89GB。
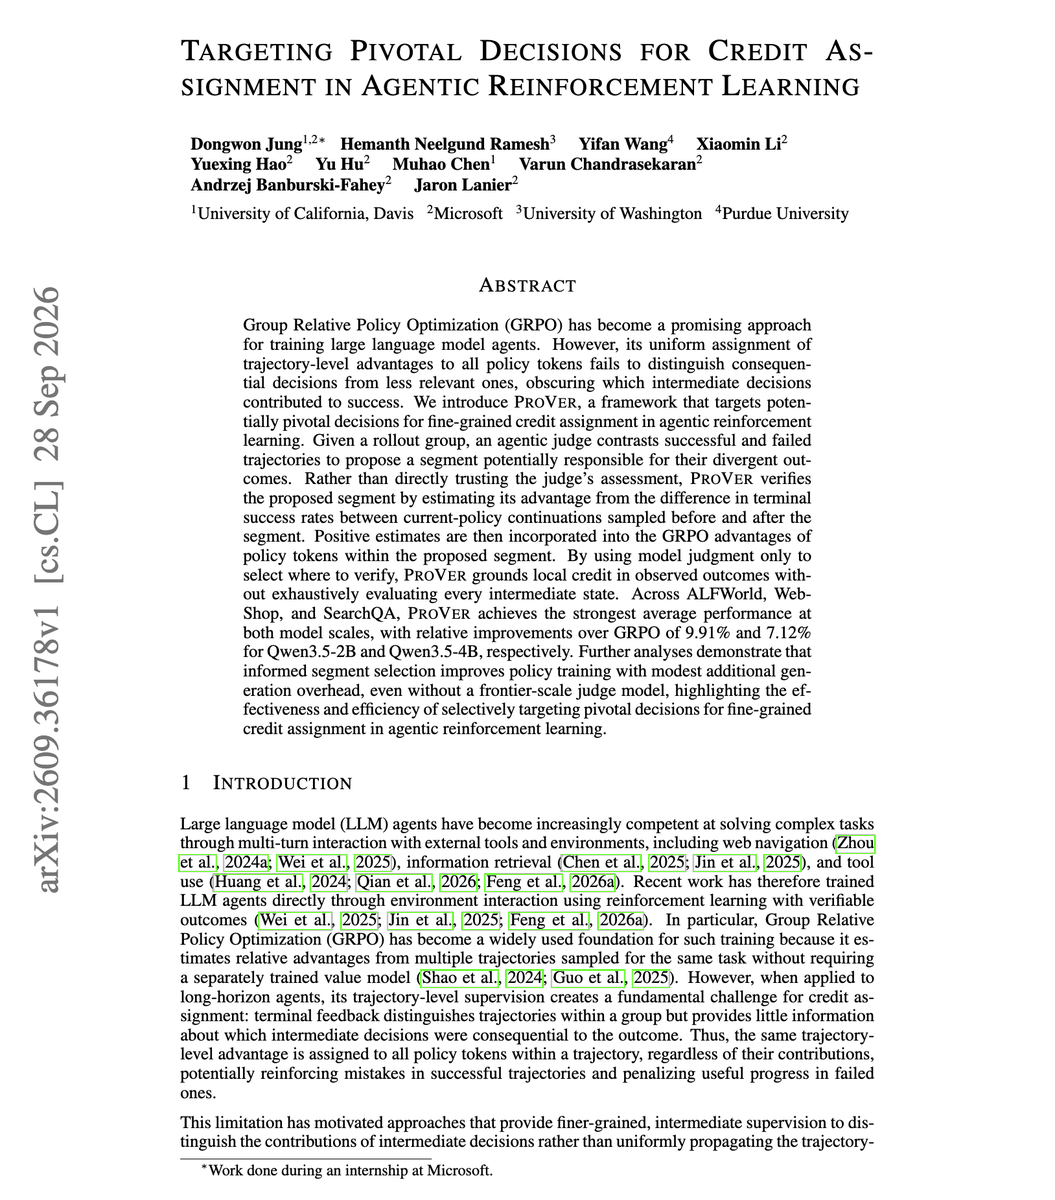
ProVer方法通过LLM法官和rollouts动态分配信用,显著提升强化学习模型性能。
入选理由:ProVer在Qwen3.5-2B上实现9.91%性能提升,4B模型提升7.12%
腾讯在LLM强化学习中通过调整批处理大小和学习率,显著提升训练效率。PPO吞吐量提升2.29倍,GRPO验证时间减少29%。
入选理由:学习率重调可在批处理规模变化时保持学习效果稳定性
腾讯在LLM强化学习中通过调整批处理大小和学习率,显著提升训练效率,节省29%时间。
入选理由:学习率调整可保持学习效果,批处理范围扩大2.29倍
Google利用Tunix和Cloud TPUs实现LLM微调的自主研究循环,显著提升效率。
入选理由:AI代理可自动优化LoRA参数和学习率调度,减少人工干预
Salesforce推出的Koa模型在CRM任务中表现接近 Claude Opus,通过结构化流程描述构建RL环境可提升企业模型训练效果。
入选理由:Koa在Tau2Bench得分69.41,超越其基座模型68.64分
使用GRPO方法微调350M模型可在100步内提升IFStruct基准性能至29.7%。
入选理由:GRPO微调使350M模型在IFStruct基准上提升7.1个百分点(22.6%→29.7%)
ClawGym II通过混合harness训练提升RL代理性能,Qwen3-30A3B在Pass@1上提升显著。
入选理由:混合harness训练使模型在200-400优化步中保持稳定性能提升
英伟达推出开源框架 Polar,显著提升 Codex 等智能体的性能和效率。
入选理由:Polar 框架让 Codex 在 SWE-Bench Verified 测试中的 pass@1 分数提升了 594.74%。
SFT可能在训练多模态大模型时引入分布偏差,导致RL阶段性能下降。PRISM通过三阶段流水线修复这一问题。
入选理由:SFT可能导致模型性能下降,如Qwen3-VL-8B SFT后准确率下降5.2%
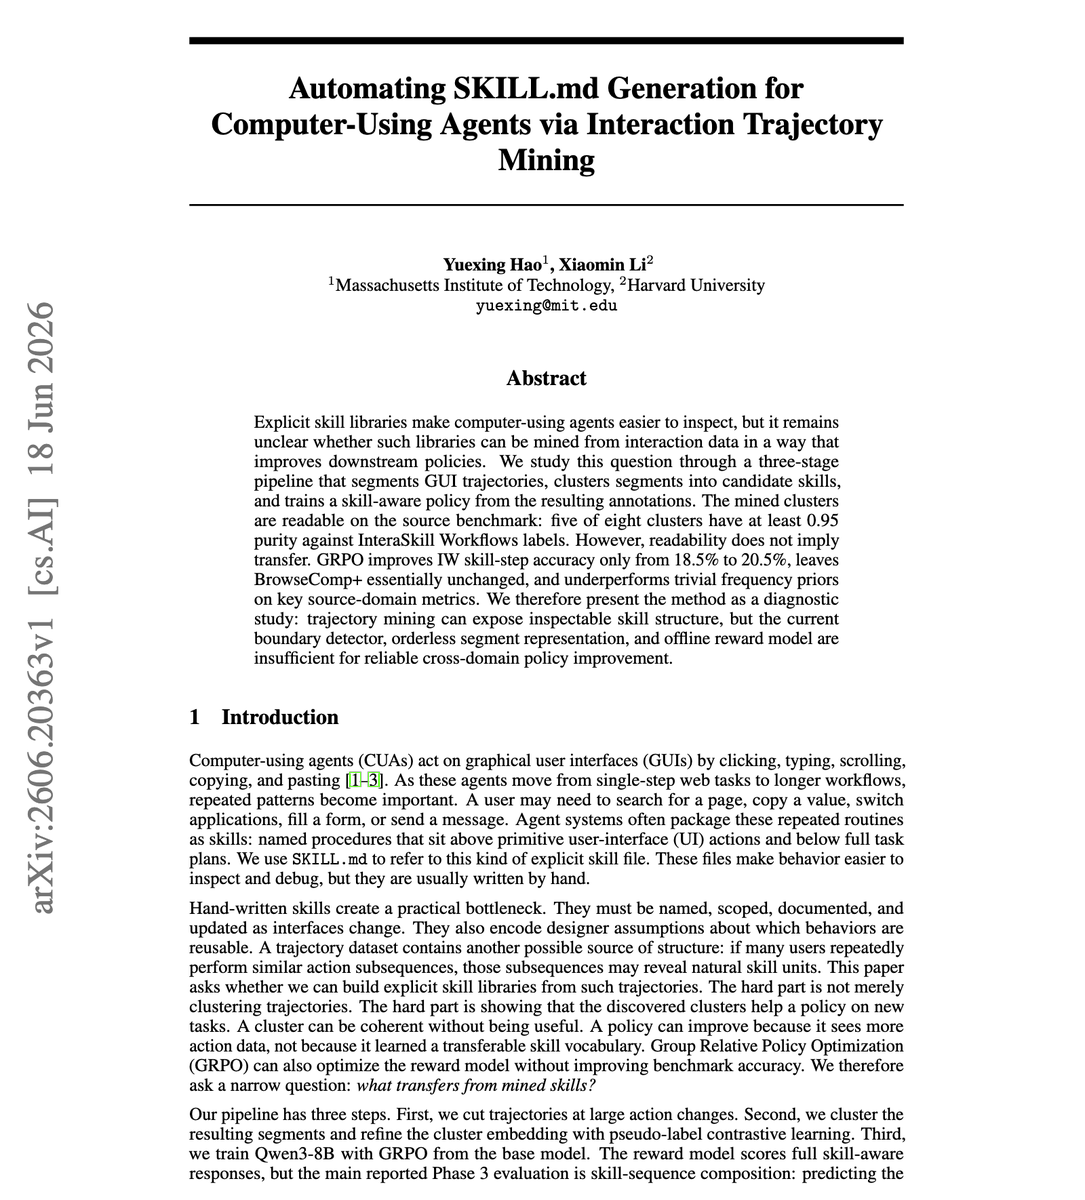
文章介绍了一种通过挖掘会话数据自动生成SKILL.md的方法,但实际效果有限。
入选理由:OpenAI 的 Codex 能够从交互中打包技能,但效果有限。
与「GRPO」经常一起出现的 AI 术语。
💡 想追踪「GRPO」的长期趋势?去 实体雷达 · GRPO 查看详细分析和跨材料问答。