Accelerating PyTorch on AMD GPUs with FlyDSL
PyTorch Blog4733 字 (约 19 分钟)
85
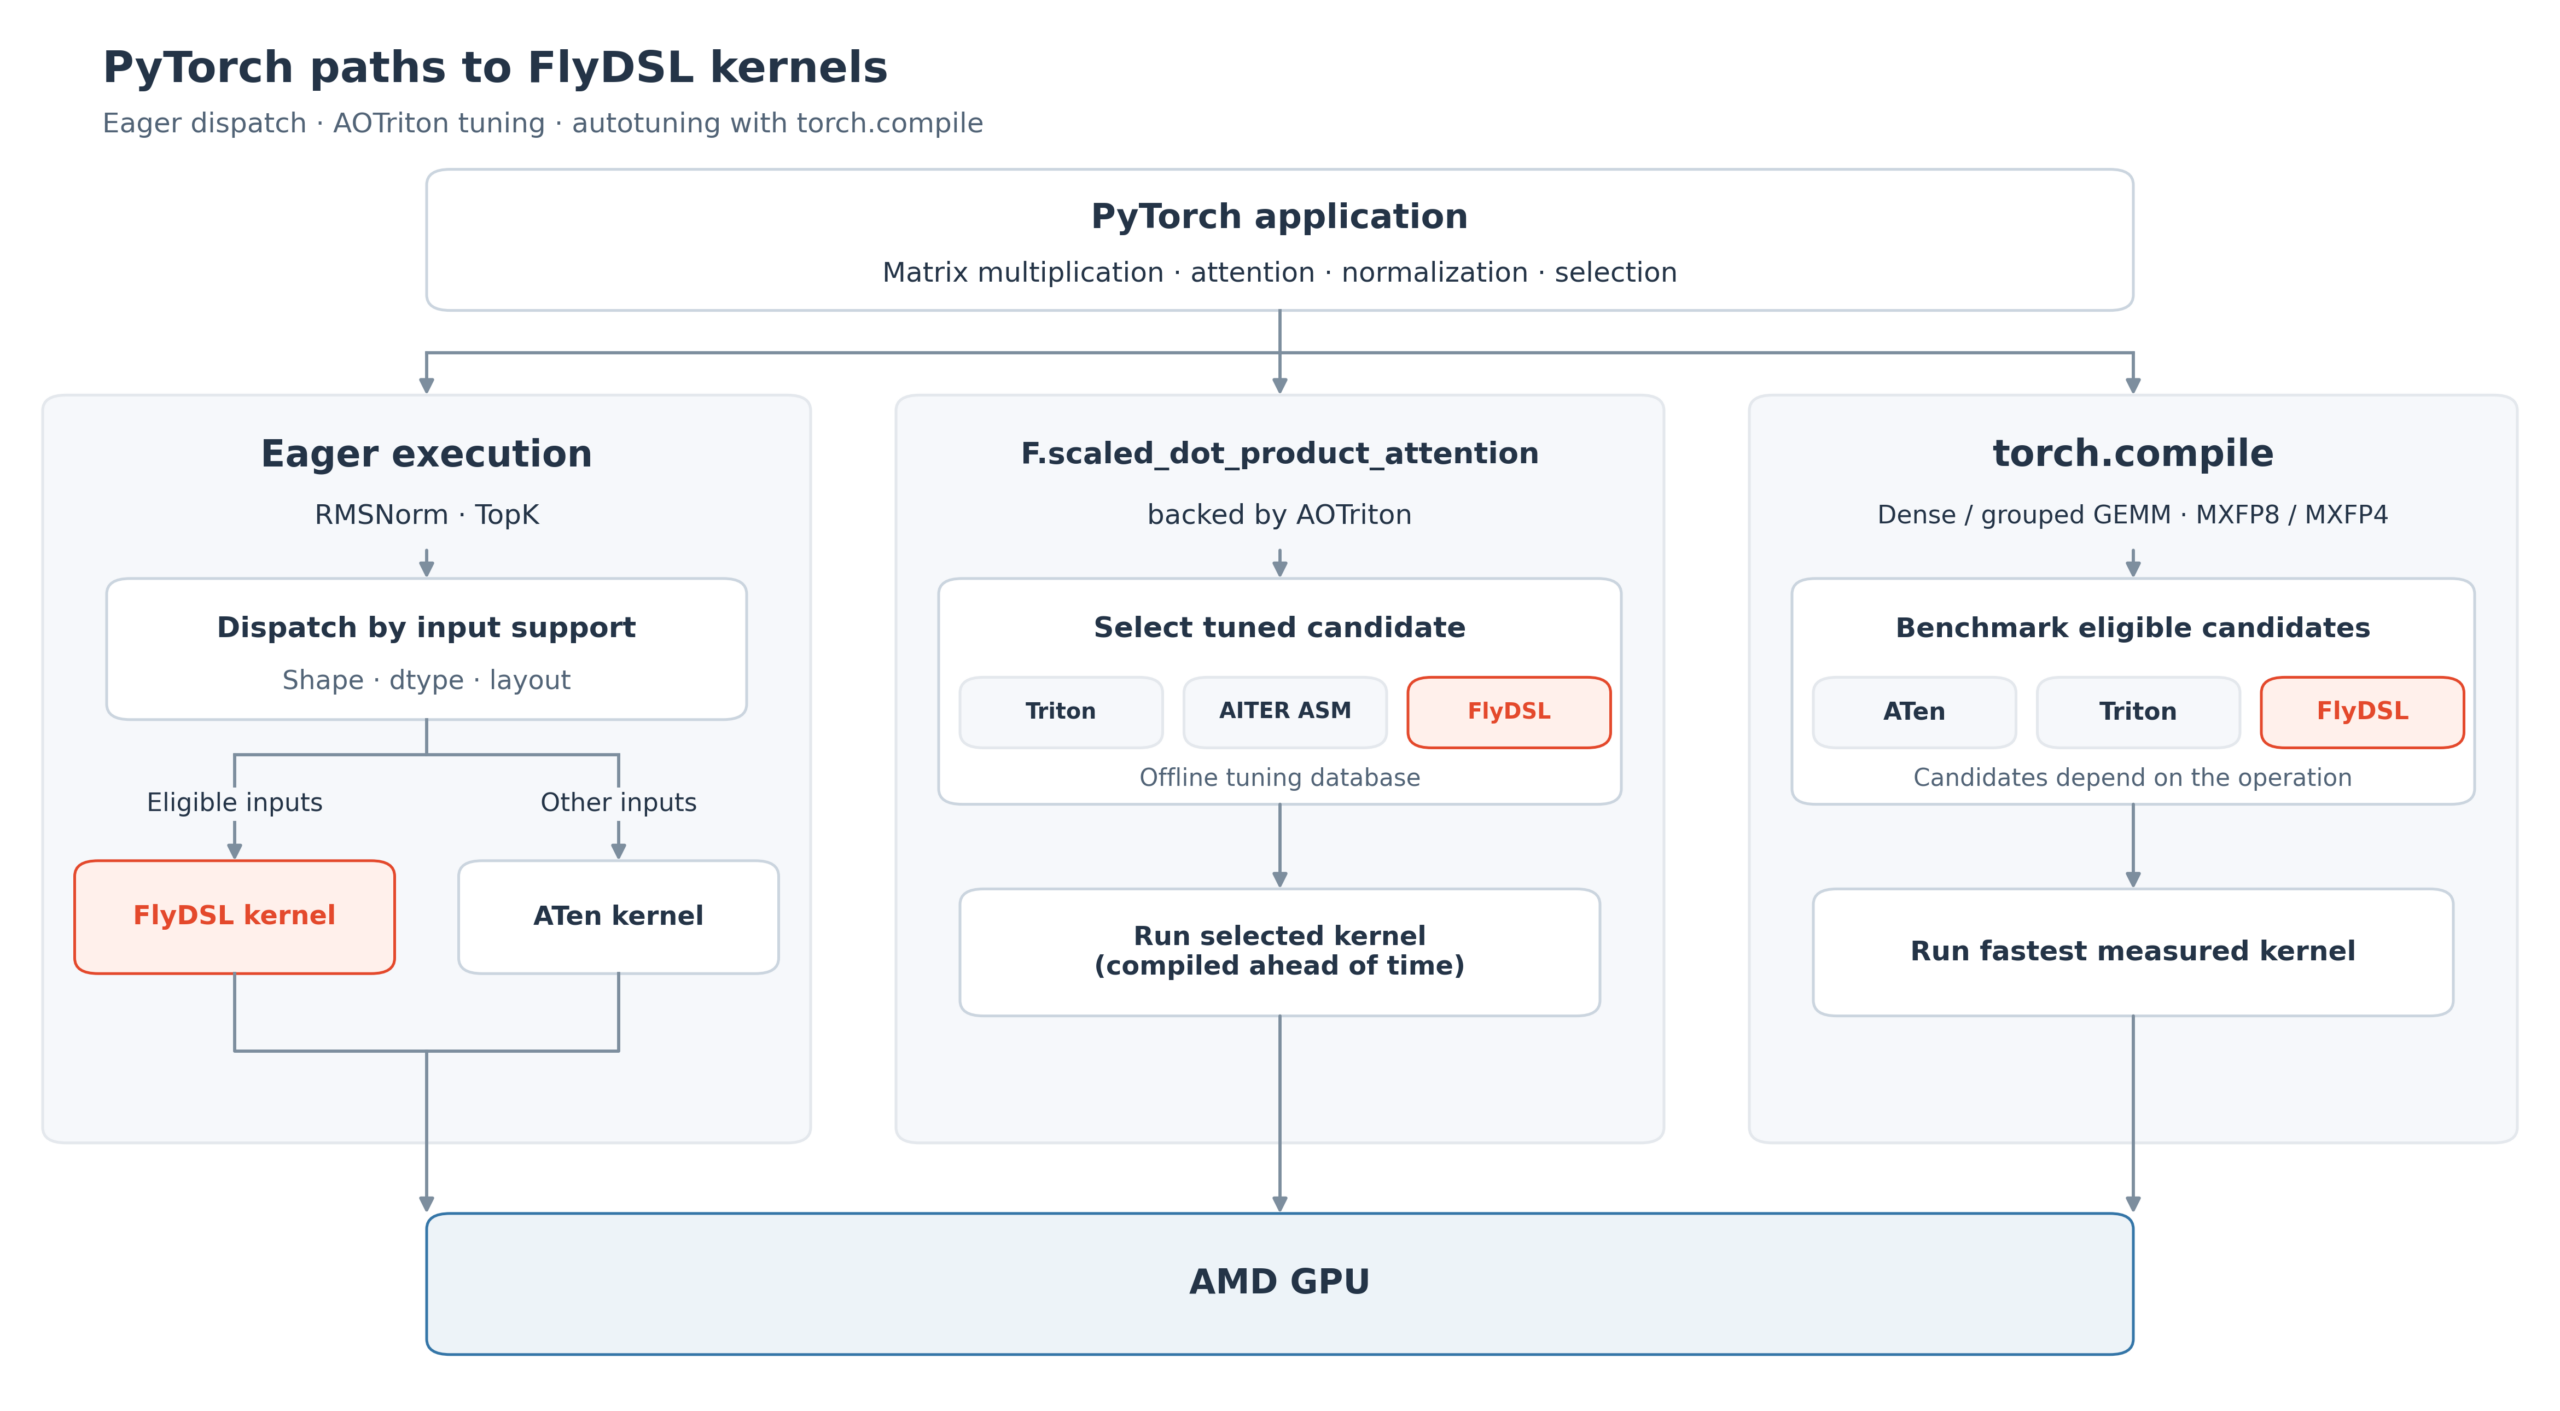
FlyDSL通过显式硬件映射控制,使PyTorch在AMD GPU上实现最高3.66x加速,特别适用于大模型训练场景。
入选理由:FlyDSL在MXFP4格式下实现1.68x几何均值加速,优于ATen基准
精选文章#PyTorch#AMD GPU#FlyDSL#性能优化#深度学习框架英文
概念
混合超低精度训练格式,用于推荐工作负载优化
最近变化
2026-10-21 · FlyDSL在MXFP4格式下实现1.68x几何均值加速,优于ATen基准
MXFP8 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
已收录 2 篇与「MXFP8」相关的 AI 资讯和分析。
FlyDSL通过显式硬件映射控制,使PyTorch在AMD GPU上实现最高3.66x加速,特别适用于大模型训练场景。
入选理由:FlyDSL在MXFP4格式下实现1.68x几何均值加速,优于ATen基准
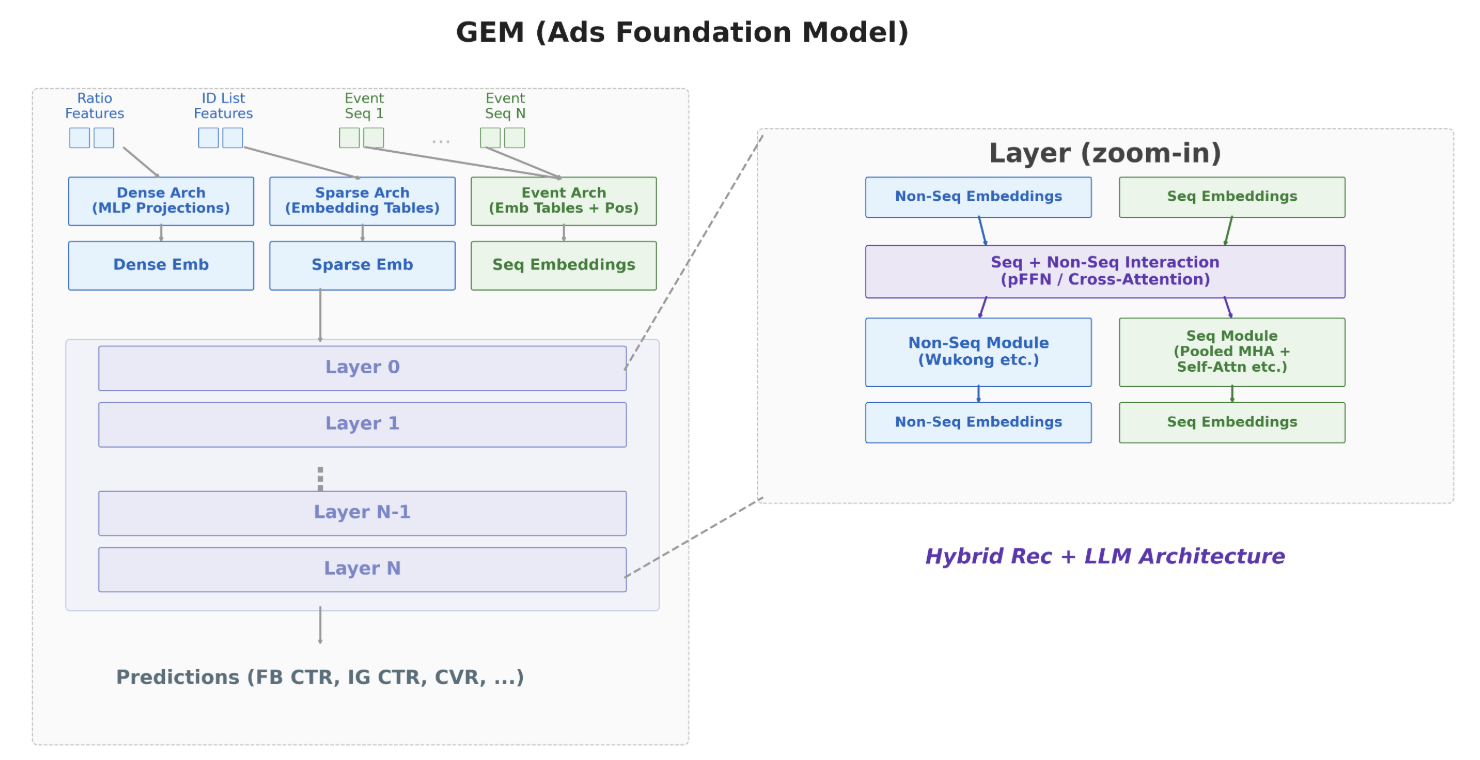
Meta通过自定义内核库和混合精度训练,将GEM广告推荐模型训练效率提升至20-25% MFU,同时实现4倍FLOPs扩展。
入选理由:Jagged Flash Attention(JFA)等自定义内核库使GPU利用率提升100%
与「MXFP8」经常一起出现的 AI 术语。
💡 想追踪「MXFP8」的长期趋势?去 实体雷达 · MXFP8 查看详细分析和跨材料问答。