通过MRC(多路径可靠连接)解锁大规模AI训练网络
OpenAI Blog2836 字 (约 12 分钟)
92
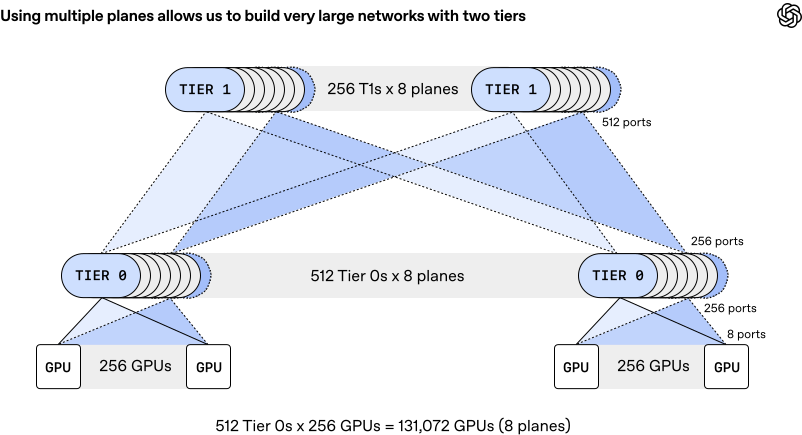
OpenAI联合AMD、NVIDIA等公司推出MRC协议,提升超大规模AI训练网络的性能与可靠性,并已开源至OCP,推动行业标准统一。
入选理由:MRC通过多路径传输和静态源路由设计,有效规避网络拥塞与单点故障,保障AI训练稳定性。
精选文章#MRC#AI训练网络#OpenAI#超算架构#OCP英文
公司
也叫:Advanced Micro Devices
半导体公司
最近变化
2026-10-21 · FlyDSL在MXFP4格式下实现1.68x几何均值加速,优于ATen基准
AMD 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
OpenAI 把训练 ChatGPT 用的网络协议开源了。https://t.co/s2euzfedsb 这套协议叫 MRC(Multipath Reliable Connection,多路径可靠连...
宝玉(@dotey) · 9.2 分
Unlocking large scale AI training networks with MRC (Multipath Reliable Connection)
OpenAI Blog · 9.2 分
The Counterintuitive Networking Decisions Behind OpenAI’s 131,000-GPU Training Fabric
Towards Data Science · 9 分
已收录 30 篇与「AMD」相关的 AI 资讯和分析。
OpenAI联合AMD、NVIDIA等公司推出MRC协议,提升超大规模AI训练网络的性能与可靠性,并已开源至OCP,推动行业标准统一。
入选理由:MRC通过多路径传输和静态源路由设计,有效规避网络拥塞与单点故障,保障AI训练稳定性。
OpenAI 联合多家公司开源 MRC 协议,提升大模型训练网络可靠性,已在超算中部署验证。
入选理由:MRC 实现微秒级故障绕过,避免传统网络中断导致训练重启。
OpenAI通过MRC协议构建了131,000 GPU训练网络,采用反直觉的网络设计,显著提升训练效率。
入选理由:MRC协议消除传统三层控制平面,提升网络可靠性
小型专用模型如 CyberSecQwen-4B 在防御性网络安全任务中表现优于大型通用模型,且支持安全本地部署,无需 API 成本。
入选理由:CyberSecQwen-4B 在 CTI-MCQ 测试中以 0.5868 准确率超越 Cisco 8B 模型 8.7 个百分点。
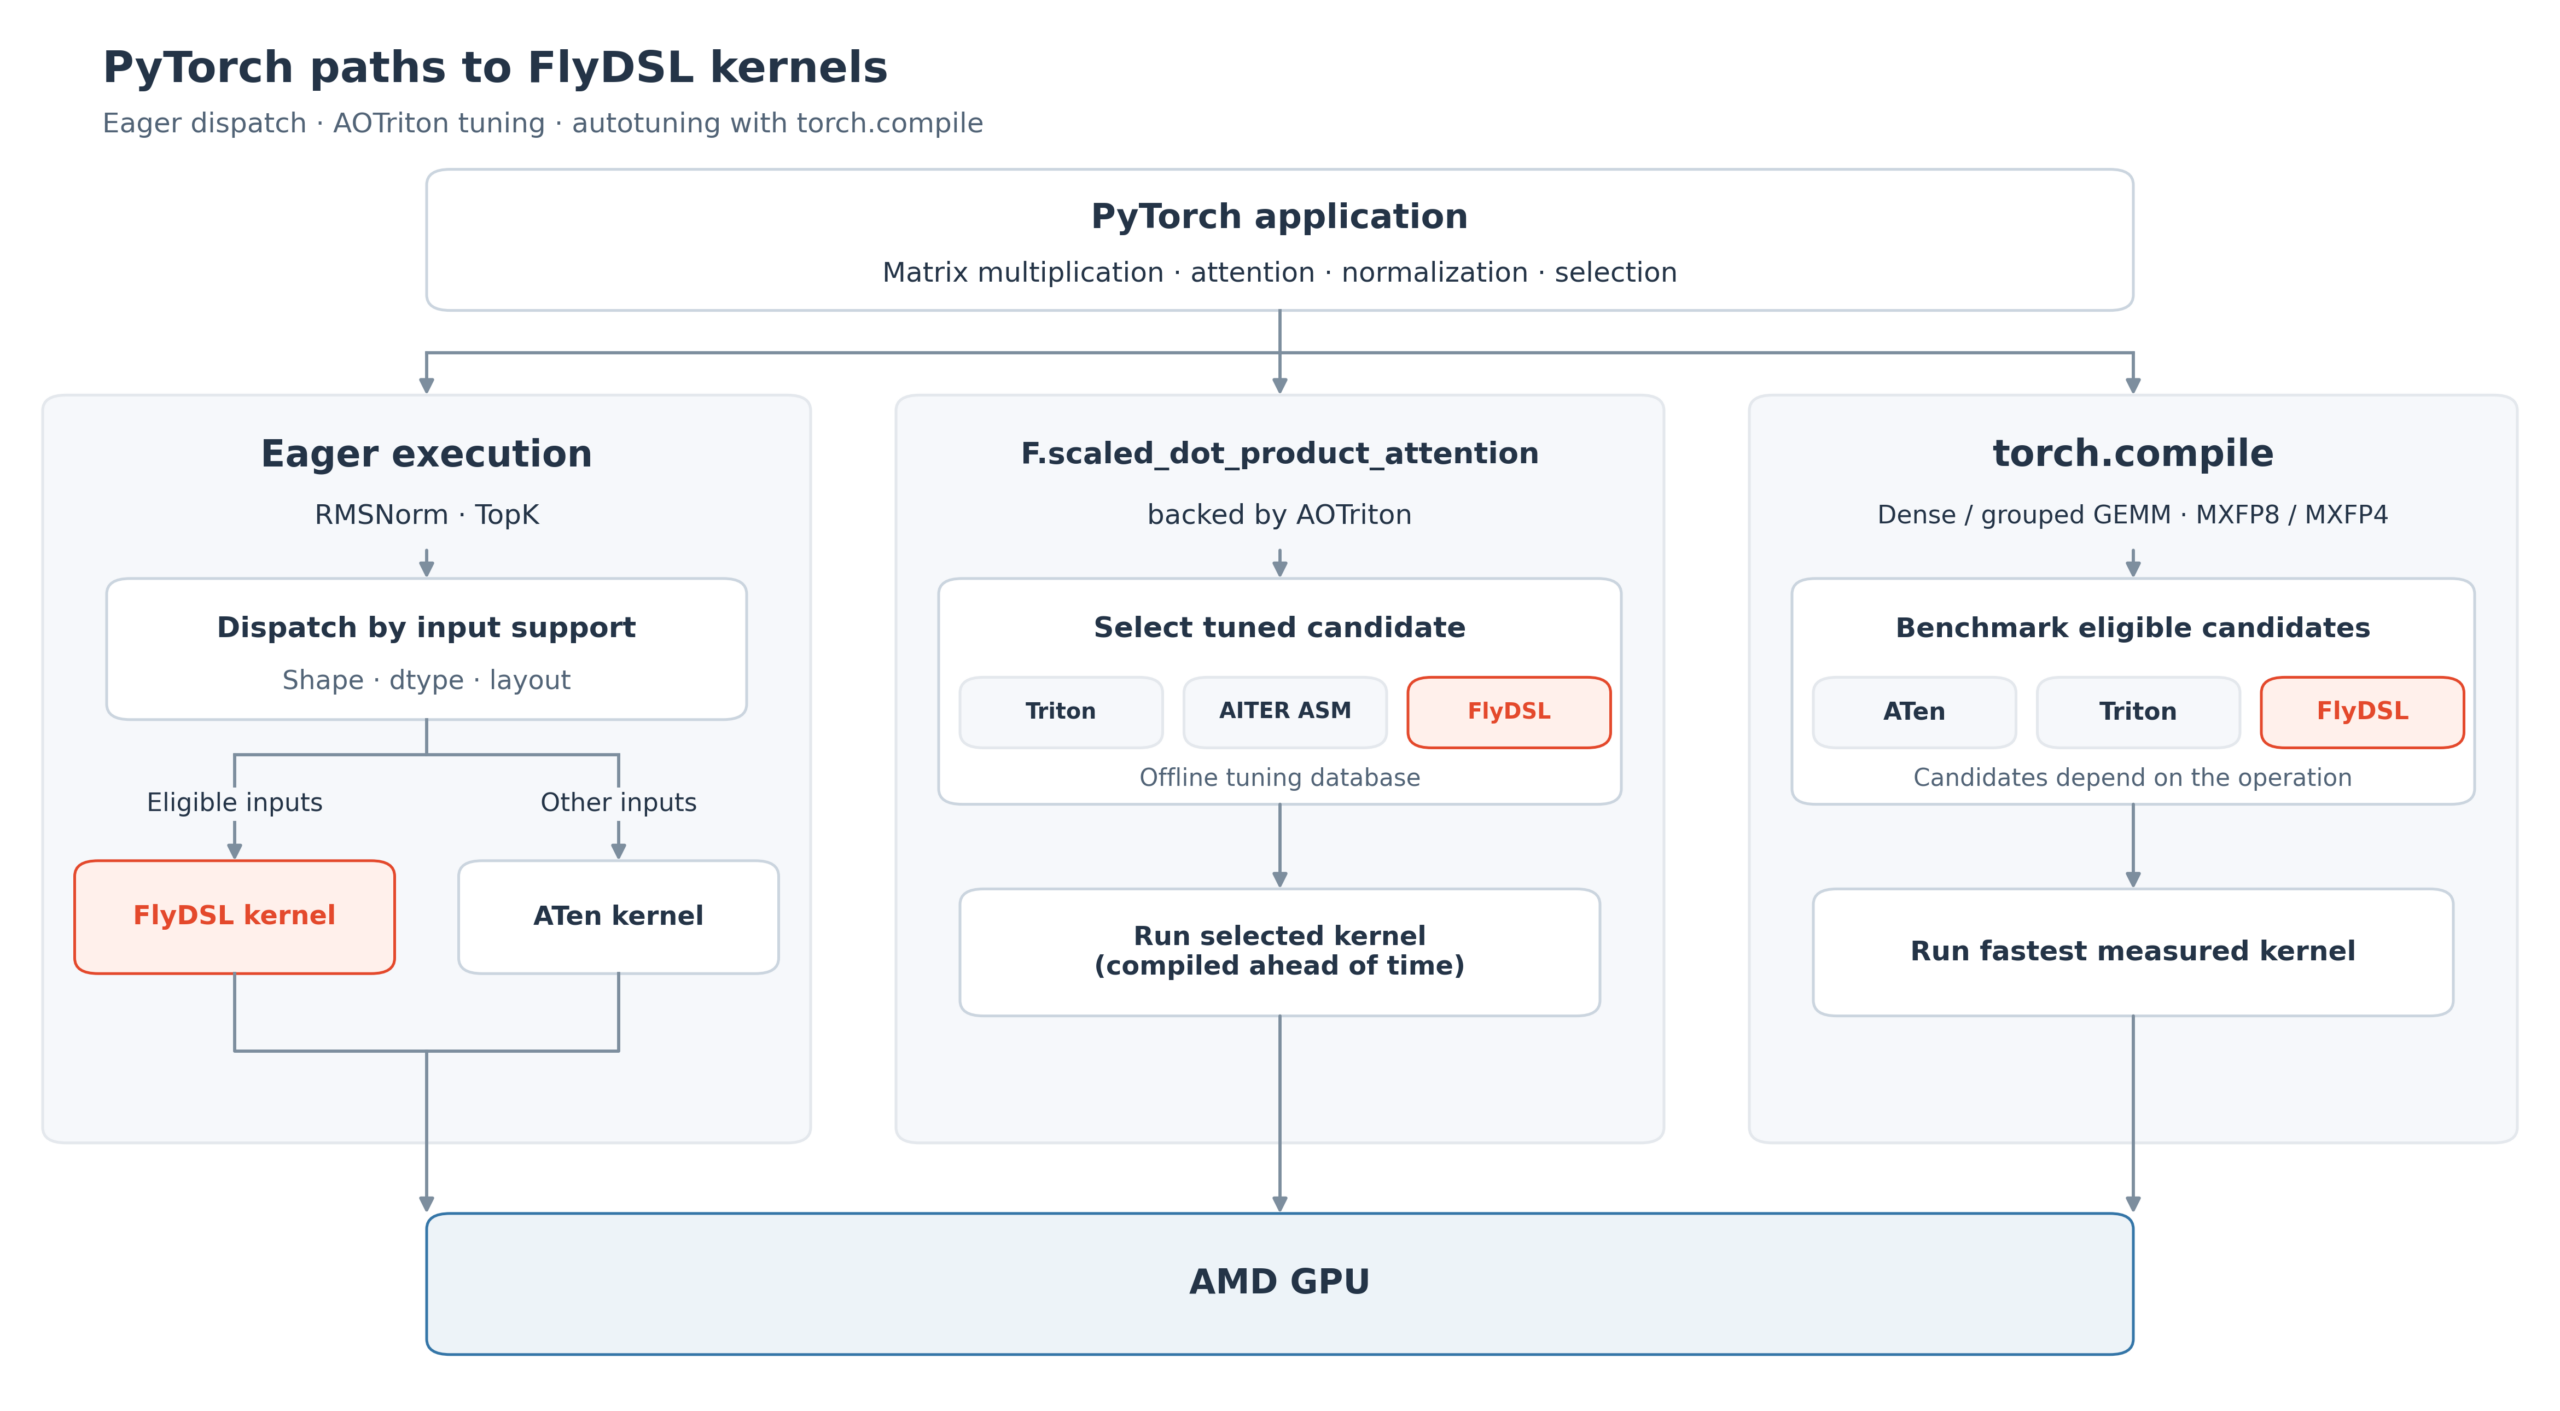
FlyDSL通过显式硬件映射控制,使PyTorch在AMD GPU上实现最高3.66x加速,特别适用于大模型训练场景。
入选理由:FlyDSL在MXFP4格式下实现1.68x几何均值加速,优于ATen基准
Meta发布816B参数开源模型Muse Spark Open,支持多模态和代理任务,集成Helion内核提升性能。
入选理由:Muse Spark Open拥有816B总参数和1M上下文窗口,专为代码生成优化。
AMD以82亿美元收购World Labs,其Atlas模型通过结合生成模型与多视图几何解决稀疏重建问题,影响机器人、设计等领域。
入选理由:AMD收购World Labs金额达82亿美元,强化AI空间智能布局。
PyTorch 2026北美会议聚焦硬件加速与计算基础设施,涵盖TPU、Trainium等新硬件及TorchInductor等工具的深度优化。
入选理由:Trainium实现PyTorch原生支持无需代码修改
MLPerf Client v2.0新增图像生成和智能代理AI基准,提升PC端AI性能评估。
入选理由:新增图像生成基准采用Flux.2 klein 4B实验模型
PyTorch Blog文章展示了在AMD GPU上使用FP8训练的性能提升,包括13.4%吞吐量增益和6.2倍加速,通过Triton融合等技术实现。
入选理由:FP8训练在Llama3-8B模型上实现13.4%吞吐量提升,内存占用与BF16接近。
开源推理引擎vLLM通过10倍性能优化和跨芯片兼容性,正在重塑AI基础设施,可能缩小与闭源模型的差距。
入选理由:vLLM支持Nvidia/AMD/Google最新芯片,实现跨平台部署
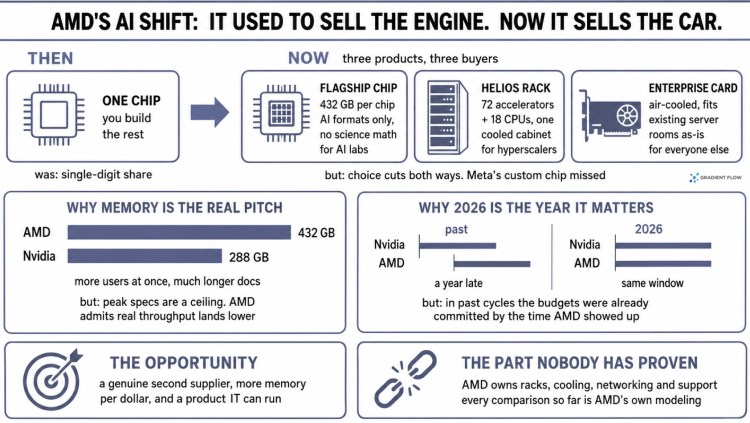
AMD通过多样化AI基础设施产品和软件策略切入AI市场,但面临性能数据真实性与生态兼容性双重挑战。
入选理由:AMD Helios系统采用液冷设计支持大规模云服务,但实际性能仅达峰值的60%-70%
Meta通过fbtriton基础设施实现与上游Triton的同步,结合分层验证框架管理GPU优化创新,解决代码冲突与验证难题。
入选理由:使用agentic ingestion机制实现上游代码自动分类合并,降低冲突风险。
Mac Mini M4 Pro实际内存带宽仅为273GB/s而非宣传的550GB/s,且48GB版本需2039美元,性价比低于AMD Strix Halo。
入选理由:Mac Mini M4 Pro内存带宽实测273GB/s,仅为M4 Max的一半
AMD 在用户强烈反对后,重新在消费级 CPU 中启用内存加密功能 TSME。
入选理由:AMD 因用户反对,重新在消费级 Ryzen 处理器中启用 TSME 内存加密。
Sam Witteveen探讨了在AMD硬件上运行本地AI的可能性,强调了本地AI在隐私和成本控制方面的优势。
入选理由:本地AI模型如Qwen 3.6和Gemma在实际工作中表现出色。
OncoAgent是一个开源的隐私保护肿瘤临床决策支持系统,结合了双层LLM架构和LangGraph拓扑,显著提升了决策支持系统的性能和安全性。
入选理由:OncoAgent结合了双层LLM架构和LangGraph拓扑
OpenAI联合AMD、NVIDIA等发布开源协议MRC,解决超大规模AI训练中多芯片数据同步的可靠性与效率瓶颈,显著减少GPU空转时间。
入选理由:MRC协议通过多路径传输提升大规模AI训练中数据同步的可靠性和带宽利用率。
AMD Ryzen AI Halo 预装 ComfyUI 和多种 AI 模型,可低成本生成高质量图像和视频。
入选理由:AMD Ryzen AI Halo 预装 ComfyUI,支持 Kwen 和 LTX 2.3 模型
AMD CEO苏姿丰在上海AI开发者大会上表示,AI竞争正从模型能力转向系统工程与全栈优化,开发者需要可落地、可优化、可持续演进的工程体系。AMD以ROCm开源平台为核心,提供云端到端侧的全栈算力,并持续加码中国开发者生态建设。
入选理由:AI行业竞争焦点正从模型能力转向系统工程与全栈优化能力,开发者需要可落地、可优化、可持续演进的工程体系
Andrew Ng 推出新课程《Transformers in Practice》,提供对基于 Transformer 的 LLM 工作机制的实践理解。
入选理由:课程由 Andrew Ng 和 Sharon Zhou 合作开发,与 AMD 合作推出
苹果暂停Vision Pro研发,团队分拆至Siri与visionOS;微信状态将上线访客记录;AMD或采用三星2nm制程。
入选理由:苹果Vision Pro项目被取消,原团队拆分至Siri与visionOS部门,重点转向AR眼镜和AI可穿戴设备。
AI 既推动芯片创新,也因智能体应用加剧算力消耗,形成算力悖论。
入选理由:AMD CTO Mark Papermaster 在 HumanX 演讲中提出,异构计算是其 AI 芯片战略核心。
通义千问模型Qwen3.8-Flash-Next在vLLM框架下实现NVIDIA和AMD GPU的原生支持,但技术细节披露有限。
入选理由:Qwen3.8-Flash-Next采用125B参数的超稀疏MoE架构,仅6B参数处于激活状态
Dify与AMD合作举办Hackathon,提供工具简化Agentic AI开发,但缺乏技术深度。
入选理由:Dify平台提供可视化编排工具处理AI代理开发流程
大型语言模型存在推理速度慢、幻觉问题和成本不随规模降低的问题,课程《Transformers in Practice》帮助解决这些问题。
入选理由:大型语言模型的推理速度慢,影响实际应用。
CUDA的护城河因AMD新GPU和Claude的突破而被挑战,但文章缺乏技术细节和数据支撑。
入选理由:AMD新GPU可能打破CUDA长期垄断
AMD Ryzen AI Halo的本地硬件方案为AI开发者提供了更自主的开发环境,作者认为本地开发比云端更具吸引力,并提议探索自研硬件。
入选理由:Ryzen AI Halo支持本地硬件开发,减少对云端的依赖
NVIDIA通过第一方芯片策略影响市场价格,但信息密度低导致实用性有限。
入选理由:第一方芯片策略旨在降低NVIDIA产品价格
Greg Brockman 宣布 OpenAI 联合 AMD、NVIDIA 等公司推出开源网络协议 MRC,声称可提升大规模 AI 训练集群的可靠性与效率,但全文仅一条推文,无技术细节、架构图或实测数据,信息密度极低。
入选理由:OpenAI 联合多家硬件厂商发布开源网络协议 MRC,用于优化 AI 训练集群通信。
与「AMD」经常一起出现的 AI 术语。
💡 想追踪「AMD」的长期趋势?去 实体雷达 · AMD 查看详细分析和跨材料问答。