T
traeai
登录

概念

什么是 Jagged Flash Attention (JFA)?

针对推荐系统优化的自定义注意力机制内核

为什么现在值得关注?

最近变化

2026-08-03 · Jagged Flash Attention(JFA)等自定义内核库使GPU利用率提升100%

Jagged Flash Attention (JFA) 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。

📰 Jagged Flash Attention (JFA) 最新动态

已收录 1 篇与「Jagged Flash Attention (JFA)」相关的 AI 资讯和分析。

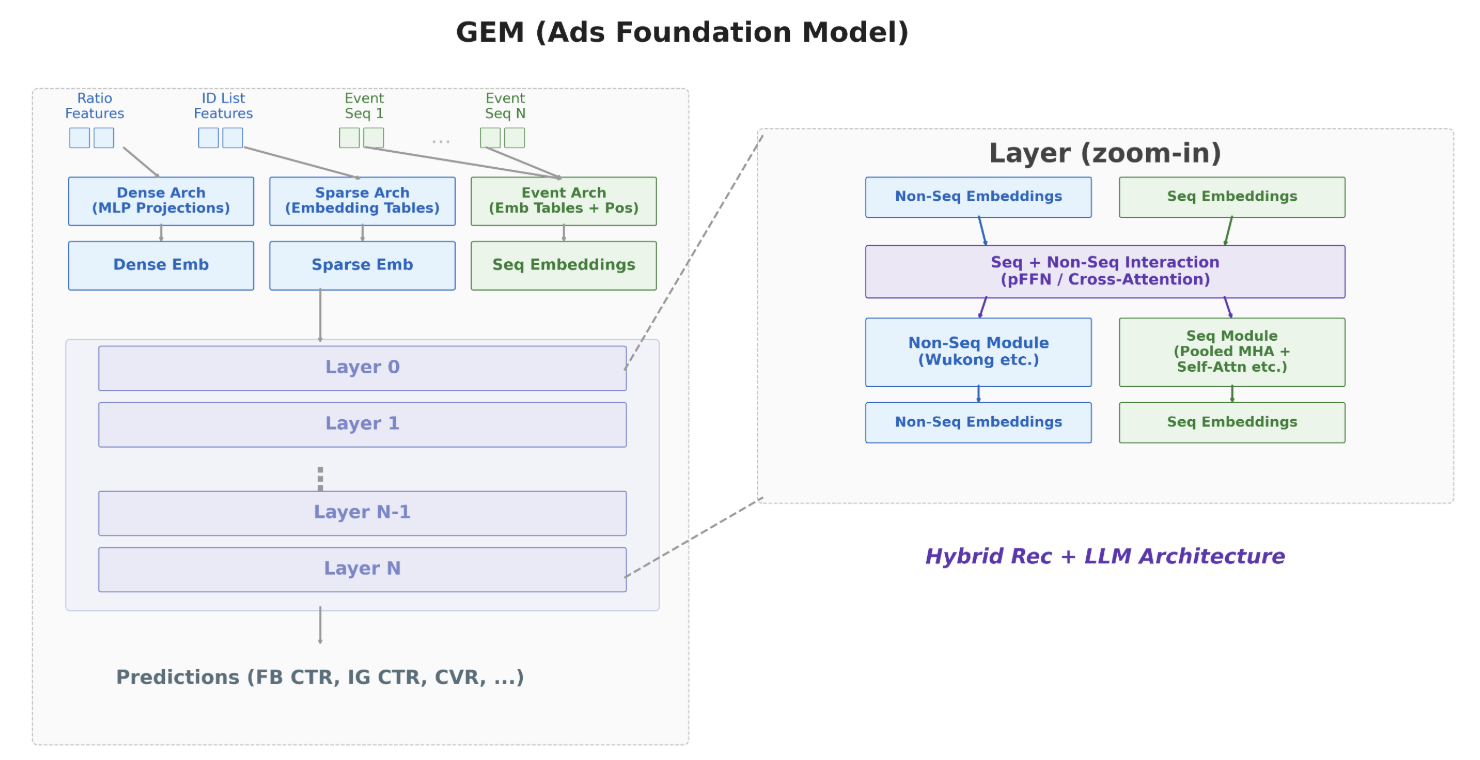
GEM Training: How Meta Doubled the Efficiency of Its LLM-Scale Ads Foundation Model

GEM Training: How Meta Doubled the Efficiency of Its LLM-Scale Ads Foundation Model

Engineering at Meta5052 字 (约 21 分钟)
85

Meta通过自定义内核库和混合精度训练,将GEM广告推荐模型训练效率提升至20-25% MFU,同时实现4倍FLOPs扩展。

入选理由:Jagged Flash Attention(JFA)等自定义内核库使GPU利用率提升100%

精选文章#推荐系统#LLM训练#GPU优化#Meta#广告技术英文

与「Jagged Flash Attention (JFA)」经常一起出现的 AI 术语。

💡 想追踪「Jagged Flash Attention (JFA)」的长期趋势?去 实体雷达 · Jagged Flash Attention (JFA) 查看详细分析和跨材料问答。

AI 可能会生成不准确的信息,请核实重要内容