防洪韧性新篇章:Google开源AI水文预测框架
Google开源了驱动Flood Hub的AI水文预测框架,允许机构使用LSTM架构与Caravan数据集训练本地化洪水模型。新版模型在实测流域将可靠预测窗口延长6天,支持PyTorch生态微调,赋能气象部门在保留数据主权前提下构建高精度预警系统。
入选理由:开源框架基于PyTorch和LSTM架构,提供完整训练管线与交互式教程Notebook。
模型
也叫:PyTorch model
主流深度学习框架
最近变化
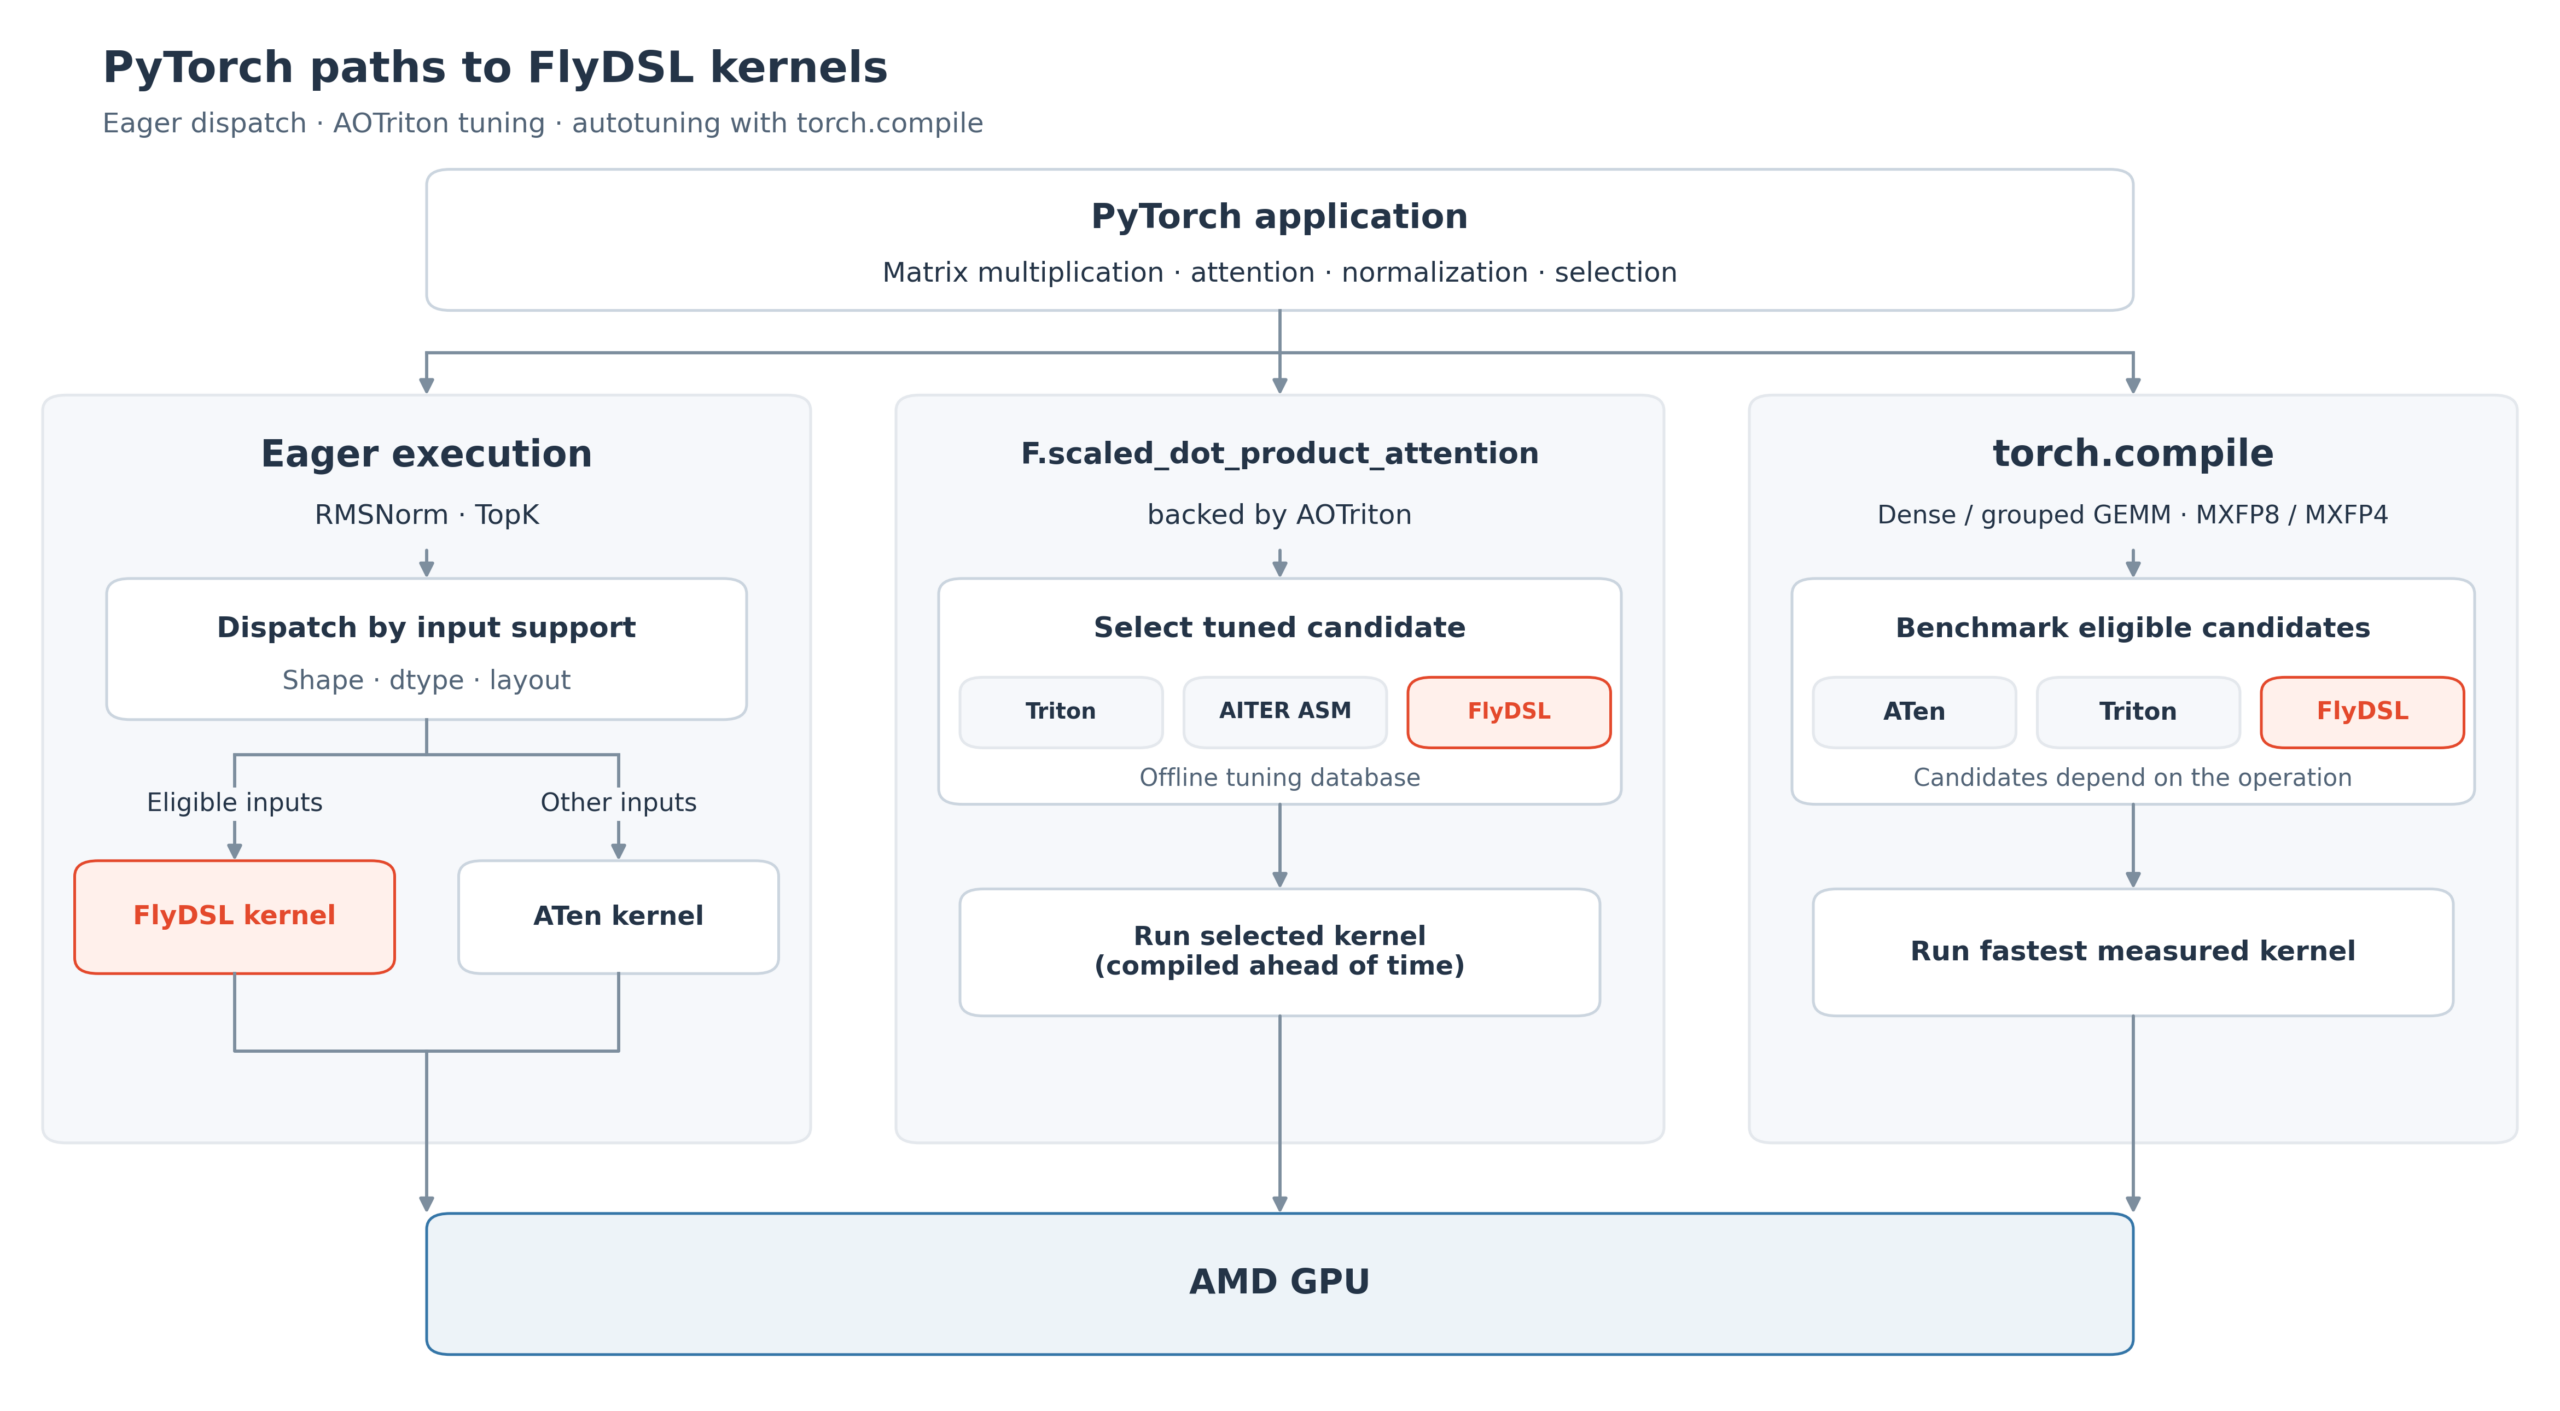
2026-10-21 · FlyDSL在MXFP4格式下实现1.68x几何均值加速,优于ATen基准
PyTorch 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
已收录 30 篇与「PyTorch」相关的 AI 资讯和分析。
Google开源了驱动Flood Hub的AI水文预测框架,允许机构使用LSTM架构与Caravan数据集训练本地化洪水模型。新版模型在实测流域将可靠预测窗口延长6天,支持PyTorch生态微调,赋能气象部门在保留数据主权前提下构建高精度预警系统。
入选理由:开源框架基于PyTorch和LSTM架构,提供完整训练管线与交互式教程Notebook。
AWS 提供了支持大规模基础模型训练与推理的完整技术栈,涵盖高性能计算、网络、存储及开源软件集成,适配 NVIDIA 提出的“三大缩放定律”。
入选理由:NVIDIA 的三大缩放定律包括预训练、后训练(如 SFT 和 RL)和推理时计算,需统一基础设施支持。
FlyDSL通过显式硬件映射控制,使PyTorch在AMD GPU上实现最高3.66x加速,特别适用于大模型训练场景。
入选理由:FlyDSL在MXFP4格式下实现1.68x几何均值加速,优于ATen基准
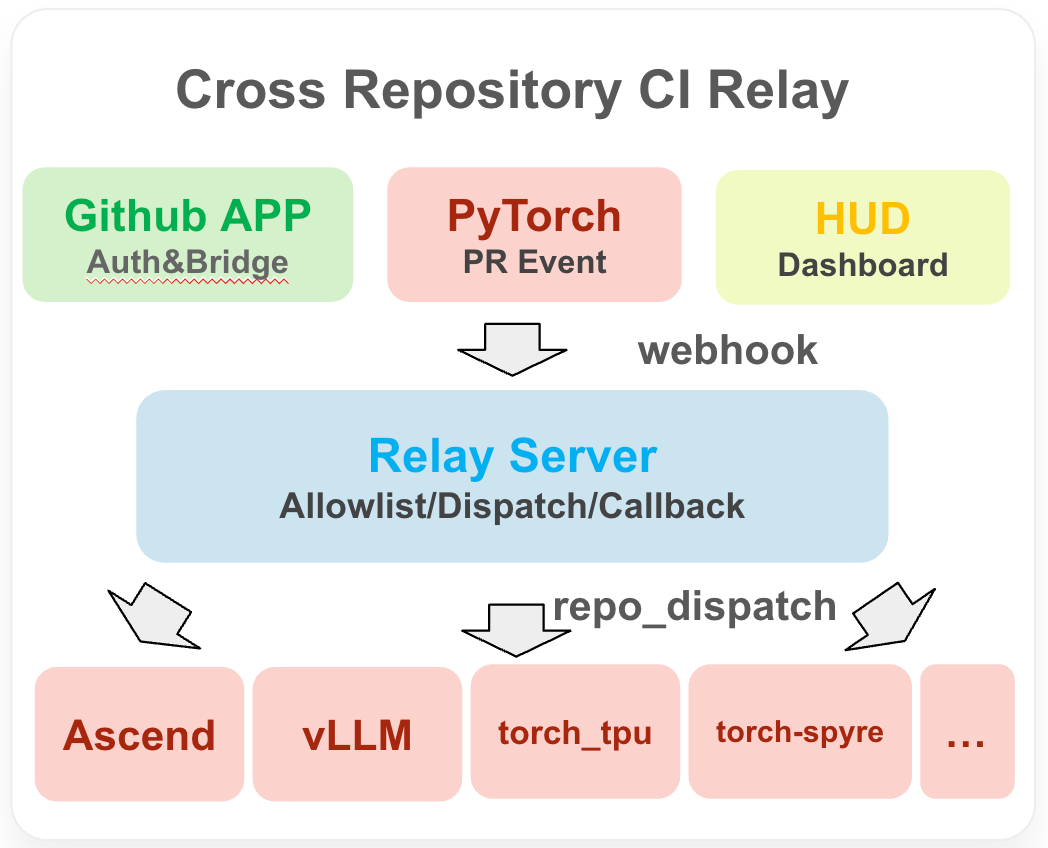
PyTorch加速器集成工作组在2026上半年推动跨平台硬件标准化,通过CRCR机制和测试套件重构提升集成效率。
入选理由:CRCR机制实现跨仓库CI自动化协调,减少集成延迟
Ray框架成为AI基础设施标准,与Kubernetes整合构建统一AI栈,LinkedIn展示三层PyTorch训练架构。
入选理由:Ray与Kubernetes协同进化是AI基础设施核心趋势
PyTorch 2026北美会议新增入门课程与认证培训,覆盖GPU编程、模型优化等核心技能,适合不同层次开发者系统提升实战能力。
入选理由:2026年10月19日加州圣何塞将举办PyTorch Associate认证培训(9am-5pm)
TinyTorch是PyTorch官方推出的开源教学框架,通过纯Python实现从张量到Transformer的完整构建,帮助学习者深入理解机器学习框架内部机制。
入选理由:TinyTorch可在4GB内存设备上运行,无需GPU
Shopify通过PyTorch和vLLM构建持续学习循环,将生产失败转化为模型权重,提升质量并降低96%服务成本。
入选理由:使用PyTorch和vLLM构建持续学习循环可降低96%服务成本
本文介绍一门27小时深度学习课程,系统复现Geoffrey Hinton的突破性研究,涵盖从Boltzmann机到AlexNet等核心算法的PyTorch实现。
入选理由:课程复现Hinton的15项深度学习突破,包括AlexNet和Dropout等关键算法
NVIDIA TensorRT Model Connect工具通过两步命令实现模型快速部署,结合TensorRT优化技术显著加速推理过程。
入选理由:使用TensorRT Model Connect可将PyTorch模型转换为部署包仅需两步命令
PyTorch 2.14 引入 NVGEMM 性能优化、Apple Silicon 原生线性代数支持及分布式容错机制,显著提升大规模训练和推理效率。
入选理由:NVGEMM 技术使 CUTLASS 内核融合效率提升 30% 以上
PyTorch 2026北美会议聚焦硬件加速与计算基础设施,涵盖TPU、Trainium等新硬件及TorchInductor等工具的深度优化。
入选理由:Trainium实现PyTorch原生支持无需代码修改
印度正通过PyTorch与Hugging Face合作培养下一代AI系统构建者,聚焦分布式训练、推理优化等基础设施技术。
入选理由:PyTorch profiling工具链包含record_function和profile API,可分离等待/预热/采集阶段
Cambricon成为PyTorch基金会铂金会员,致力于推动AI芯片与PyTorch生态的深度整合。
入选理由:Cambricon在PyTorch中贡献了torch.compile、Eager Operators等核心模块。
AI推理依赖模型权重、推理服务器和GPU协同工作,KV缓存优化可降低延迟和成本。
入选理由:推理服务器(如vLLM)是实现生产级GPU利用率的关键组件
PyTorch生态系统新增10个项目,涵盖数据效率、强化学习、多损失训练等,提升AI开发效率。
入选理由:Perforated通过神经元特异性强化学习信号减少70%错误率
PyTorch 2026年北美会议展示编译器优化、跨仓库CI Relay和AI代理在发布工程中的应用,加速器后端兼容性验证时间缩短至分钟级。
入选理由:Cross-Repo CI Relay使Ascend NPU/RISC-V后端兼容性检测从天级缩短至分钟级
Transformer模型推理需通过自回归生成和键值缓存优化性能,PyTorch实现细节揭示训练与推理的核心差异。
入选理由:自回归生成需逐个生成token,依赖前序所有输出
PyTorch 2.13发布,引入FlexAttention加速、CuTeDSL后端、内存优化等,显著提升多平台性能与分布式训练效率。
入选理由:FlexAttention在Apple Silicon上实现最高12倍加速,提升稀疏模式性能。
PyTorch通过融合归一化操作到GEMM和注意力内核,实现高达35%的性能提升,减少内存IO开销。
入选理由:Lazy Pre-Norm和Multi-CTA Norm Fusion技术可隐藏90%的归一化延迟
PyTorch 3.7引入Triton Plugin Extensions,支持动态加载自定义编译器传递,无需分叉Triton,性能匹配厂商库。
入选理由:Triton Plugin Extensions允许动态加载自定义编译器传递,无需分叉或重新编译。
PyTorch基金会宣布成立多项目基金会,PyTorch 2.13发布显著优化性能,vLLM推出Model Runner V2并公布2026路线图。
入选理由:PyTorch 2.13在Apple Silicon上实现FlexAttention性能提升至SDPA的12倍
美国AI开放科学250年里程碑揭示:开放生态推动创新,当前AI领域正面临封闭化风险。
入选理由:美国AI发展依赖250项开放成果,包括GPT-2、PyTorch等关键模型与工具
华人博士Alisa开源AI求职经验,含57场面试细节与OpenAI入职攻略。
入选理由:Alisa共面试57场,最终入职OpenAI。
Apple 推出 Core AI 框架,支持在 Apple Silicon 上运行大型语言模型和生成式 AI,提升设备端 AI 性能。
入选理由:Core AI 支持从 3B 参数视觉模型到 70B 参数大语言模型的部署。
谷歌推出TPU开发者中心,提供TPU硬件、软件栈、优化策略等全面资源,助力开发者提升模型性能。
入选理由:TPU开发者中心涵盖从预训练到推理的全流程资源。
成为2026年LLM工程师需掌握五大技能领域,包括基础、提示与工具调用、检索、微调与对齐、服务与运维。
入选理由:掌握LLM工程师需掌握的五大技能领域:基础、提示与工具调用、检索、微调与对齐、服务与运维。
2026 年最佳 Python AI 框架包括 TensorFlow、PyTorch、scikit-learn 等,适用于不同 AI 项目需求。
入选理由:PyTorch 和 TensorFlow 适用于深度学习任务,如图像和文本处理。
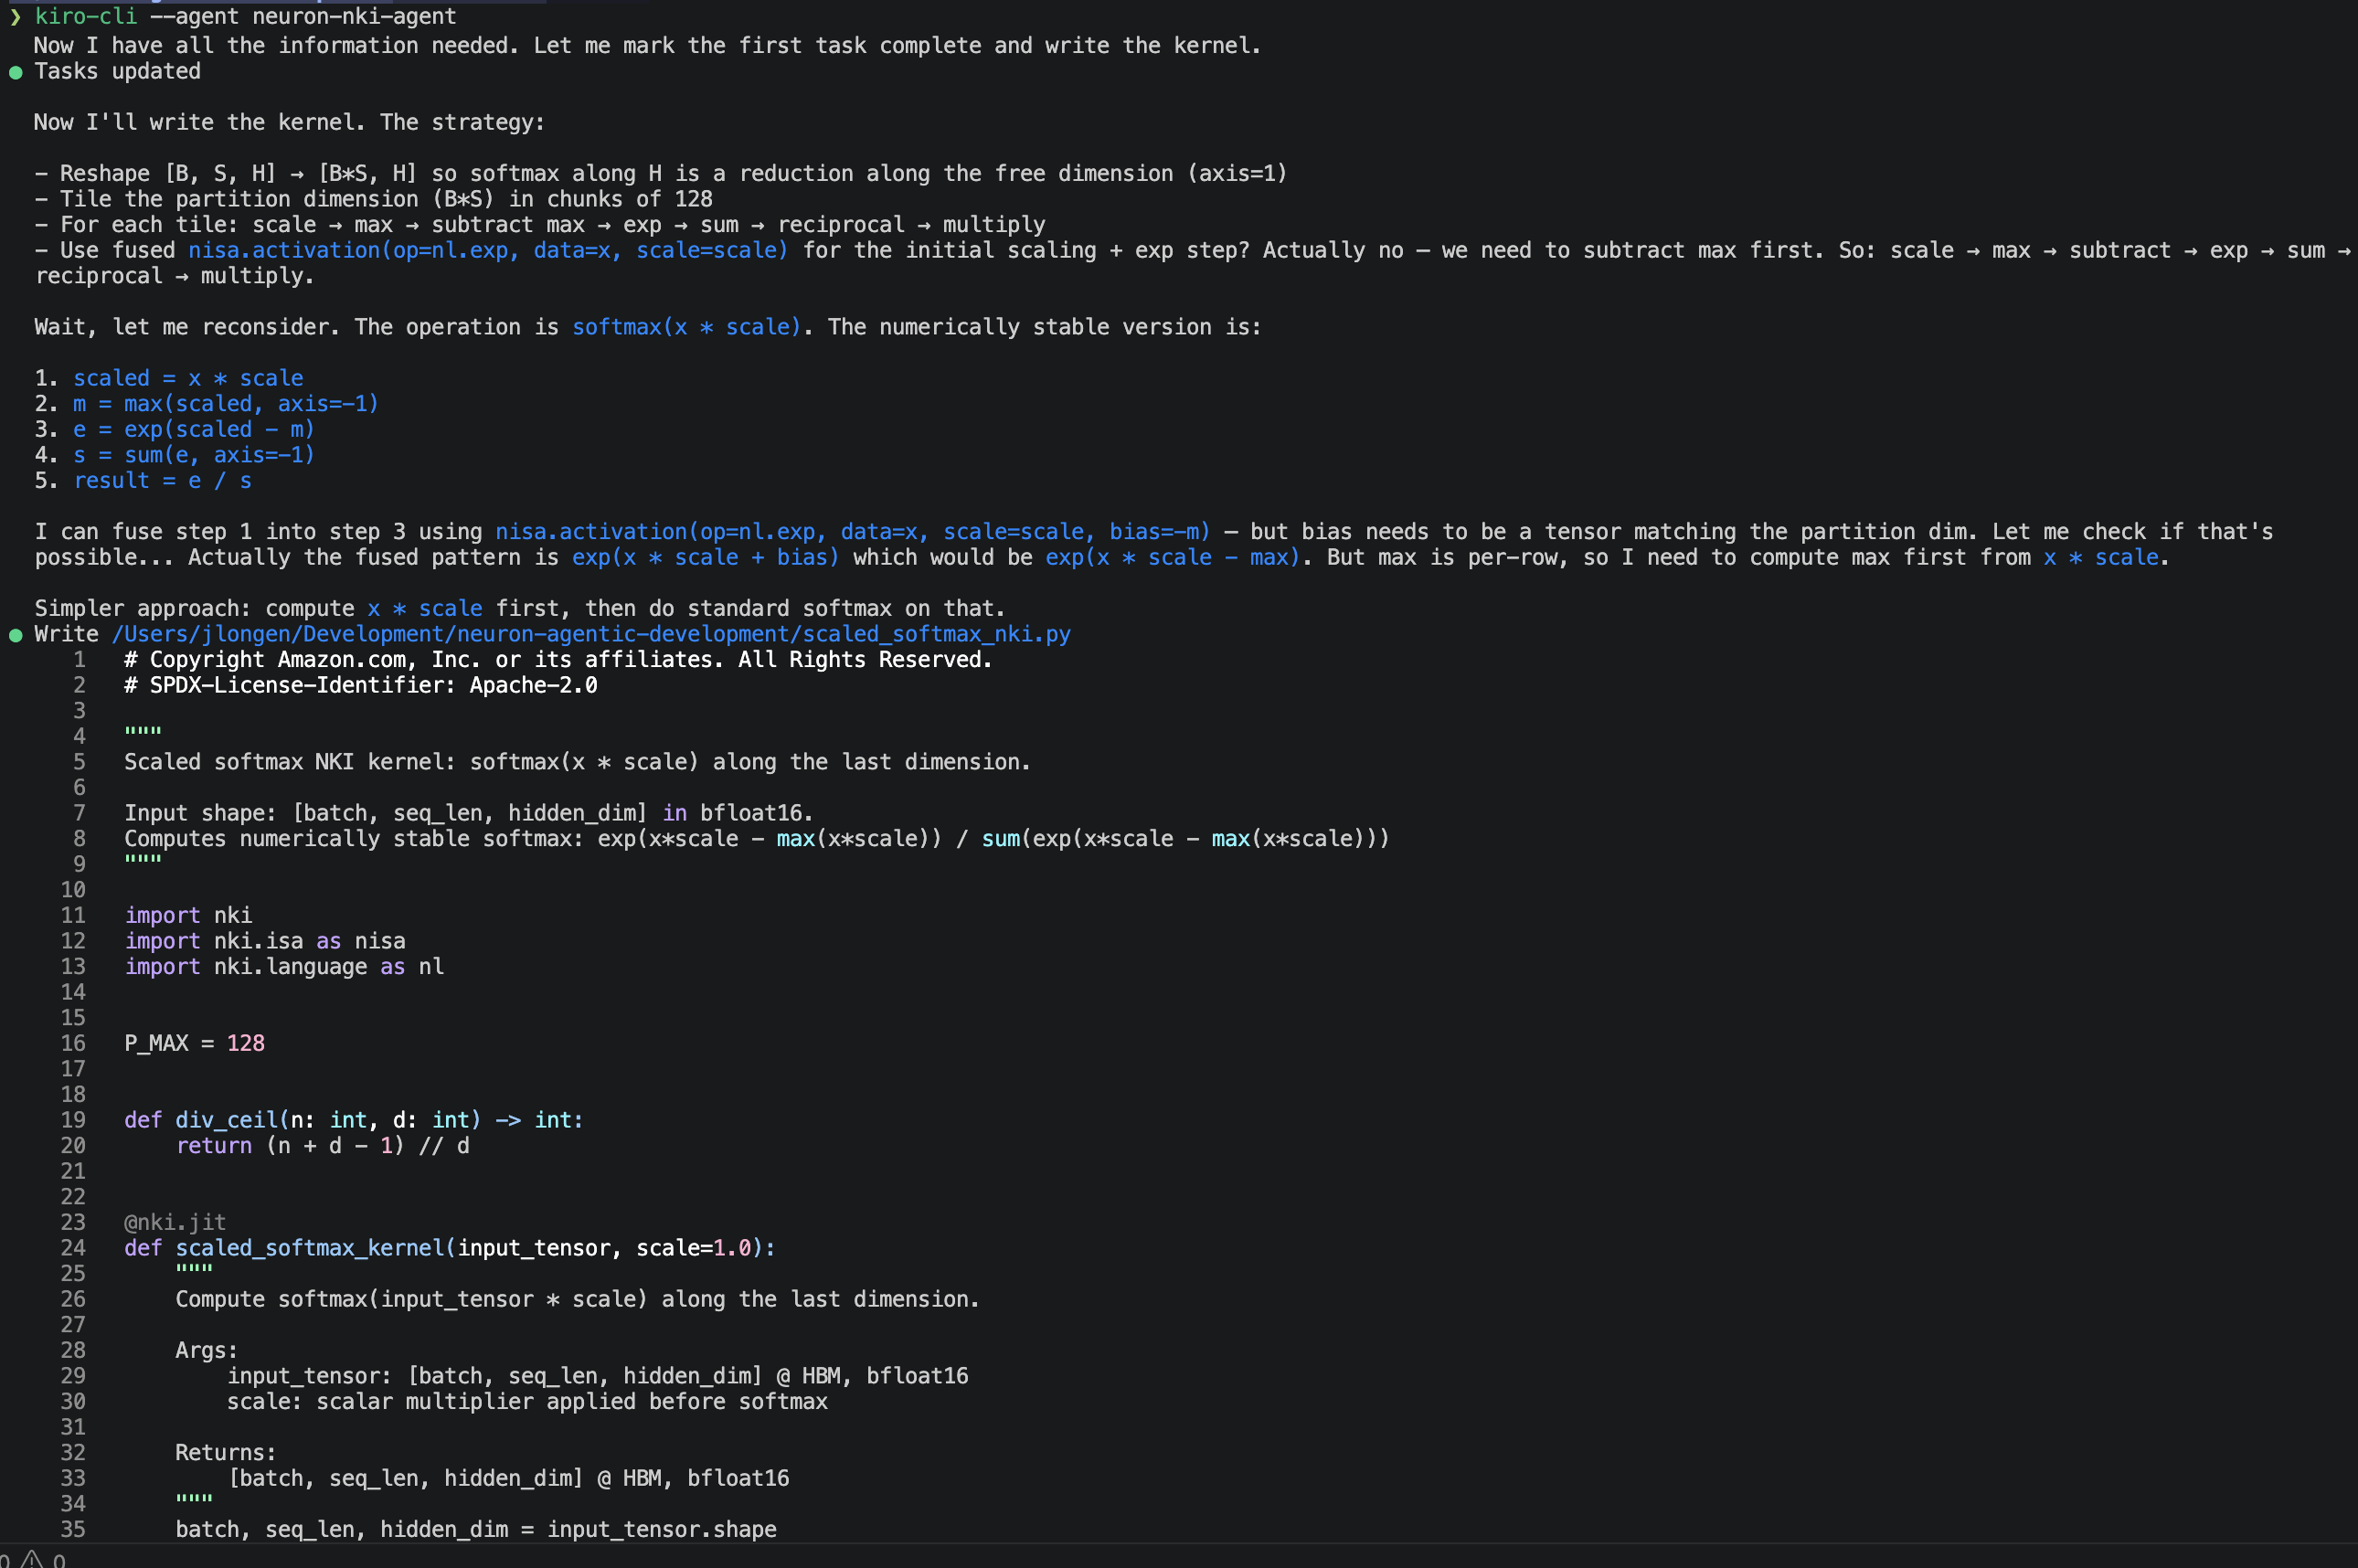
AWS 推出 Neuron Agentic Development,通过 AI 代理加速 Trainium 硬件优化,降低开发门槛。
入选理由:Neuron Agentic Development 提供五项技能,支持从编写到分析的完整内核开发流程。
PyTorch 中 nn.Linear 的性能分析显示,其内部的矩阵转置操作显著影响计算效率,通过融合 MLP 可以减少开销。
入选理由:nn.Linear 的矩阵转置操作会增加计算开销。
与「PyTorch」经常一起出现的 AI 术语。
💡 想追踪「PyTorch」的长期趋势?去 实体雷达 · PyTorch 查看详细分析和跨材料问答。