Introducing the MLPerf End-to-End RAG Inference Benchmark
MLCommons2766 字 (约 12 分钟)
85
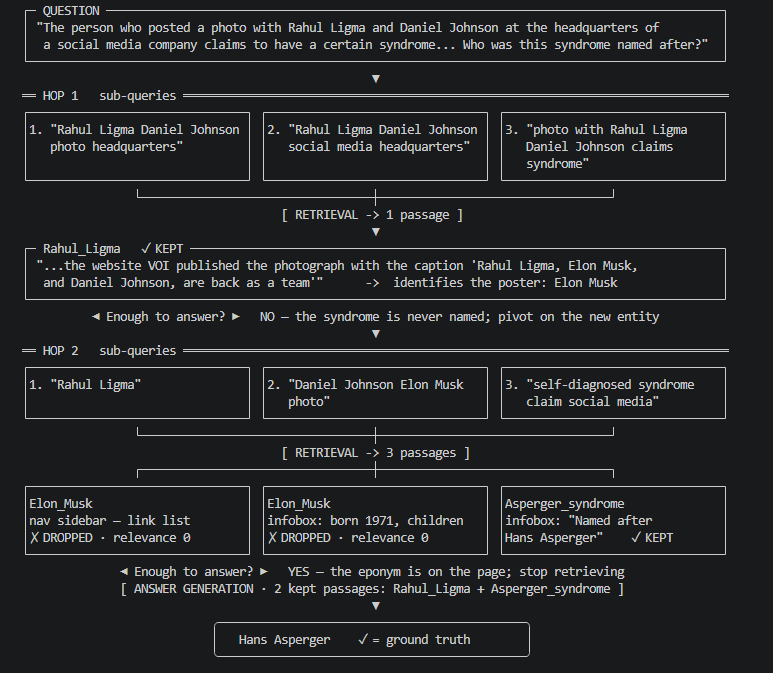
MLPerf推出首个端到端RAG推理基准,覆盖向量数据库构建与多跳问答流程,揭示多模型协作优化空间。
入选理由:RAG系统需多模型协作,单模型基准无法衡量其迭代推理行为
精选文章#MLPerf#RAG#AI推理#基准测试英文
产品
全球领先的机器学习性能基准框架
最近变化
2026-08-26 · RAG系统需多模型协作,单模型基准无法衡量其迭代推理行为
MLPerf 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
已收录 4 篇与「MLPerf」相关的 AI 资讯和分析。
MLPerf推出首个端到端RAG推理基准,覆盖向量数据库构建与多跳问答流程,揭示多模型协作优化空间。
入选理由:RAG系统需多模型协作,单模型基准无法衡量其迭代推理行为
企业应通过五个关键问题评估基准测试的可信度,以避免被误导。MLCommons提出基准测试需满足目标相关性、数据清洁性、可重复性等要求。
入选理由:基准测试的失效常见于数据污染,如系统在训练中接触过测试数据。
CoreWeave在MLPerf 0.7 Endpoints基准测试中,使用68块NVIDIA Blackwell GPU实现每秒44万输出token,验证了DeepSeek-R1模型的高效推理能力。
入选理由:CoreWeave在MLPerf 0.7测试中使用68块NVIDIA Blackwell GPU实现了441,740 token/s的吞吐量
MLPerf v6.0新增稀疏计算基准,推动AI系统多样性,DeepSeek V3参数达6710亿。
入选理由:DeepSeek V3使用6710亿参数,激活370亿参数/令牌,验证大规模稀疏训练系统。
与「MLPerf」经常一起出现的 AI 术语。
💡 想追踪「MLPerf」的长期趋势?去 实体雷达 · MLPerf 查看详细分析和跨材料问答。