Hardware-Agnostic Models in vLLM
PyTorch Blog2004 字 (约 9 分钟)
85
vLLM引入硬件无关层,在NVIDIA H100上实现接近原生性能,吞吐量差异仅3.4%。
入选理由:HW agnostic层在NVIDIA H100上实现3.4%吞吐量差异(几何平均值)
精选文章#vLLM#PyTorch#GPU优化#模型兼容性英文
产品
也叫:Blackwell
NVIDIA下一代GPU架构
最近变化
2026-09-22 · HW agnostic层在NVIDIA H100上实现3.4%吞吐量差异(几何平均值)
NVIDIA Blackwell 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
已收录 7 篇与「NVIDIA Blackwell」相关的 AI 资讯和分析。
vLLM引入硬件无关层,在NVIDIA H100上实现接近原生性能,吞吐量差异仅3.4%。
入选理由:HW agnostic层在NVIDIA H100上实现3.4%吞吐量差异(几何平均值)
AI虚拟人技术面临实时语音处理、视觉整合与情感智能三大挑战,Boson AI等公司正在探索多模态交互的突破路径。
入选理由:实时语音处理需在音频分词、延迟和模型规模间进行关键权衡
CoreWeave在MLPerf 0.7 Endpoints基准测试中,使用68块NVIDIA Blackwell GPU实现每秒44万输出token,验证了DeepSeek-R1模型的高效推理能力。
入选理由:CoreWeave在MLPerf 0.7测试中使用68块NVIDIA Blackwell GPU实现了441,740 token/s的吞吐量
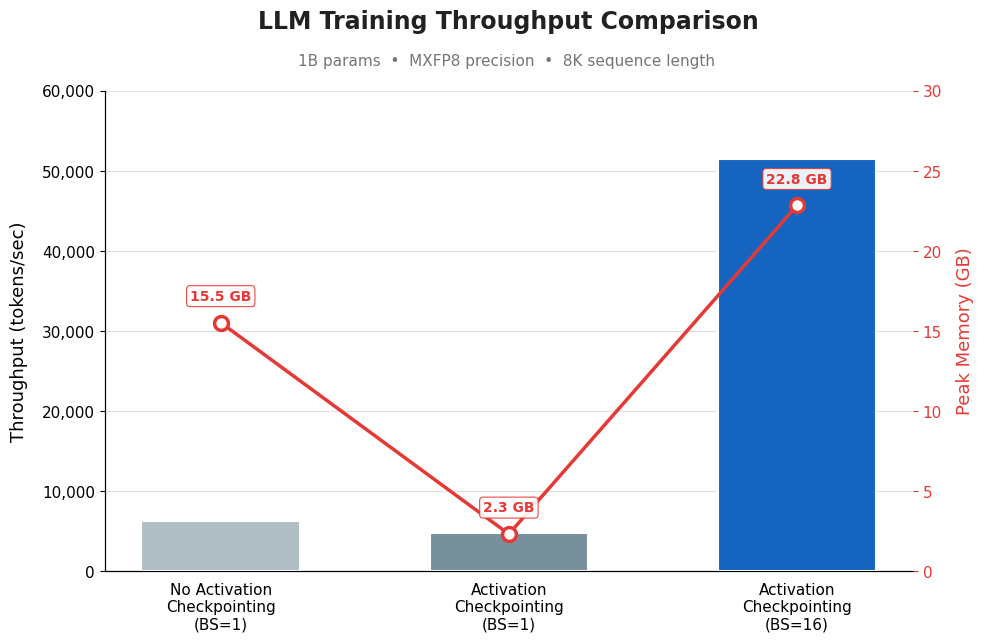
NVIDIA Blackwell GPU与Amazon SageMaker AI结合,显著提升大规模AI模型训练效率,减少内存限制和通信开销。
入选理由:Blackwell的180GB内存和新型精度格式可减少内存压力,支持更大批次和更长序列。
Ollama 新增 NVIDIA Blackwell GPU 以更好支持 GLM-5.1 模型。
入选理由:Ollama 已扩展 NVIDIA Blackwell GPU 阵容以优化 GLM-5.1 模型性能。
Together AI 推出 DeepSeek-V4 Pro 模型,提供高性能推理和多种计算选项。
入选理由:DeepSeek-V4 Pro 在 NVIDIA Blackwell 上实现 1.3 倍速度提升。
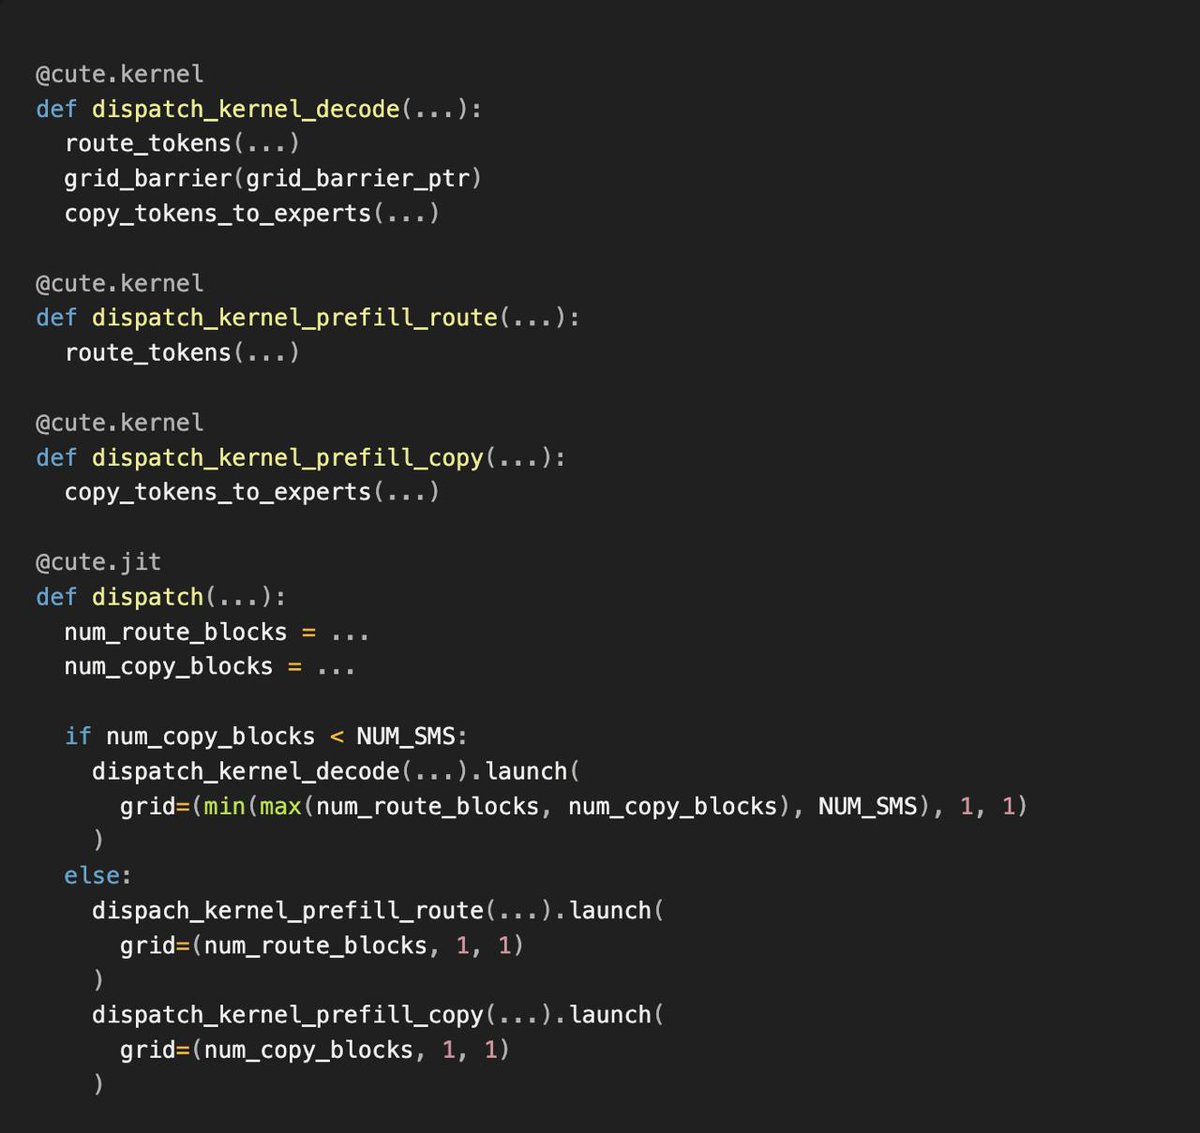
Perplexity 推出自研推理引擎 ROSE,支持从嵌入模型到万亿参数大模型的高效服务,并集成 CuTeDSL 以加速 GPU 内核定制。
入选理由:Perplexity 自主研发了推理引擎 ROSE,提升大模型服务效率。
与「NVIDIA Blackwell」经常一起出现的 AI 术语。
💡 想追踪「NVIDIA Blackwell」的长期趋势?去 实体雷达 · NVIDIA Blackwell 查看详细分析和跨材料问答。