Hardware-Agnostic Models in vLLM

TL;DR · AI 摘要
vLLM引入硬件无关层,在NVIDIA H100上实现接近原生性能,吞吐量差异仅3.4%。
核心要点
- HW agnostic层在NVIDIA H100上实现3.4%吞吐量差异(几何平均值)
- 新层解决与fullgraph torch.compile的兼容性问题
- 支持NVIDIA Blackwell和GB300 NVL72等新型硬件架构
结构提纲
按章节快速跳转。
思维导图
用一张图看清主题之间的关系。
查看大纲文本(无障碍 / 无 JS 友好)
- vLLM硬件无关模型
- 核心机制
- HW agnostic层设计
- torch.compile兼容性处理
- 性能表现
- H100吞吐量差异3.4%
- 硬件适配
- Blackwell GPU支持
- GB300 NVL72适配
金句 / Highlights
值得收藏与分享的关键句。
HW agnostic层在H100上实现3.4%吞吐量差异(几何平均值)
DeepSeek V4和Kimi K3采用不同百万token上下文实现方案
NVIDIA Blackwell需要精细内核工程实现计算通信重叠
特色项目
- 
TL;DR
为了在前沿领域实现最先进的性能,vLLM正在以与fullgraph torch.compile不兼容的方式改变其内部实现。这可能对关注树外加速器、旧版GPU或更特殊模型的用户产生影响。为了解决这个问题,我们正在引入一组新的“硬件无关”层。这些层将确保vLLM能够继续以光速前进,同时满足关注可移植性的用户需求。在NVIDIA H100 GPU上,硬件无关层实现的总令牌吞吐量达到原生实现的96.6%(三个最新模型的几何平均值)。
vLLM在前沿领域
通过定位为支持各种硬件上多种模型的抽象层,vLLM已取得前所未有的成功。通过使用一组精心设计的抽象和torch.compile用于优化和融合,该项目能够使定义实际模型逻辑的代码(通常称为“模型定义”)保持相对简单,同时在NVIDIA GPU、AMD GPU、Intel XPUs、Google TPUs、IBM Spyre、华为昇腾等硬件上实现高性能。
然而,前沿开源模型的架构正在迅速分化,这促使社区重新审视现有抽象是否仍然适用。模型越来越多地包含定制层和优化内核。甚至核心注意力机制也出现分化:DeepSeek V4和Kimi K3通过完全不同的方法实现百万令牌上下文。将这些模型适配到vLLM需要从model_executor/layers中的共享层构建模型,并保持整个模型可被fullgraph编译:以Dynamo可追踪的方式编写,每个新内核都作为带有虚假实现和正确变异注解的torch库操作注册。这项工作增加了模型开发的负担,由添加模型的开发者承担,包括带来自定义模型的高级用户。
与此同时,NVIDIA Blackwell GPU和NVIDIA GB300 NVL72这类机架级系统需要精心的内核工程来利用新特性,并有效重叠计算与通信。
在所有这些进展中,我们见证了Claude Code和OpenAI Codex等代码代理的兴起,它们使代码生成变得更加容易。特别是,这些代理在为特定硬件上的特定模型设计优化方面非常有效。然而,它们在不需要担心特定更改是否会对不同加速器上的不同模型造成负面影响时表现最佳。
这些趋势汇聚在一起,意味着为了在最新的GPU硬件上实现最先进的性能,社区希望拆解vLLM中的一些现有抽象层。具体而言,vLLM开始维护硬件特定的模型定义,也称为“扁平化”模型。与使用torch.compile不同,扁平化模型采用自定义融合和其他模型特定及硬件特定的优化。最近几个月新增到vLLM中的前沿模型都使用这种扁平化模型定义。关键问题是,现有模型定义所使用的层和操作可能会被重构,从而与torch.compile产生根本性不兼容。
这项工作对于使vLLM在最新GPU基准测试中保持竞争力至关重要。但同时,vLLM也需要继续服务于那些关心在不同硬件(如旧版GPU或非树外(OOT)加速器)上部署多样化模型的用户。
那么我们该如何应对?让我们先回顾一下vLLM目前如何处理模型定义。
vLLM中的模型定义是如何工作的?
目前,vLLM提供了三种模型定义方式:
- 新的“扁平化”模型,位于
vllm/models/目录下 - 旧版模型,位于
vllm/model_executor/models目录下 - 基于transformers的建模后端,从transformers导入模型
当前状态的高层架构如下所示。
__
_图1:vLLM中模型定义的当前状态。所有三种定义方式最终都会映射到每个通用层的单一实现,此处以RowParallelLinear为例。SpyreRowParallelLinear是一个非树外插件,用于在某个加速器上覆盖该层。_
尽管建模逻辑可能位于不同位置,但大多数模型都由通用层组成,如注意力机制、专家混合、线性投影、归一化和激活函数。需要理解的是,在上述所有三种情况下,这些通用层仍然只在一个地方实现。在情况(1)和(2)中,这些层明确从vllm/model_executor/layers导入。在情况(3)中,transformers模型会自动融合并重新连接以使用vLLM的层。因此,无论模型定义来自何处,我们仍然使用着构成其大部分层的通用实现。
vLLM的层实现经历了数年的发展,现在提供两个重要特性,我们将在下文详细讨论:(a)torch compile支持,以及(b)非树外扩展性。
虽然扁平化模型不使用完整的图torch compile,但这是实现像IBM Spyre这样的非树外插件的关键特性。Spyre依赖TorchDynamo追踪模型图,并依赖TorchInductor将图转换为在目标硬件上最优运行的表示形式。关键的是,torch compile也是使vLLM的transformers后端实现像Qwen3这样的模型在NVIDIA GPU上达到原生速度的必要组件。
然而,对于OOT插件而言,torch compile并不是全部问题。像Spyre这样的加速器偶尔也需要向层中注入行为(例如自定义内存布局),以实现最佳性能。vLLM的层提供了两种不同的机制来注入自定义行为:CustomOp(允许插件覆盖前向函数)和PluggableLayer(允许插件覆盖整个层)。没有这种可扩展性,OOT插件将需要自己重新实现许多层。
那么这里的问题是什么?
除了模型定义在三个地方存在令人困惑之外,上述设计还存在更紧迫的问题。
扁平化模型工作流需要修改模型定义及其底层实现,以破坏与torch compile的兼容性并移除通过CustomOp实现可扩展性的支持。这将使他们能够更快地开发特定硬件和特定模型的性能优化,但也引发了一些担忧。
首先,这将迫使OOT插件面临维护自己的模型定义和层的前景,造成巨大的维护负担。支持新模型将需要向transformers、vLLM以及所有希望支持该模型的OOT插件提交拉取请求。虽然代码代理可以简化这一过程,但最终仍需在多个组织之间消耗大量token预算,却无法带来实际收益。
其次,vLLM越来越依赖transformers后端来支持旧版或更小众的模型。model_executor/models中的遗留模型定义正在被主动移除,其注册条目也已更新为直接指向transformers建模后端。在没有可被torch编译的层的情况下,这些模型在GPU上的性能将显著退化。
最后,虽然扁平化模型和层将针对前沿GPU进行优化,但我们不期望它们能支持旧版GPU或消费级/专业级GPU。vLLM自身的使用统计显示,大量用户仍在使用此类硬件。我们认为项目也应以满足这些用户需求的方式发展。
- 可编译。模型定义将支持全图 PyTorch 编译;需要编译以实现高性能的加速器可以继续以当前方式使用它。
- 可扩展。我们将保留类似 vLLM 的 CustomOp 和 PluggableLayer 等机制,以确保在必要时 OOT 插件可以覆盖实现。
- 隔离性。模型定义将使用独立于硬件特定路径所使用的层和操作的专用层和操作集。这将确保两个方向的开发可以快速进行而不会相互影响。
- 可移植。我们将努力使用原生 PyTorch 代码或可移植的 DSL(如 Triton 和 Helion)实现所有层和操作。这将使模型能够在支持这些框架的所有加速器上运行。对于不支持的加速器,仍可在必要时依赖(2)。
我们正在推进的设计如下所示:
_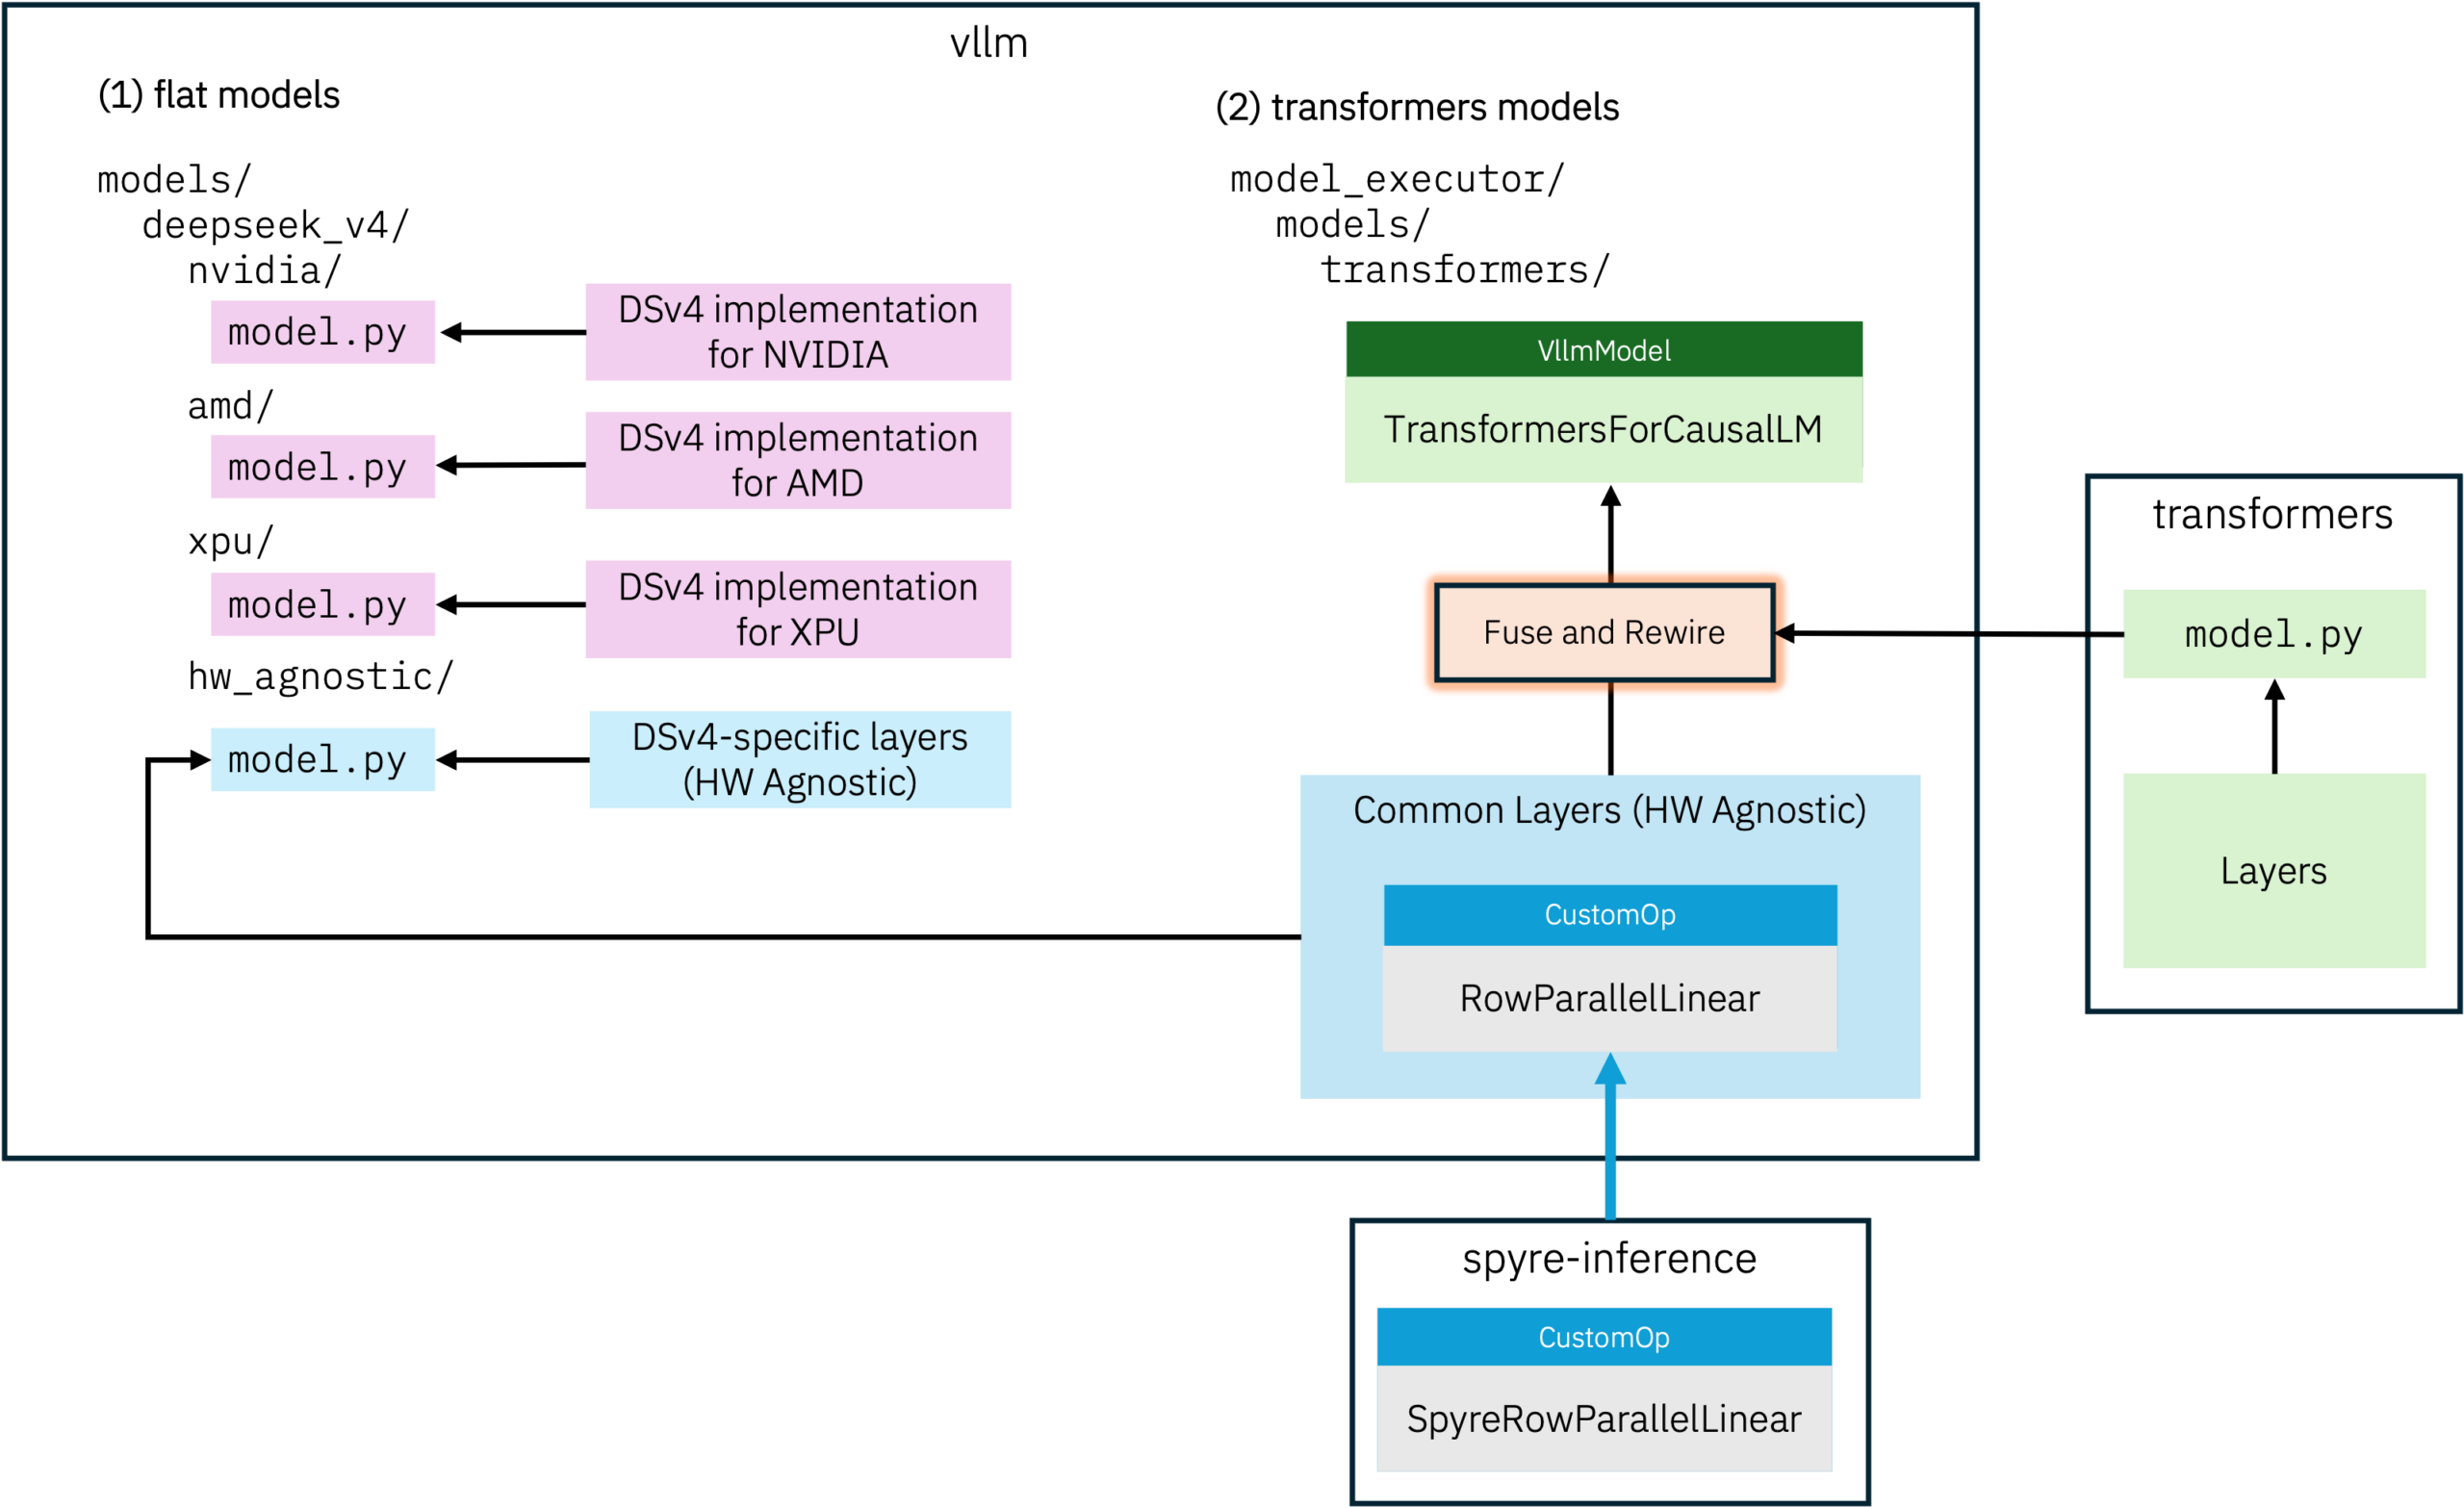_
_图 2:vLLM 中与硬件无关的层。_
随着旧版模型定义逐渐被移除,模型将通过扁平化方式重新实现(例如为 NVIDIA、AMD、XPU 等不同硬件提供不同实现),或回退到 transformers 后端。我们计划在这两种情况下都提供与硬件无关的支持。
对于 transformers 后端,我们已修改“重定向”流程,使其目标为位于 model_executor/hw_agnostic 的新硬件无关层,而非现有层 model_executor/layers。这项支持已合并到 vLLM 主分支(部分层),通过在使用 transformers 后端运行 vLLM 时设置 USE_HW_AGNOSTIC=1 可启用该功能:
USE_HW_AGNOSTIC=1 vllm serve google/gemma-4-31B --model-impl=transformers
我们已使用 Spyre 的 OOT 插件验证了这一新路径,适用于 Gemma 4、Qwen3 和 Granite 4.2 等模型。很快我们将开始在 CI 中包含硬件无关模型,并逐步将其作为在 Spyre 上服务模型的默认路径。
虽然尚未合并,但我们计划为每个扁平化模型提供新的 model.py,使用硬件无关层实现模型。跨多个扁平化模型复用的层将存放在共享位置(model_executor/hw_agnostic),而特定模型的层(如 DeepSeekV4FlashMLAAttention)将与 model.py 存放于本地目录,但仍遵循上述 4 项设计原则。作为示例,请查看目前处于审核中的DeepSeek V4 PR。
但,它在 GPU 上的性能如何?
我们强调,这些模型定义的目标并非在 Blackwell、CDNA 4 及更高级别硬件上实现最先进性能。我们的目标是在包括 OOT 加速器、旧版 GPU 以及专业消费级 GPU 在内的多样化硬件上实现平台和性能的可移植性。
为评估新路径在广泛可用的 GPU 上的表现,我们在 NVIDIA H100 GPU 上对少量近期模型进行了实验。图 3 对比了使用 USE_HW_AGNOSTIC=0 与 USE_HW_AGNOSTIC=1 时 vLLM 的 transformers 后端性能表现。
正如我们所看到的,尽管这些模型完全由底层和操作的可移植实现构建,但与使用FlashAttention和CUTLASS等CUDA优化库的原生模型相比,与硬件无关的模型在性能上表现得相当接近,在某些情况下甚至略胜一筹。
_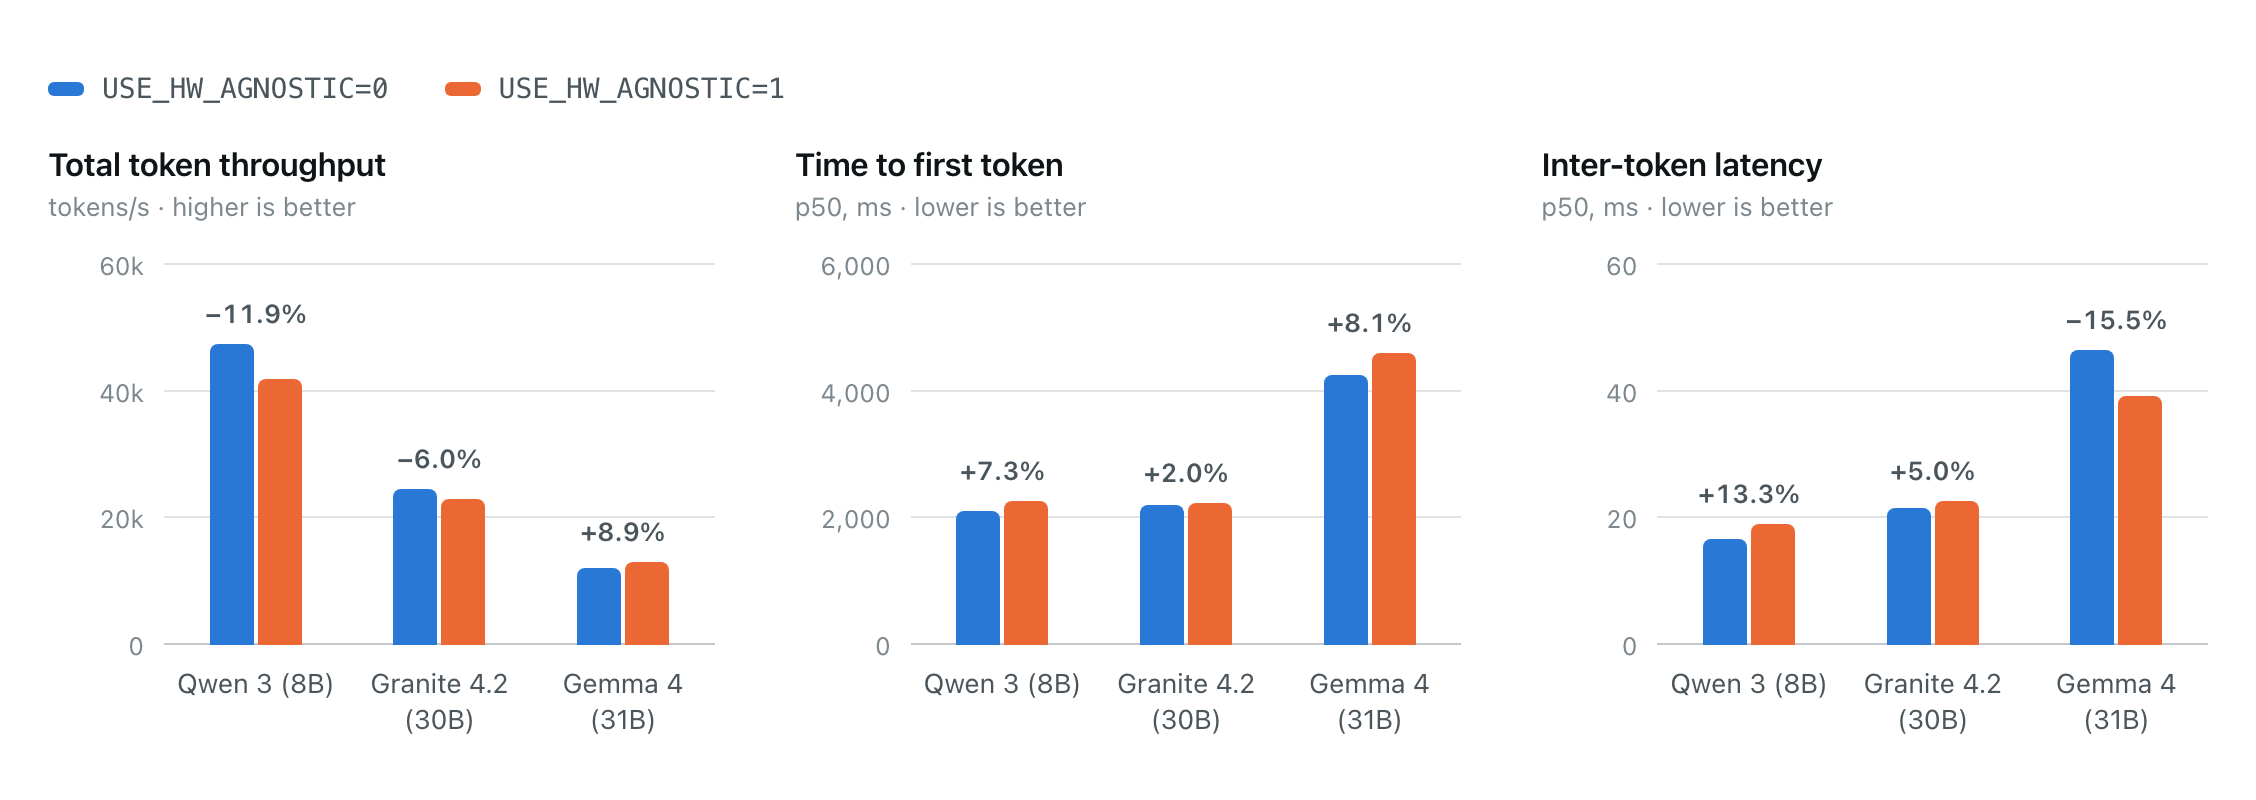_
_图3: 对H100 GPU性能影响的HW无关层。_
结论
我们将HW无关层引入vLLM,以确保该项目能够继续支持多样化的硬件上的多种模型,而不会减缓前沿性能工程的进展。我们认为这一努力对vLLM继续满足更广泛开源生态系统的需求至关重要。虽然我们已经开始提交PR以实现这一目标,但这项工作仍处于进行中,我们欢迎任何反馈。
如需更多信息,请查看RFC或加入vLLM Slack的#hw-agnostic-models频道。您还可以通过vLLM.ai或vLLM github项目页面了解更多信息。