Trustpilot 如何使用 Gemma 构建实时数据增强架构
Google Cloud Blog992 字 (约 4 分钟)
92
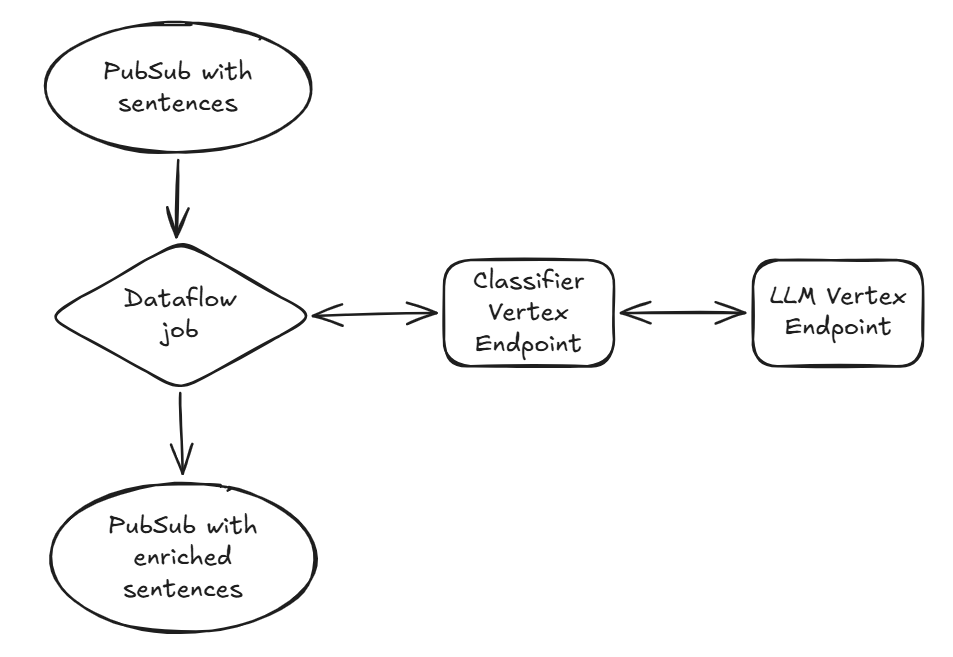
Trustpilot 使用微调的 Gemma 模型构建了实时数据增强架构,处理百万级评论,延迟低、成本可控,性能接近教师模型且独立可控。
入选理由:采用 google/gemma-2-9b 基础模型,通过共识标注生成高质量训练集,微调后准确率仅比教师模型低几个百分点。
精选文章#Gemma#Dataflow#LLM#实时架构#微调英文
产品
别名:高效推理库
高效推理引擎
已跟踪 30 条高相关材料
最近变化
2026-10-17 · Muse Spark Open在AA智能指数达39分,超NVIDIA模型13分
为什么值得关注
vLLM 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
How Trustpilot built a real-time architecture for data enrichment using Gemma
Google Cloud Blog · 9.2 分
Trustpilot 使用微调的 Gemma 模型构建了实时数据增强架构,处理百万级评论,延迟低、成本可控,性能接近教师模型且独立可控。
英伟达重新思考AI TCO:为何每Token成本才是唯一重要的指标
量子位 · 9.2 分
英伟达提出以每Token成本作为AI基础设施的核心经济指标,取代传统的算力成本或每美元FLOPS评估方式,强调全栈优化对降低推理成本、提升商业价值的关键作用。
Build real-time voice applications with Amazon SageMaker AI and vLLM
AWS Machine Learning Blog · 8.7 分
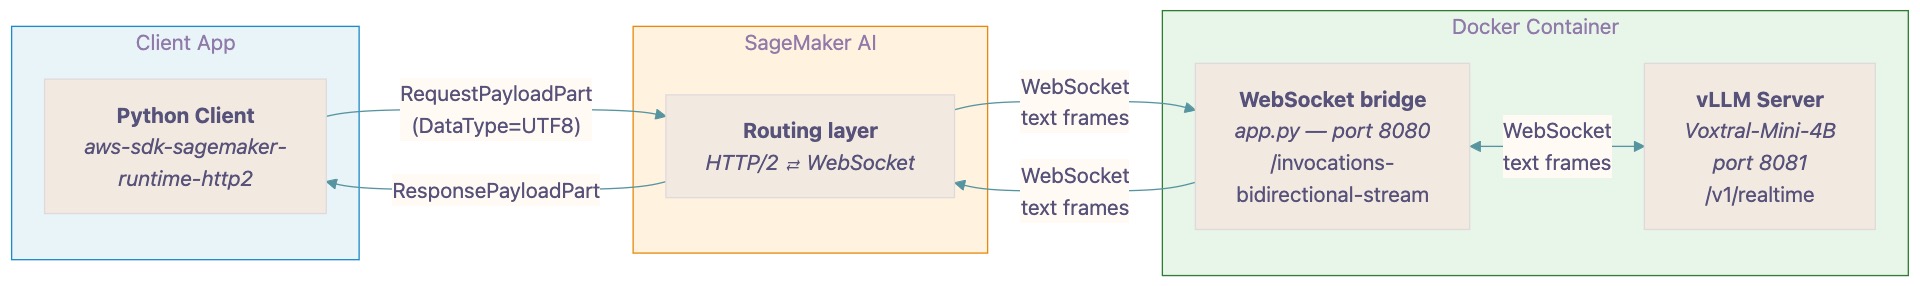
AWS推出SageMaker AI与vLLM结合方案,实现双向流式语音转文本推理,支持实时语音助手、直播字幕等应用,显著降低延迟并消除手工构建流式传输管道的负担。
已收录 30 条与 vLLM 相关的内容,按评分排序。
Trustpilot 使用微调的 Gemma 模型构建了实时数据增强架构,处理百万级评论,延迟低、成本可控,性能接近教师模型且独立可控。
入选理由:采用 google/gemma-2-9b 基础模型,通过共识标注生成高质量训练集,微调后准确率仅比教师模型低几个百分点。
英伟达提出以每Token成本作为AI基础设施的核心经济指标,取代传统的算力成本或每美元FLOPS评估方式,强调全栈优化对降低推理成本、提升商业价值的关键作用。
入选理由:每Token成本是衡量AI基础设施经济效益的核心指标,直接反映实际产出效率。
AWS推出SageMaker AI与vLLM结合方案,实现双向流式语音转文本推理,支持实时语音助手、直播字幕等应用,显著降低延迟。
入选理由:SageMaker AI提供原生HTTP/2双向流式传输(端口8443),自动处理HTTP/2事件流与WebSocket协议转换
Meta发布816B参数Muse Spark Open模型,Reflection Beam 1.0开源,含性能、成本及生态对比分析。
入选理由:Muse Spark Open在AA智能指数达39分,超NVIDIA模型13分
Meta发布816B参数开源模型Muse Spark Open,支持多模态和代理任务,集成Helion内核提升性能。
入选理由:Muse Spark Open拥有816B总参数和1M上下文窗口,专为代码生成优化。
本文推荐了5个LLM推理工程实践项目,涵盖KV缓存、量化、注意力优化等关键技术,适合工程师通过动手学习提升系统性能。
入选理由:构建Mini-vLLM项目可掌握KV缓存和连续批处理机制
Qwen3.8-27B模型通过减少思考令牌将推理时间从90秒缩短至18秒,不同优化方法在效率与准确性间取得平衡。
入选理由:Thinking Cap模型通过减少令牌使用将推理时间从90秒缩短至18秒
Hugging Face发布多Harness RL训练指南,使用代理提升模型性能达12%。开源代码与训练数据可复现结果。
入选理由:使用代理记录token IDs和logprobs可使LFM2.5-2.6B模型性能提升12%
Shopify通过PyTorch和vLLM构建持续学习循环,将生产失败转化为模型权重,提升质量并降低96%服务成本。
入选理由:使用PyTorch和vLLM构建持续学习循环可降低96%服务成本
vLLM引入硬件无关层,在NVIDIA H100上实现接近原生性能,吞吐量差异仅3.4%。
入选理由:HW agnostic层在NVIDIA H100上实现3.4%吞吐量差异(几何平均值)
PyTorch基金会邀请学术项目参与2026北美会议,提供开源生态转型支持,重点扶持具备社区价值的PyTorch相关研究。
入选理由:8个学术项目可获得5分钟闪电演讲机会
Red Hat通过赞助OpenClaw基金会推动生产级AI代理的开源基础设施,解决企业级安全与部署需求。
入选理由:Red Hat通过BYOA策略支持混合云环境中自主代理运行
Cambricon成为PyTorch基金会铂金会员,致力于推动AI芯片与PyTorch生态的深度整合。
入选理由:Cambricon在PyTorch中贡献了torch.compile、Eager Operators等核心模块。
Databricks通过专用GPU内核生成实现极端效率,Proteus系统生成的Qwen 3.5 122B内核比vLLM快1.8–5.2倍。
入选理由:Proteus系统生成的Qwen 3.5 122B内核性能比vLLM提升1.8–5.2倍
AI推理依赖模型权重、推理服务器和GPU协同工作,KV缓存优化可降低延迟和成本。
入选理由:推理服务器(如vLLM)是实现生产级GPU利用率的关键组件
PyTorch 2026北美会议聚焦vLLM在KV缓存优化、硬件适配和生产服务中的技术突破,包含多个开源工具和架构方案。
入选理由:vLLM通过KV Push技术使首token生成时间降低30%
Google Cloud通过vLLM-TPU和GKE实现高精度、可扩展的多模态嵌入推理,支持超长上下文处理。
入选理由:vLLM-TPU集成实现TPU弹性扩展,支持动态调整计算资源。
Ollama、vLLM、SGLang三大模型引擎各具优势:Ollama适合本地开发,vLLM擅长高并发服务,SGLang优化多轮对话,Claude水印技术通过概率筛选实现内容溯源。
入选理由:Ollama适用于本地开发,采用FIFO队列和GGUF压缩模型
开源推理引擎vLLM通过10倍性能优化和跨芯片兼容性,正在重塑AI基础设施,可能缩小与闭源模型的差距。
入选理由:vLLM支持Nvidia/AMD/Google最新芯片,实现跨平台部署
ThunderAgent通过优化KV缓存管理,实现单节点吞吐量提升2倍,集群加速2.4倍,解决代理推理中的缓存抖动问题。
入选理由:单节点吞吐量提升2.5倍,P50延迟降低10倍
开源项目vLLM的商业化与模型基础设施协同设计为AI领域提供了新思路,揭示了开源社区向企业转型的挑战与技术融合路径。
入选理由:vLLM从论文到开源社区耗时3年,社区维护者放弃个人利益坚持开源精神。
在TPU上部署Ray AI库需通过topology字段确保多主机模型正确分配资源,避免因跨slice通信失败导致部署停滞。
入选理由:设置topology字段可防止多主机模型跨slice部署,避免集体通信失败
PyTorch基金会宣布成立多项目基金会,PyTorch 2.13发布显著优化性能,vLLM推出Model Runner V2并公布2026路线图。
入选理由:PyTorch 2.13在Apple Silicon上实现FlexAttention性能提升至SDPA的12倍
开源模型已具备代理应用能力,但API兼容性不足成为生产环境瓶颈,Mozilla提出开源网关Otari解决该问题。
入选理由:开源模型推理能力已满足代理产品需求,但API兼容性仅支持基础聊天功能
自动化数据科学流程的5种代理工作流可节省45%时间,Databricks已集成相关功能,核心依赖ReAct循环与LLM工具。
入选理由:数据科学家45%时间消耗在数据清洗,代理可自动化处理
Hugging Face 提供了一种快速部署 OpenAI 兼容 LLM 的方法,仅需一条命令即可完成。
入选理由:使用 hf jobs run 命令可在 Hugging Face 上一键部署 LLM 服务。
DeepSeek V4 Flash结合vLLM实现大规模代码库分析,支持长上下文和多模式推理。
入选理由:DeepSeek V4 Flash支持百万级token上下文窗口,适用于大规模代码库分析。
多智能体协作显著提升了 Gemma 4 的推理速度,达到 5 倍提升,并展现出自我监管和协作机制。
入选理由:100+ 智能体协作使 Gemma 4 推理速度提升 5 倍。
Google 与 Anyscale 合作优化 Ray Serve LLM 在 GKE 上的性能,实现吞吐量提升 5 倍、延迟降低 8 倍。
入选理由:通过 HAProxy 集成,减少代理开销并提升吞吐量。
本地部署LLM代理需解决推理速度与长会话状态管理问题,通过优化vLLM服务器和结构化世界状态,可将单次调用耗时从15秒降至2秒以内,支持科学工作流的可复现性需求。
入选理由:使用vLLM优化推理性能,单次调用耗时从15秒降至2秒内