RAG正在烧钱——我构建了一层成本控制机制来修复它
RAG系统在生产中常因上下文过取、无缓存、无模型路由导致成本激增;作者构建成本控制层,通过语义缓存(98.5%命中率)、查询路由(81%请求转向低成本模型)与令牌预算熔断机制,在10,000请求/日下实现85.8%成本削减且质量不变。
入选理由:上下文过取使每查询平均多消耗350 tokens,10k请求/日造成$52.5/日浪费(按$0.015/1K tokens计)
概念
也叫:Retrieval-Augmented Generation
检索增强生成技术
最近变化
2026-10-20 · 持续预训练使模型领域知识提升3倍(C3 AI案例中从11%到60%)
RAG 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
RAG Is Burning Money — I Built a Cost Control Layer to Fix It
Towards Data Science · 9.2 分
Enterprise Document Intelligence: A Series on Building RAG Brick by Brick, from Minimal to Corpus scale
Towards Data Science · 9.2 分
Most people use vector databases for chatbots and RAG pipelines. 𝗦𝗲𝗻𝗾𝗶 𝗔𝗜 𝘂𝘀𝗲𝘀 ...
Milvus(@milvusio) · 9.2 分
已收录 30 篇与「RAG」相关的 AI 资讯和分析。
RAG系统在生产中常因上下文过取、无缓存、无模型路由导致成本激增;作者构建成本控制层,通过语义缓存(98.5%命中率)、查询路由(81%请求转向低成本模型)与令牌预算熔断机制,在10,000请求/日下实现85.8%成本削减且质量不变。
入选理由:上下文过取使每查询平均多消耗350 tokens,10k请求/日造成$52.5/日浪费(按$0.015/1K tokens计)
企业级RAG系统应聚焦文档理解与业务逻辑,而非堆叠模型和框架。简单的Python脚本往往比复杂生产系统更有效。
入选理由:多数企业RAG部署效果不佳,因基础解析和检索质量差。
Senqi AI 使用 Milvus 向物理机器人注入长期语义记忆能力,解决真实世界任务中环境动态、任务无界、指令模糊和错误高成本等核心挑战。
入选理由:物理机器人Agent需实时重规划,因环境持续变化且任务无明确终点
RAG 技术并非万能,应根据文档结构和问题控制程度选择合适方法:模板化文档用正则表达式,客服对话需 LLM 判断语调,工程图纸必须使用视觉模型。
入选理由:模板化文档(如保险单、银行流水)适合用正则表达式提取字段,避免使用高成本的 RAG 流程。
RAG 不是机器学习,使用 ML 工具包解决的是错误问题。文章指出,尽管 RAG 看似类似 ML,但其核心是构建搜索系统而非训练模型,因此超参数调优、嵌入模型微调等 ML 方法无法解决 RAG 的真实故障,反而导致资源浪费和信任下降。
入选理由:RAG 解决的是确定性答案查找问题,而非预测未知结果,因此不能用 ML 方法优化。
Proxy-Pointer RAG 通过保留文档结构上下文,将知识图谱实体与关系匹配的计算成本降低 90% 以上,实现高效、低延迟的图谱入管,解决了大规模知识图谱的语义蔓延问题。
入选理由:Proxy-Pointer RAG 使用 Skeleton Tree 和 Breadcrumb Injection 技术,使向量检索能精准定位文档完整结构段,而非碎片化块。
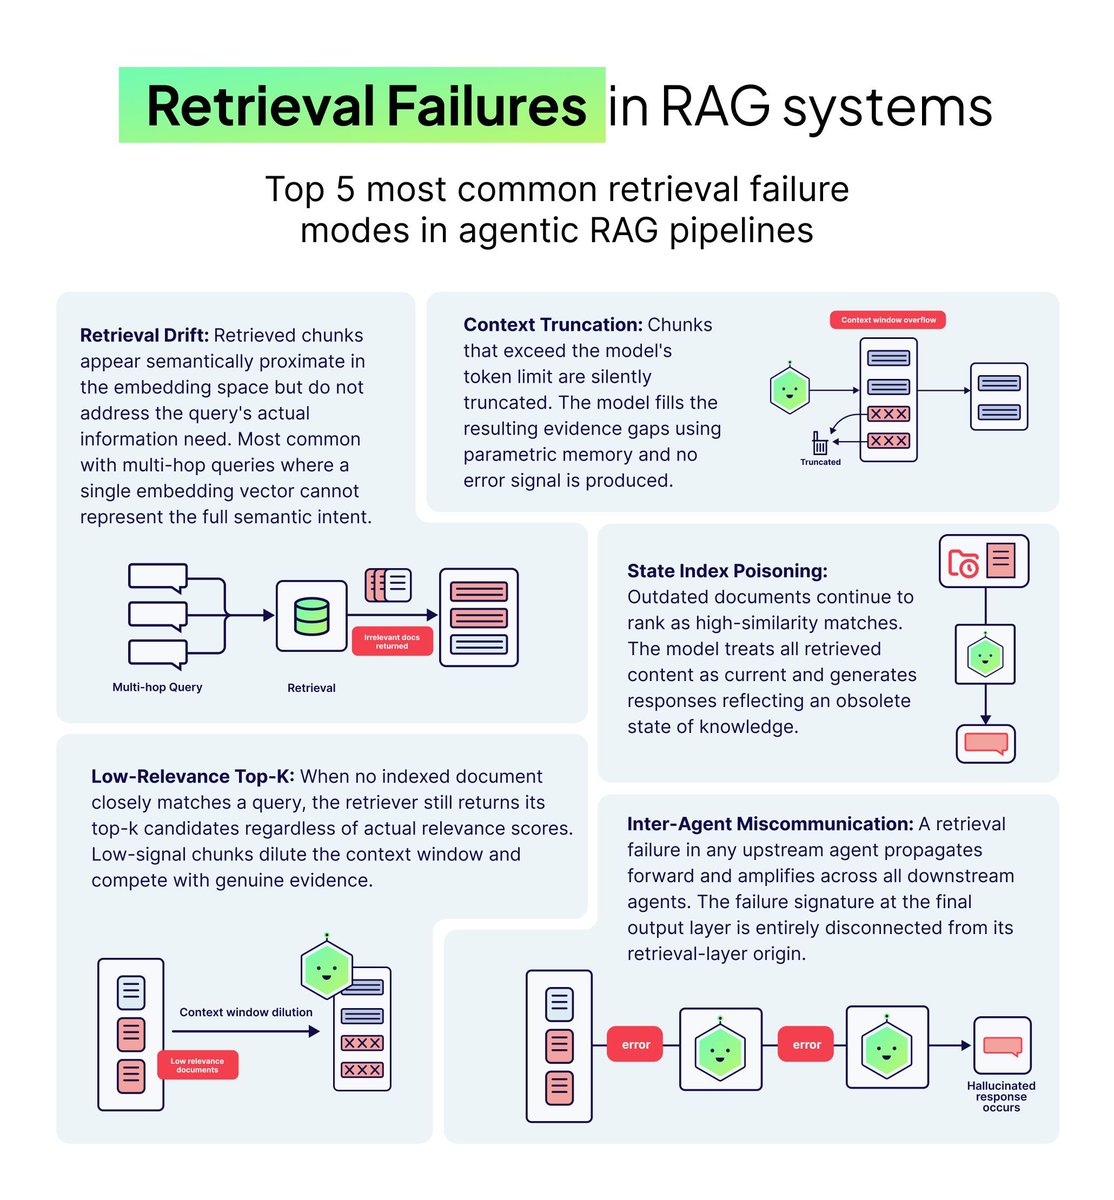
研究发现,RAG系统中检索质量差是导致高流畅性幻觉(更自信但更错误)的主因,模型升级无法弥补检索缺陷。
入选理由:检索质量差是RAG输出退化的最主要预测指标,模型能力增强反而加剧幻觉可信度。
企业自研模型时,持续预训练和模型工厂构建比单一模型优化更重要。多家企业通过混合训练策略实现领域知识深度适配。
入选理由:持续预训练使模型领域知识提升3倍(C3 AI案例中从11%到60%)
DeepSeek 推出自研搜索 API,支持多语言及 SEO 优化,日均处理数亿次查询。
入选理由:DeepSeek 搜索 API 日均处理数亿次查询,支持多语言检索
词嵌入通过向量空间中的几何关系捕捉词语间的语义关联,是NLP中实现语义理解的关键技术。
入选理由:词嵌入将词语映射为向量,通过向量距离反映语义相似性
Uber通过四次架构演进,将法务红线Agent准确率提升至91%,合同审核时间下降20%+,实现AI与律师协同的法律审核系统。
入选理由:第二版引入指数衰减加权(半衰期365天)对抗策略漂移
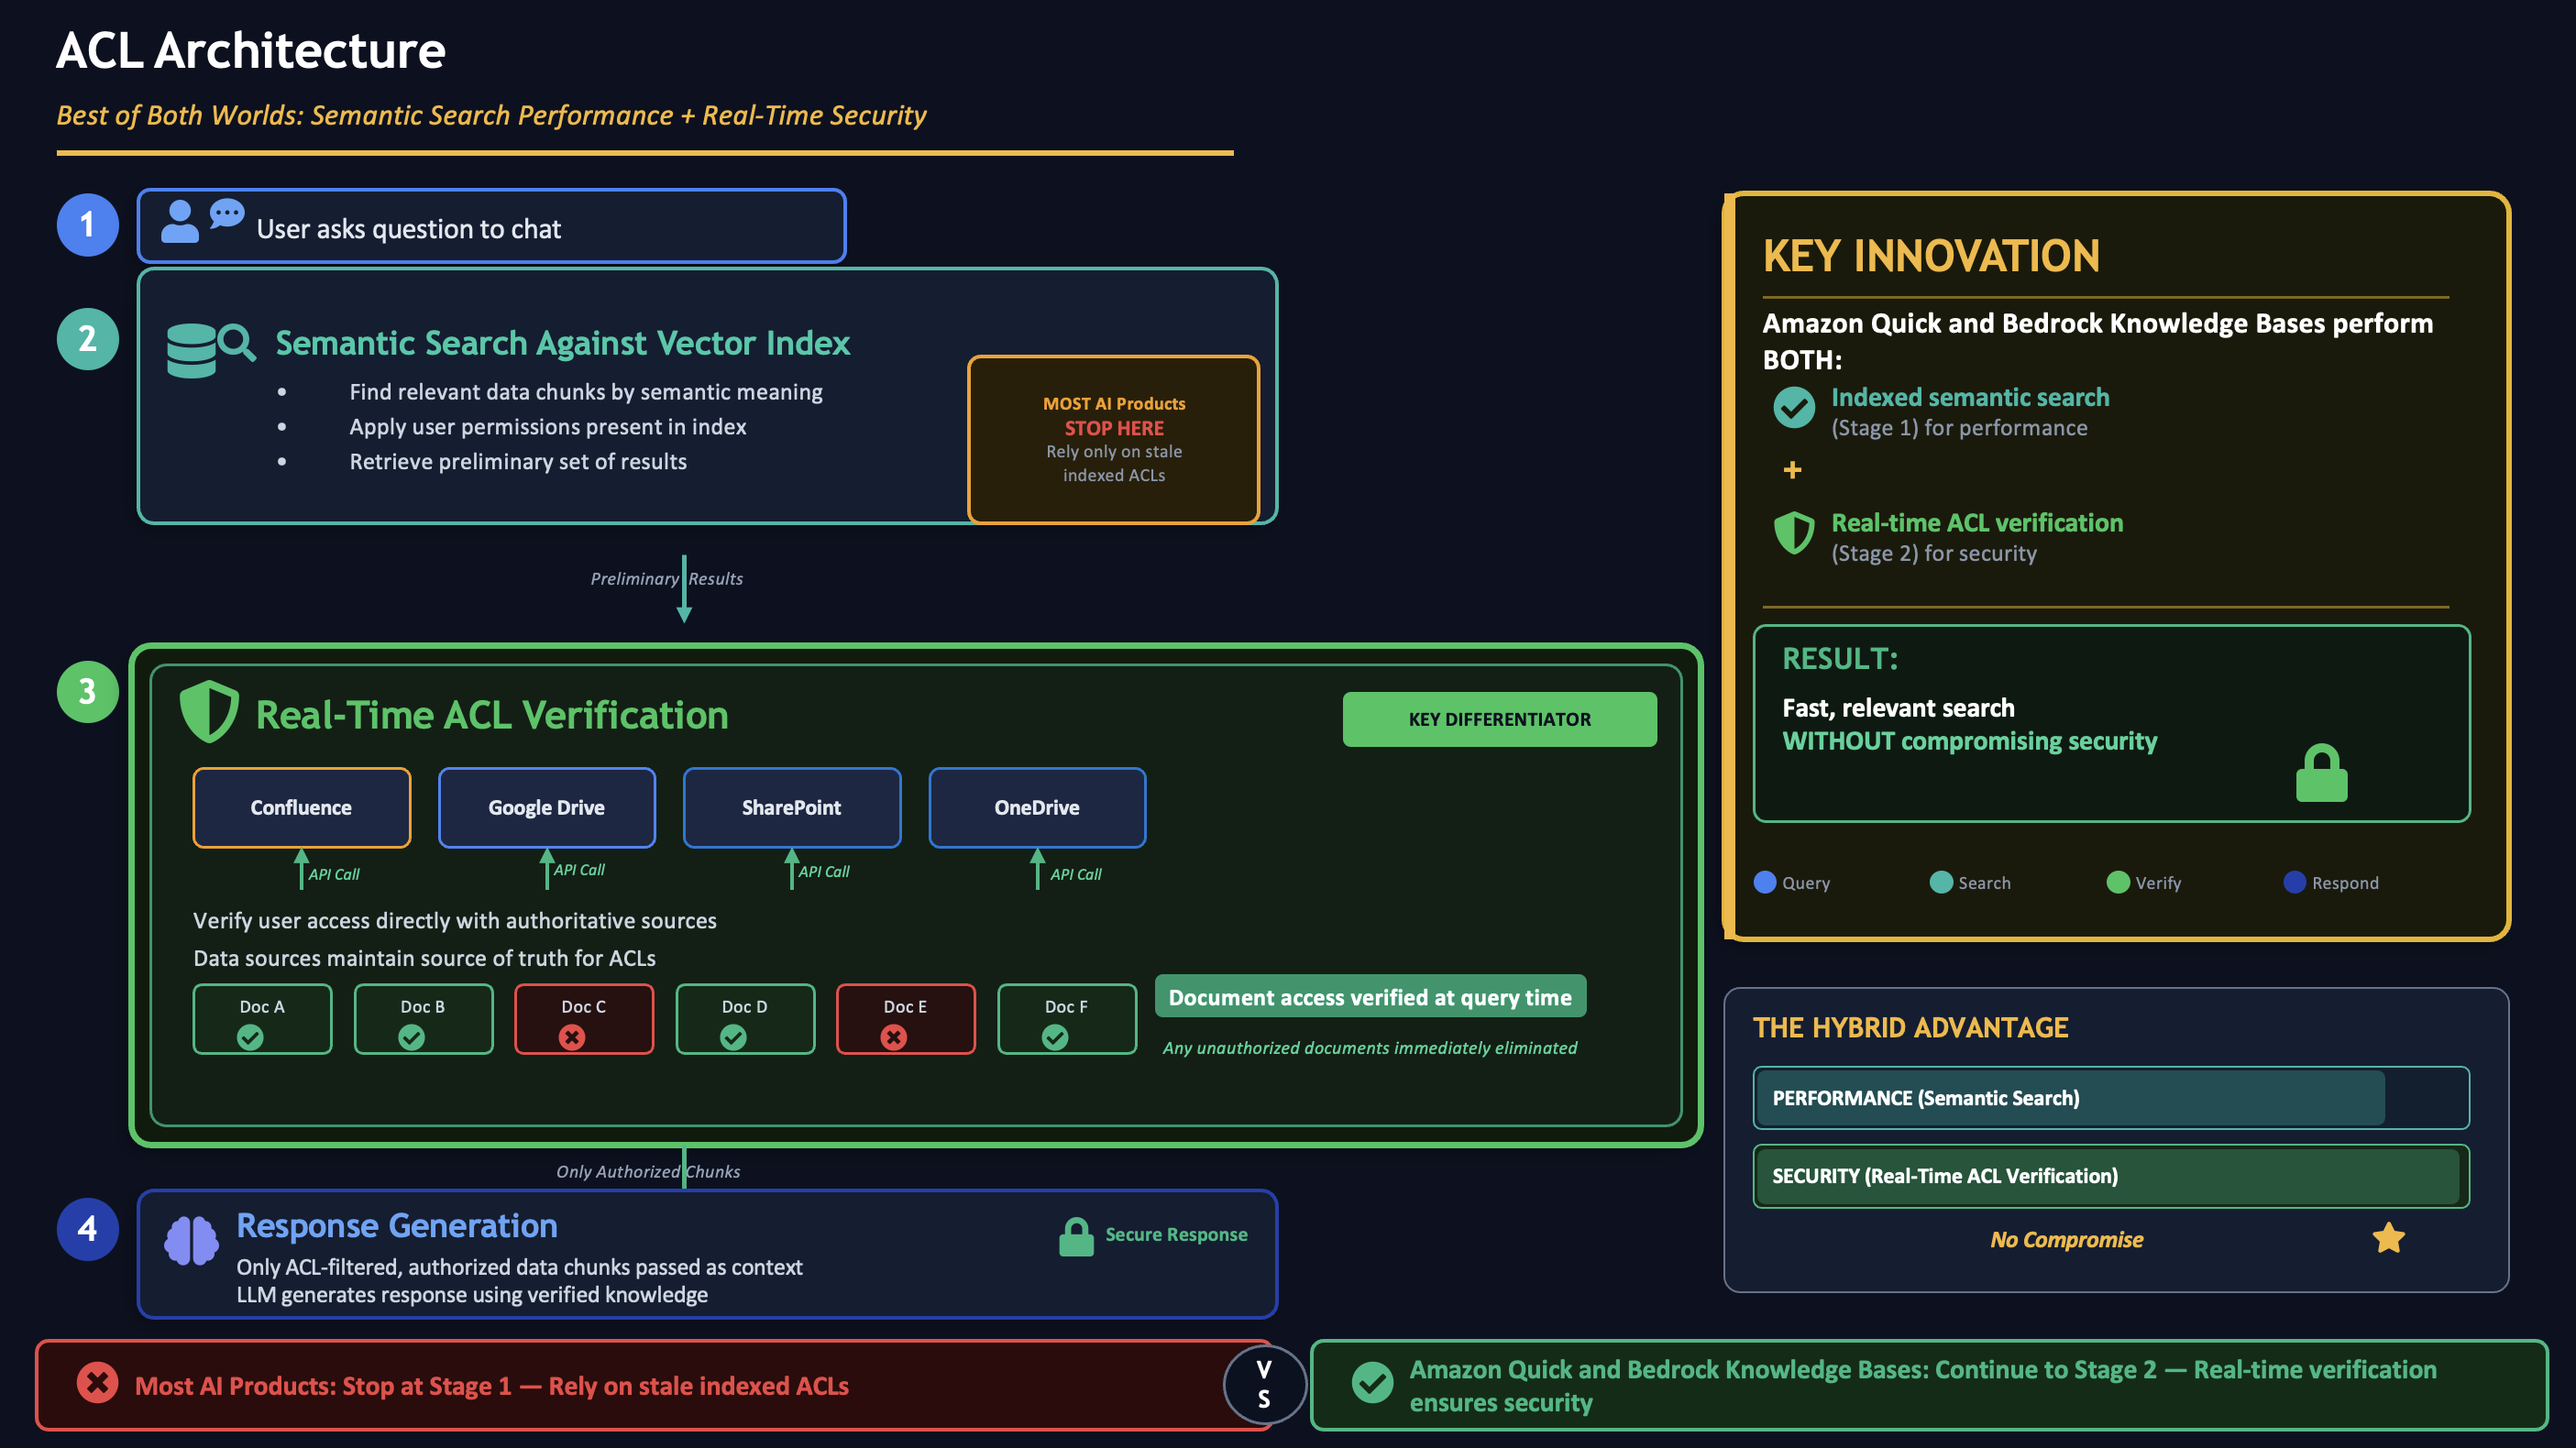
AWS提出通过实时ACL验证解决RAG访问控制难题,确保AI生成内容符合企业权限策略。
入选理由:现有RAG方案依赖定期同步的ACL,存在权限过期风险
同步和异步代理执行模式各有优劣,选择需基于任务复杂度、延迟容忍度和基础设施需求,异步模式更适合长流程任务。
入选理由:同步模式受AWS API Gateway 29秒超时限制,复杂任务易导致连接中断。
DH2i与Red Hat合作,通过三个产品在Red Hat OpenShift上提供安全、弹性的AI解决方案,解决生产环境数据可用性与安全挑战。
入选理由:DxOperator自动化SQL Server高可用性,保障RAG应用持续运行
Jev模型凭借100倍于前沿LLM的性能优势,适合处理决策类任务而非生成任务,适用于模型路由、安全防护等9大场景。
入选理由:Jev模型性能是前沿LLM的100倍,适合处理实时决策任务
混合搜索结合BM25、SPLADE和dense embeddings在金融文档检索中展现优势,Qdrant通过47份SEC文件验证了不同方法的适用场景。
入选理由:BM25在精确关键词匹配上优于dense embeddings(SPLADE)
Jev在重排序任务中表现优于qwen3.7-text-rerank,但延迟和成本显著更高,适合离线场景而非实时RAG。
入选理由:Jev的nDCG@10提升0.0778,但延迟是qwen的10.2倍
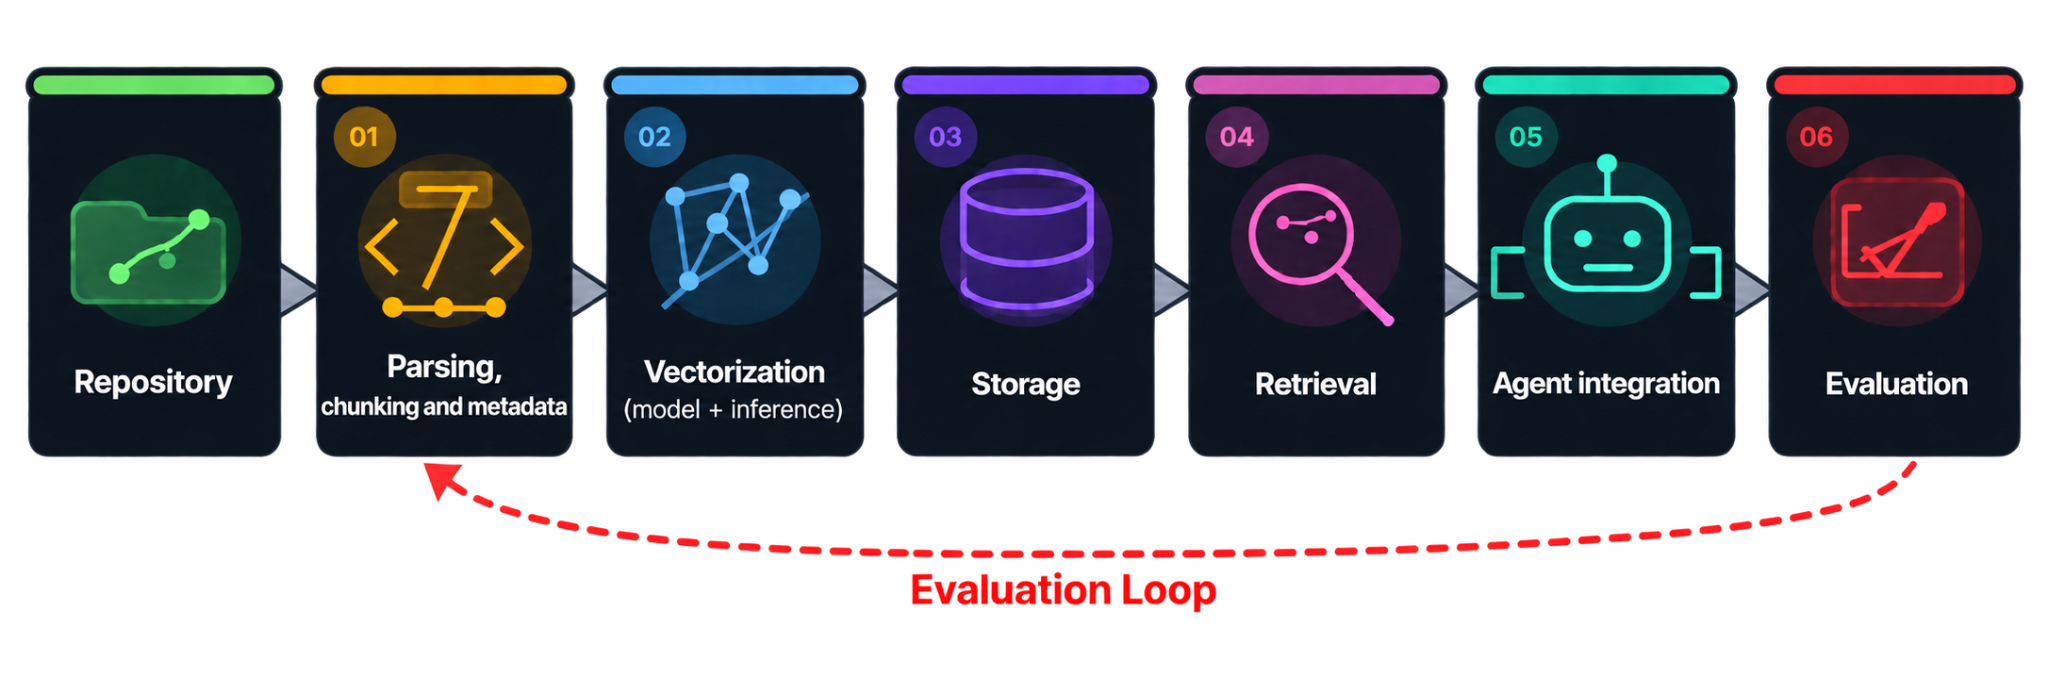
JetBrains分享了构建RAG管道进行语义代码搜索的实践经验,涵盖解析、分块、向量化等关键步骤,揭示生产环境中的技术挑战与优化策略。
入选理由:代码解析与分块是RAG管道的基础,需处理多语言语法差异
下一代智能企业系统需结合混合检索、多代理系统与自适应学习,以解决RAG在复杂场景下的局限性。
入选理由:混合检索结合向量搜索和BM25,解决企业场景下的术语差异和精确匹配问题。
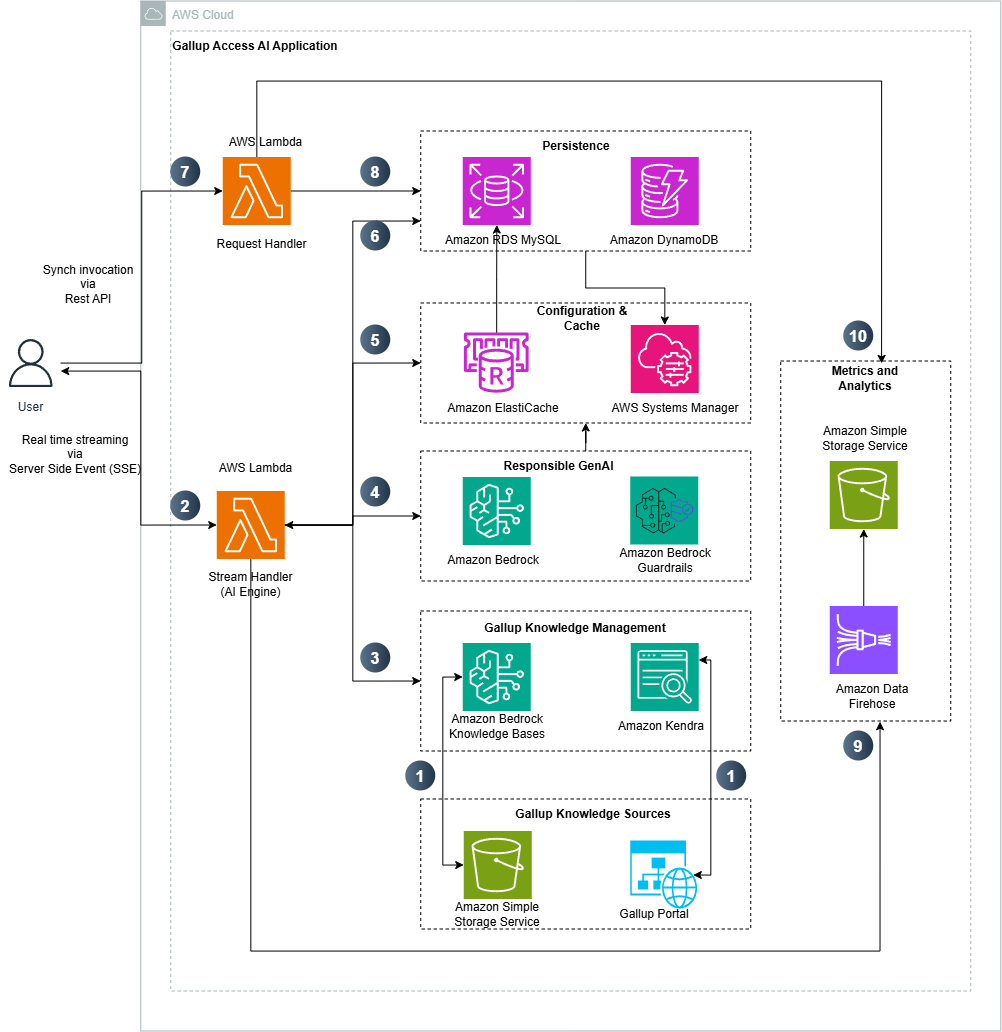
Gallup利用Amazon Bedrock构建AI助手,实现实时个性化职场指导,整合Claude模型与RAG技术,7天完成生产级部署。
入选理由:Amazon Bedrock Knowledge Bases实现RAG,确保回答基于验证研究
RAG系统的性能高度依赖嵌入模型质量,选择合适的嵌入模型是构建有效RAG系统的关键。
入选理由:嵌入模型决定RAG系统搜索准确性,错误嵌入会导致错误答案
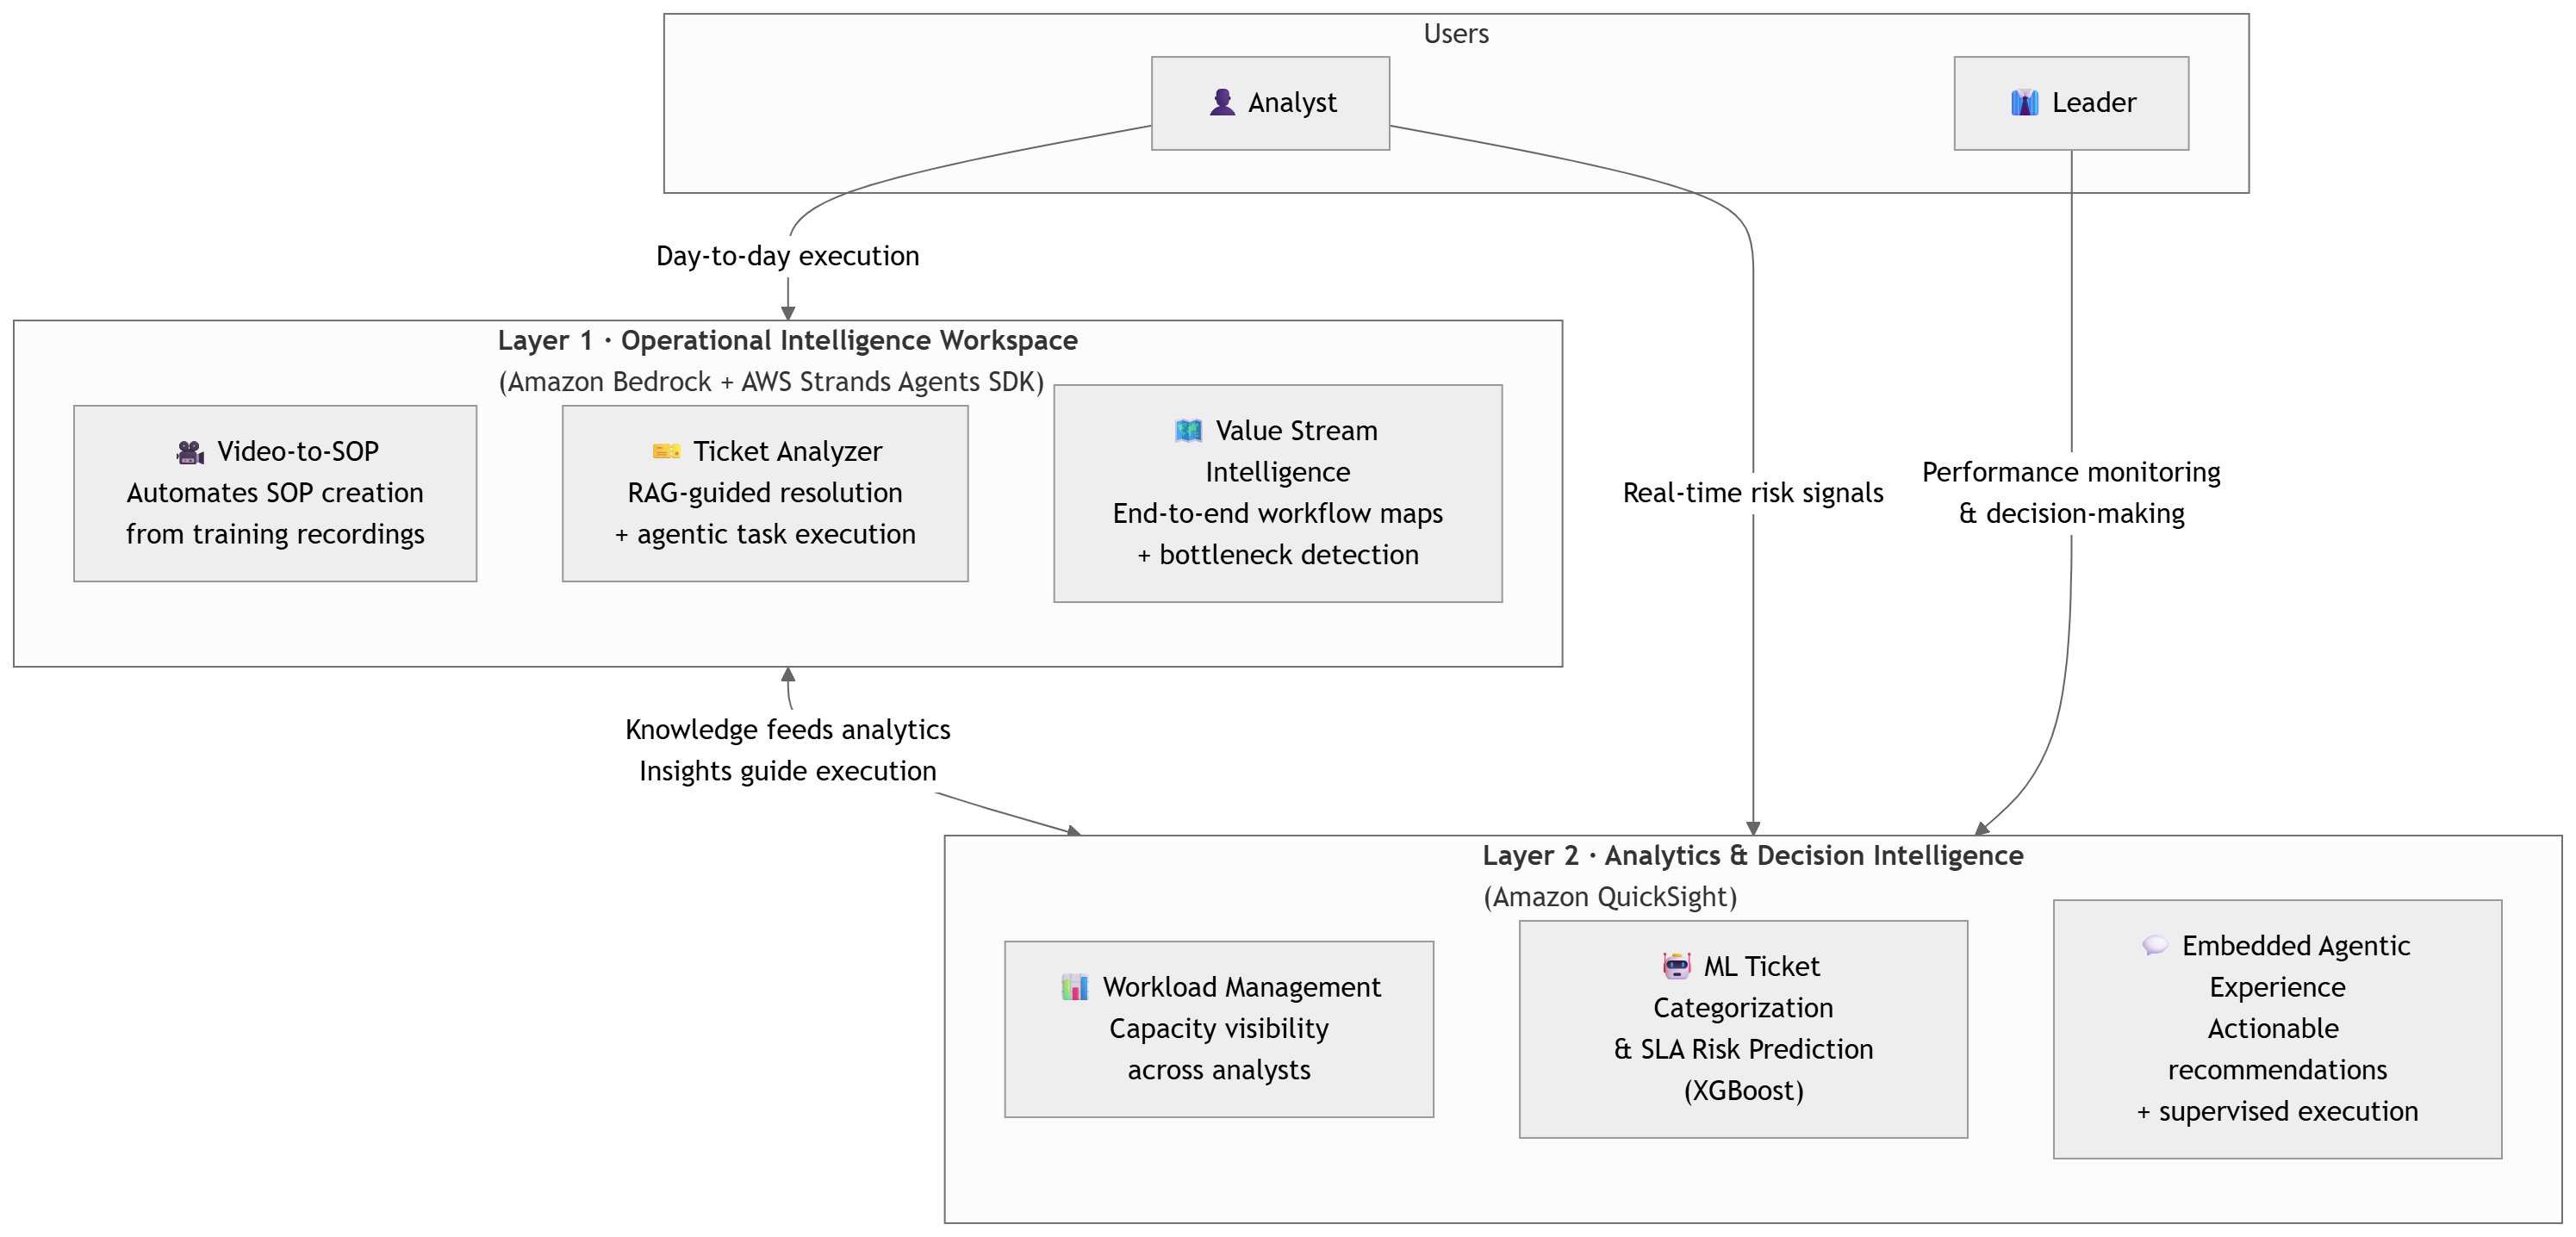
AWS通过生成式AI重构支持运营,实现SOP自动化与SLA风险预测,提升效率30%以上。
入选理由:RAG技术使票务处理效率提升40%,缩短问题解决时间50%
企业级AI部署需权衡托管API与自托管模型,Red Hat提供集成解决方案。
入选理由:托管API降低运维成本但可能增加长期费用
Weaviate提出Late Interaction RAG方法,通过多向量模型直接解析PDF图表,解决传统RAG无法提取图表信息的缺陷。
入选理由:传统RAG处理PDF图表时,30%的查询会因图表信息缺失导致错误
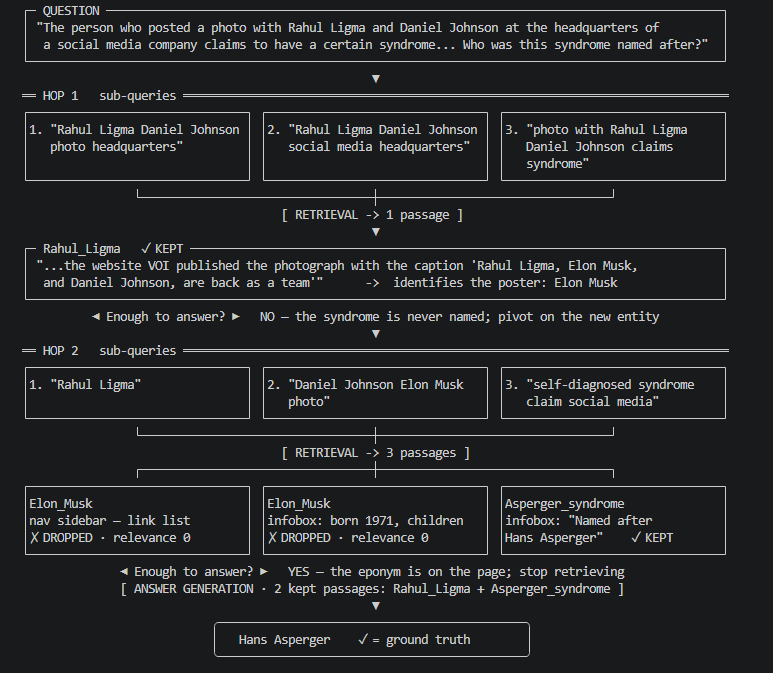
MLPerf推出首个端到端RAG推理基准,覆盖向量数据库构建与多跳问答流程,揭示多模型协作优化空间。
入选理由:RAG系统需多模型协作,单模型基准无法衡量其迭代推理行为
编写有效代理指令的8个技巧,涵盖流程图设计、明确目标、工具整合等关键点。
入选理由:使用流程图工具(如Mermaid.js)可视化业务流程可提升团队协作效率
RAG架构的复杂性应在检索失败模式被验证后逐步引入,而非默认采用。传统检索方法在特定场景下表现优异,过度复杂化可能掩盖基础问题。
入选理由:优先评估基础检索子系统,再引入复杂技术如重排序或代理系统。
将FAQ作为RAG知识库可显著优化生成成本并提升检索效率,通过结构化设计实现解析简化与缓存复用。
入选理由:FAQ结构使RAG解析步骤复杂度降低70%
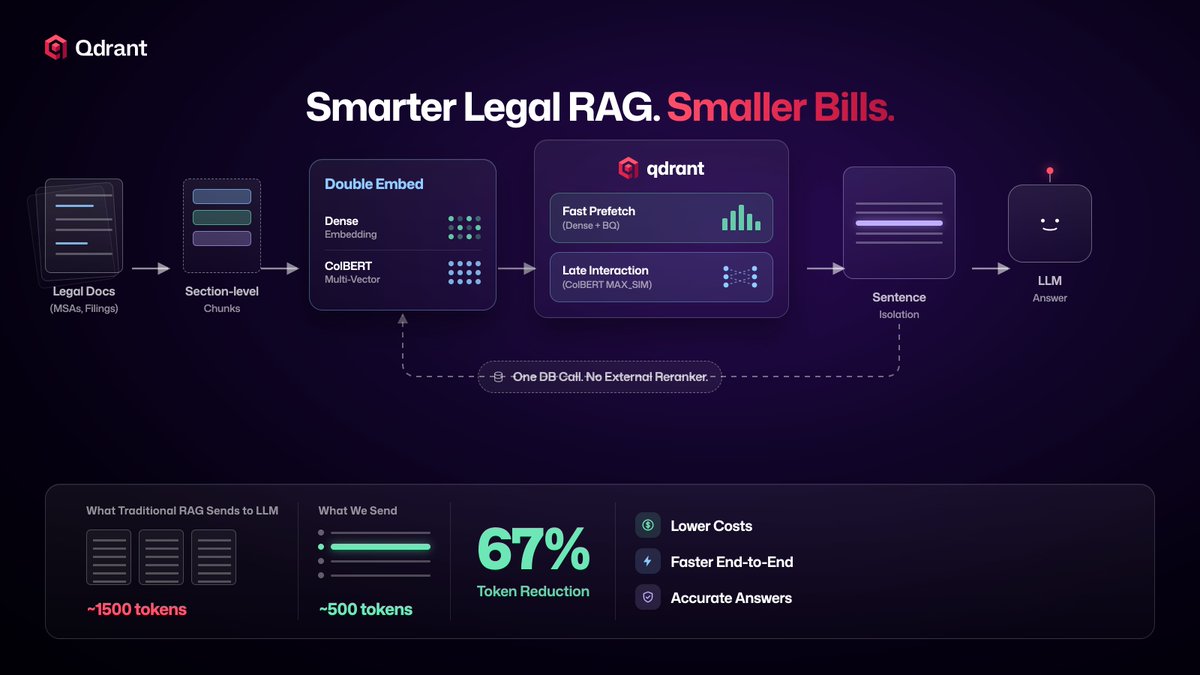
通过结合ColBERT重排序、二进制量化和句子级检索,Qdrant将RAG的token成本降低了67.1%。
入选理由:Qdrant的ColBERT重排序可减少67.1%的输入token
可靠代理式RAG需控制信息到达模型的方式,而非单纯优化提示词。Weaviate提出上下文工程的五大系统框架。
入选理由:查询增强需重构用户输入以提升检索精度
与「RAG」经常一起出现的 AI 术语。
💡 想追踪「RAG」的长期趋势?去 实体雷达 · RAG 查看详细分析和跨材料问答。