Read the technical blog for the five guidelines: https://t.co/HaXwdiTYYB
NVIDIA 技术博客提出通过 Speculative Decoding 优化大模型推理的五项指南,可使推理速度提升 2-5 倍。
入选理由:Speculative Decoding 技术可使 LLM 推理速度提升 2-5 倍
公司
别名:英伟达
图形处理器制造商,计划收购Hugging Face
已跟踪 30 条高相关材料
最近变化
2026-09-05 · Nemotron模型在IOI 2026中获得535.4分,超过人类最高分。
为什么值得关注
NVIDIA 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
Congrats to our researchers for exceeding the gold medal threshold on the International Olympiad in ...
NVIDIA AI(@NVIDIAAI) · 8.5 分
NVIDIA的Nemotron模型在IOI 2026竞赛中以535.4分超越人类顶尖选手,但文章未深入技术细节。
Read the technical blog for the five guidelines: https://t.co/HaXwdiTYYB
NVIDIA AI(@NVIDIAAI) · 8.5 分
NVIDIA 技术博客提出通过 Speculative Decoding 优化大模型推理的五项指南,可使推理速度提升 2-5 倍。
Helix gives each coding agent its own desktop. On a Mac that desktop is not its own GPU. One QEMU VM. One physical GPU. Each agent gets a virtual output through virtio-gpu. Helix’s own blog says one desktop is fine, two are fine, and deadlocks show up at 4+ sessions on that GPU. On Linux plus NVIDIA it is different: real per-session containers and hardware encode. Isolated screen. Shared silicon. At least on Apple Silicon.
Robert Youssef(@rryssf) · 8.5 分
Helix为每个编码代理分配独立桌面,但Mac上共享物理GPU可能导致4个以上会话死锁,Linux+NVIDIA实现更彻底的资源隔离。
已收录 30 条与 NVIDIA 相关的内容,按评分排序。
NVIDIA 技术博客提出通过 Speculative Decoding 优化大模型推理的五项指南,可使推理速度提升 2-5 倍。
入选理由:Speculative Decoding 技术可使 LLM 推理速度提升 2-5 倍
NVIDIA的Nemotron模型在IOI 2026竞赛中以535.4分超越人类顶尖选手,但文章未深入技术细节。
入选理由:Nemotron模型在IOI 2026中获得535.4分,超过人类最高分。
OpenAI发布自研Jalapeno芯片性能超NVIDIA 104倍,同时NVIDIA被曝收购Hugging Face,AI芯片与开源生态竞争加剧。
入选理由:OpenAI Jalapeno芯片在推理任务上实现NVIDIA 104倍性能提升
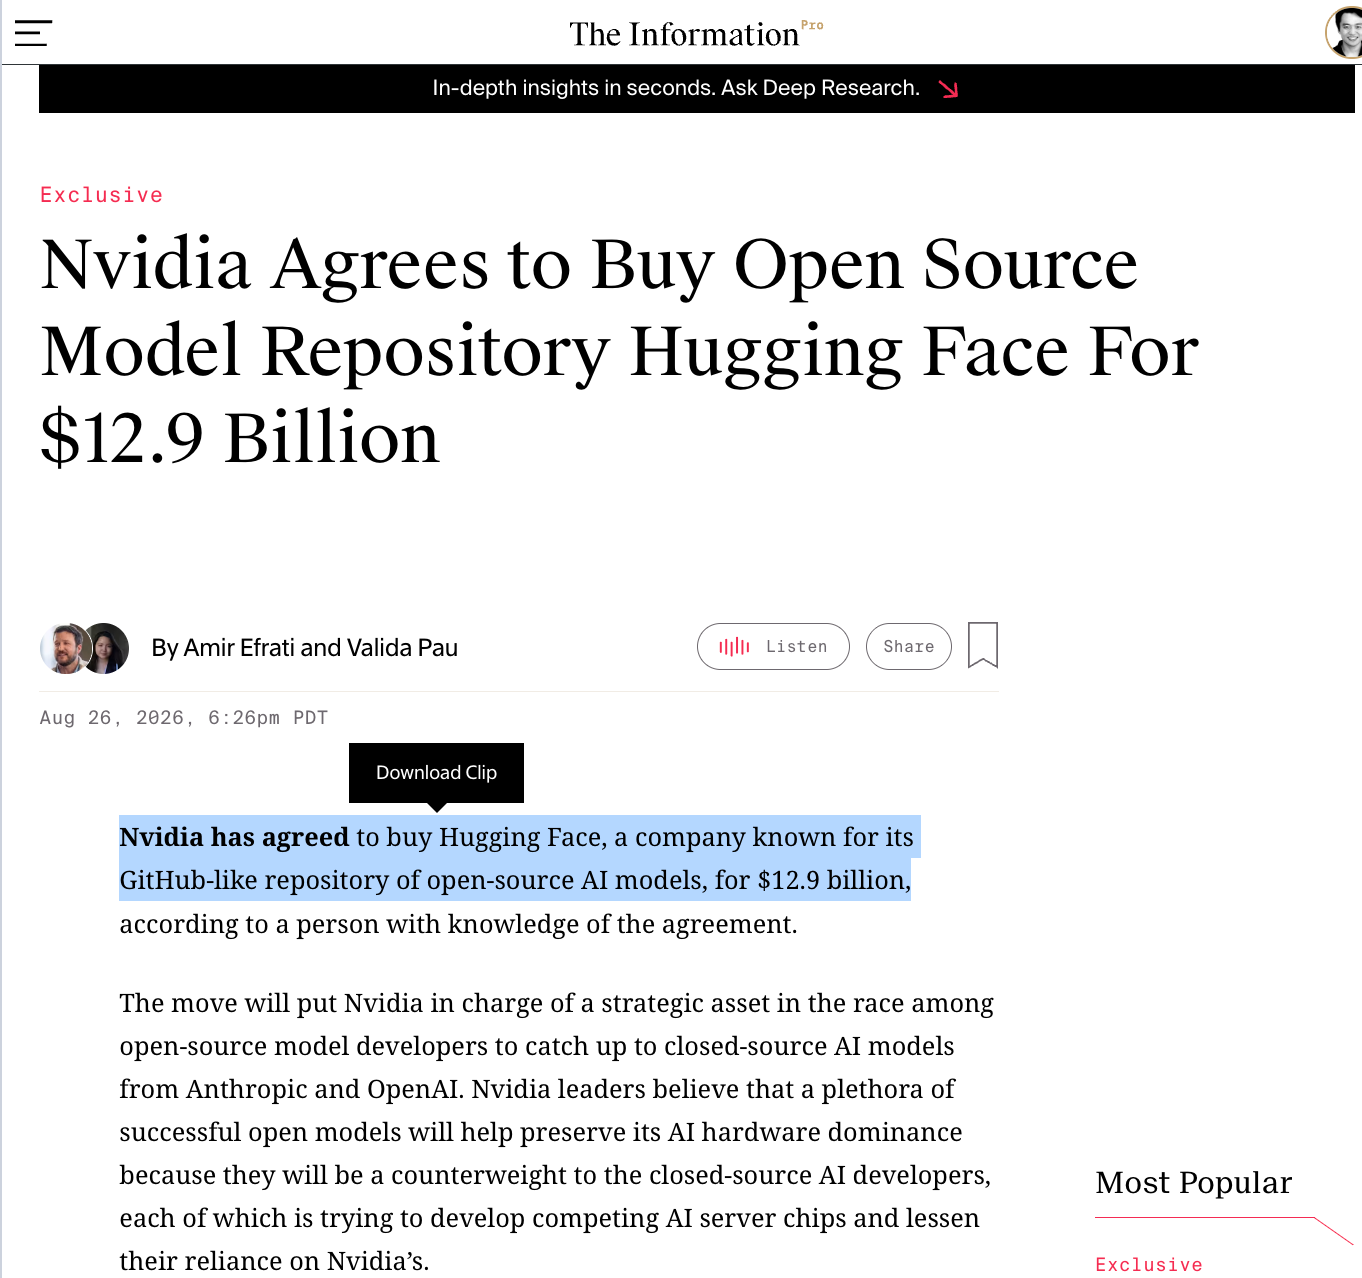
Hugging Face宣布以129亿美元被NVIDIA收购,旨在推动开源AI成为AI开发的主流方式。
入选理由:NVIDIA将投入129亿美元收购Hugging Face以加速开源AI发展
Helix为每个编码代理分配独立桌面,但Mac上共享物理GPU可能导致4个以上会话死锁,Linux+NVIDIA实现更彻底的资源隔离。
入选理由:Mac上4个以上Helix会话可能因共享GPU导致死锁
人类识别AI生成文本能力有限,NVIDIA的AVO工具在长期任务中表现良好,AI正在重塑CI流程假设。
入选理由:2025年研究显示人类识别AI文本准确率仅57%-64%
Weaviate提出Late Interaction RAG方法,通过多向量模型直接解析PDF图表,解决传统RAG无法提取图表信息的缺陷。
入选理由:传统RAG处理PDF图表时,30%的查询会因图表信息缺失导致错误
AI需求激增导致计算供应不足,可能引发AI泡沫或短缺,需关注NVIDIA等关键企业的角色。
入选理由:AI基础设施投资回报周期短至6-12个月,加速行业扩张
触觉感知在机器人领域被严重忽视,T-Rex方法通过异步双时钟架构和开放数据集提升触觉学习效果。
入选理由:T-Rex采用异步双时钟架构,触觉专家以4Hz频率实时修正视觉专家动作
MLPerf Client v2.0新增图像生成和智能代理AI基准,提升PC端AI性能评估。
入选理由:新增图像生成基准采用Flux.2 klein 4B实验模型
NVIDIA推出的Switchyard库通过动态路由模型选择,优化代理性能,减少资源浪费。
入选理由:Switchyard库可动态选择模型,提升代理效率。
NVIDIA推出的NeMo Tron 3.5 Lightning模型专为代理执行层优化,实现4倍吞吐量,显著降低推理成本。
入选理由:NeMo Tron 3.5 Lightning是NVIDIA推出的30B参数MoE模型,专为执行层任务设计
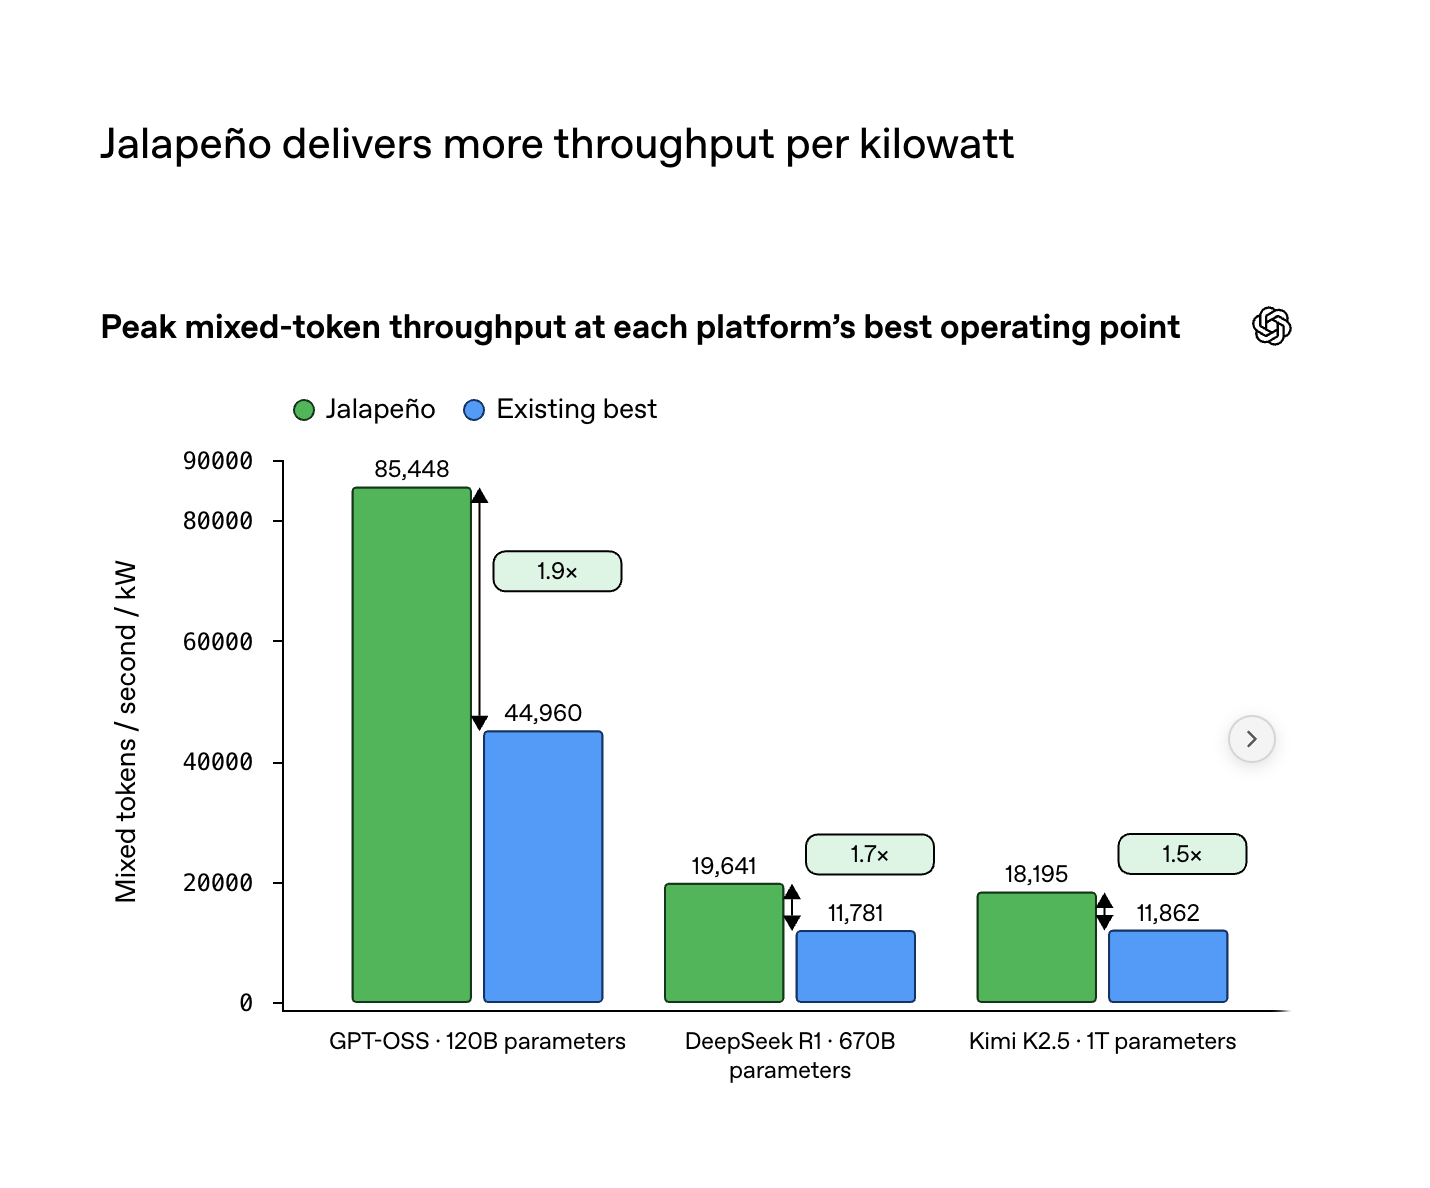
OpenAI的Jalapeño芯片在能效和延迟方面显著优于现有系统,预计年底部署。
入选理由:Jalapeño芯片实现1.5-1.9倍能效提升,端到端延迟降低1.7-3.6倍
NVIDIA以130亿美元收购HuggingFace,同时Z.ai发布GLM-5.3-Flash模型,参数达320B,支持1M上下文窗口。
入选理由:NVIDIA收购HuggingFace交易金额达130亿美元,为后者估值80倍。
NVIDIA Dynamo的Shadow engine recovery功能可在LLM引擎崩溃后7.3秒内恢复,比冷启动快39倍。
入选理由:Shadow engine recovery使LLM引擎恢复时间从冷启动的数分钟缩短至7.3秒
NVIDIA发布AI代理安全扫描工具,同时推荐四个GitHub趋势项目,涵盖写作优化、CRM集成、视频编辑和开源替代方案。
入选理由:NVIDIA工具可提前扫描AI代理技能的安全风险
本文推荐了五个GitHub开源项目,帮助开发者提升AI写作质量、提高效率并实现盈利。
入选理由:No AI Slop Skill可消除AI写作的公式化问题
腾讯Hy4-preview模型在vLLM框架上成功运行,验证于NVIDIA GPU,具备高参数量和高效路由机制。
入选理由:Hy4-preview模型总参数770B,活跃参数49B,采用256个路由专家架构
Groq宣布完成3.5亿美元A轮融资,估值达35亿美元,计划扩展AI推理云基础设施。
入选理由:Groq融资3.5亿美元,估值达35亿美元
本文是科技行业动态汇总,涵盖苹果管理层更替、AI模型发布及科技公司收购等事件,但缺乏技术深度和实用价值。
入选理由:英伟达计划以129亿美元收购Hugging Face
Naval推荐的AI播客聚焦推理技术全栈解析,但原文未提供具体技术细节。
入选理由:Neil Movva拥有Nvidia GPU研发背景,擅长推理技术全栈分析
推文宣布部分封闭AI服务中断,但未提供技术细节或解决方案,信息量有限。
入选理由:封闭AI服务出现中断但未说明原因
文章提及Nvidia与Hugging Face交易中隐藏的复活节彩蛋,但未提供技术细节或分析,信息密度不足。
入选理由:Nvidia与Hugging Face交易金额达129.303亿美元
推文讨论开放模型对安全和创新的影响,但缺乏技术细节与论证,信息密度不足。
入选理由:开放模型可提升安全性和创新扩散
文章内容不完整且缺乏技术细节,未提供实质性工程实践或技术原理分析。
入选理由:文章未披露Apple和OpenAI硬件更新的具体技术参数
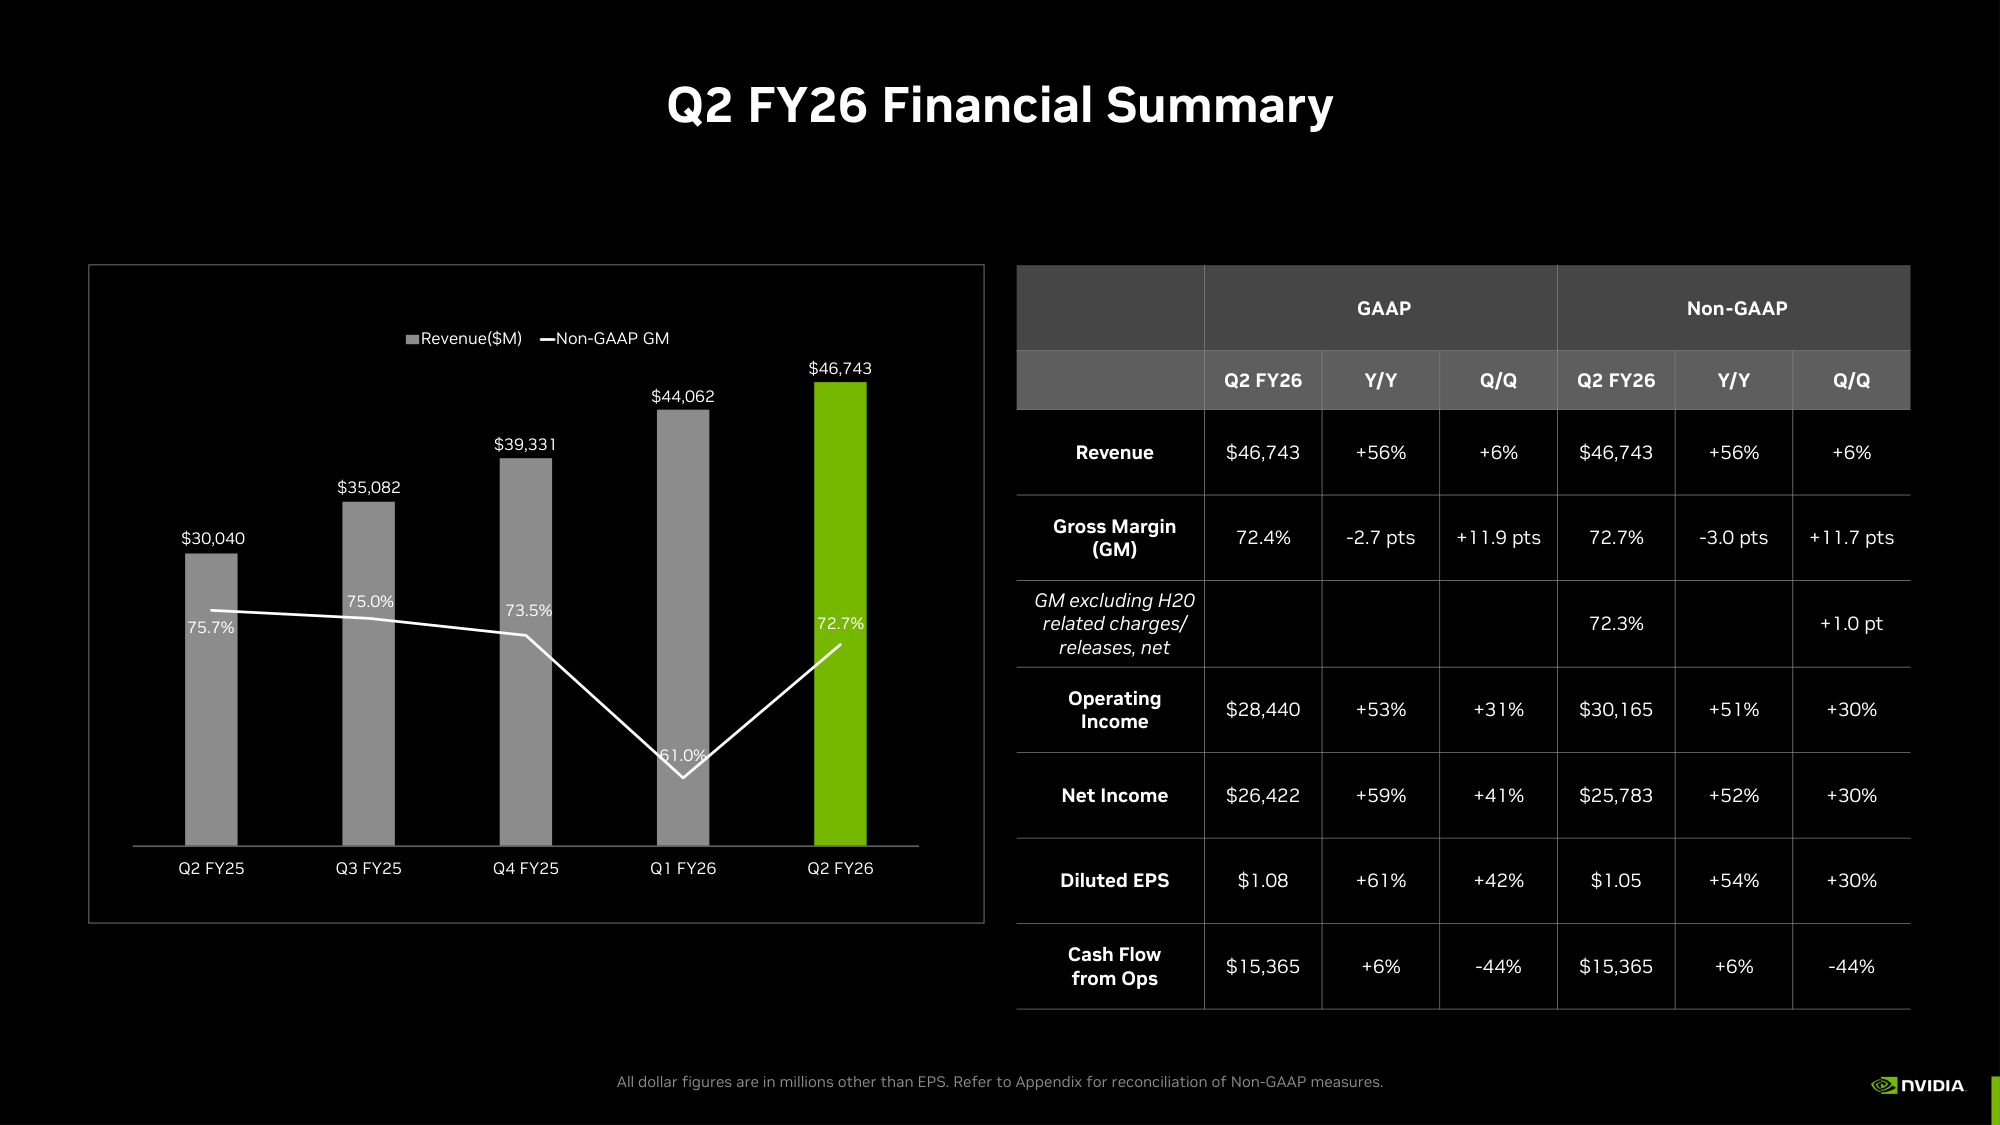
文章主要讨论Nvidia财报及行业分析,但技术内容缺失,信息密度低。
入选理由:文章主要讨论Nvidia财报及行业分析,但技术内容缺失,信息密度低
微软数据中心接收首批Vera Rubins设备,NVIDIA与Azure团队合作达成重要里程碑。
入选理由:微软数据中心接收首批Vera Rubins设备,NVIDIA与Azure团队合作达成重要里程碑
Safe Super Intelligence计划于2026年8月发布AI超级智能模型,Nvidia已投资50亿美元支持其研究,但文章缺乏技术细节和可信论证。
入选理由:Safe Super Intelligence计划在2026年8月发布AI模型
文章未提供完整技术内容,仅包含NVIDIA与Groq合作的链接及标题,缺乏具体技术细节和工程实践指导。
入选理由:需访问NVIDIA官方链接获取完整技术文档
该推文仅包含Hugging Face被NVIDIA收购的新闻链接及社交媒体互动,缺乏技术细节和工程实践价值。
入选理由:该推文仅包含Hugging Face被NVIDIA收购的新闻链接及社交媒体互动,缺乏技术细节和工程实践价值