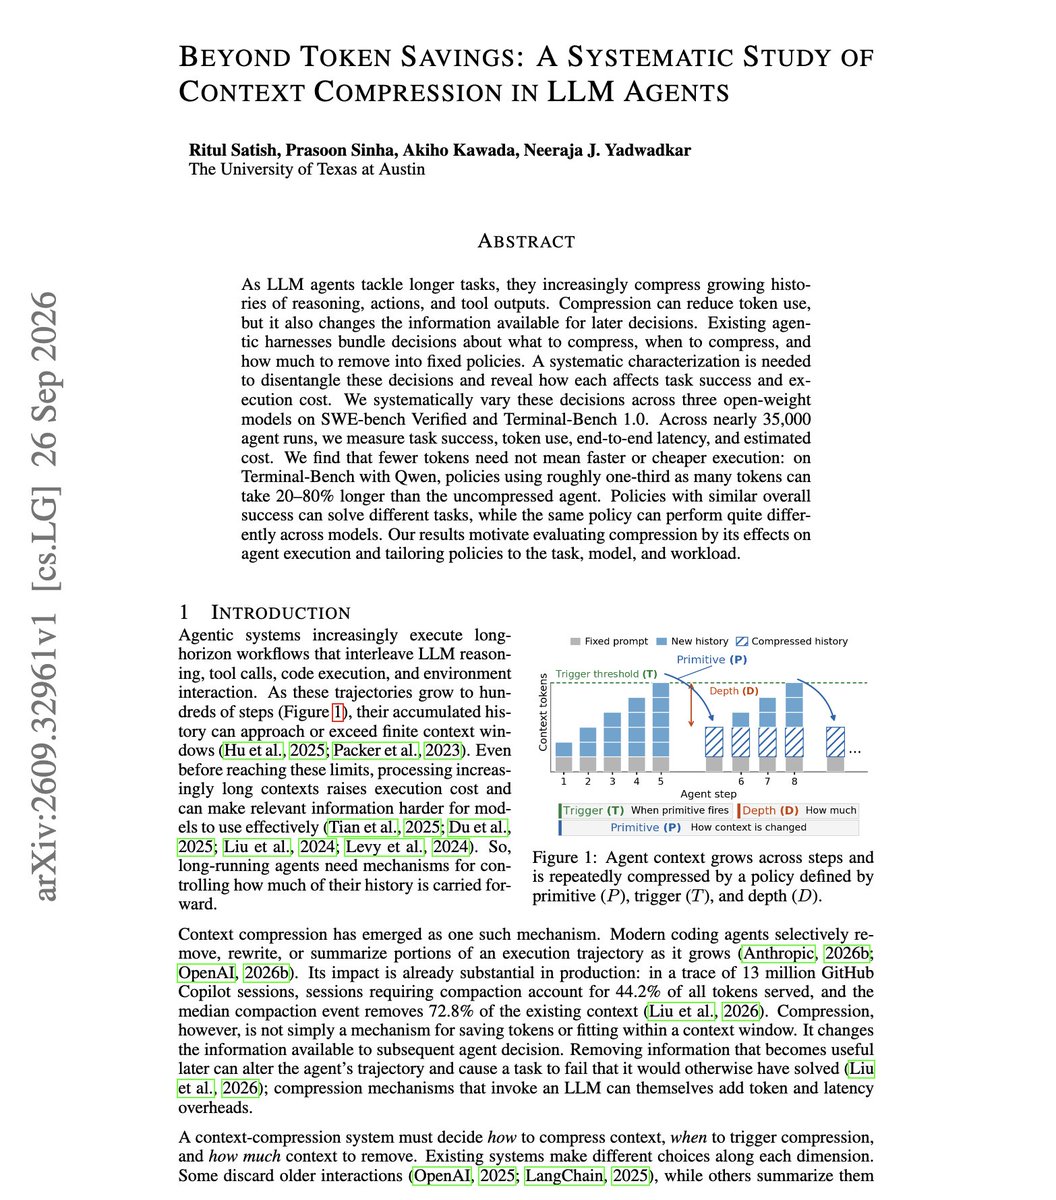
Great overview of context compression in LLM Agents And one interesting, unexpected finding. If yo...
elvis(@omarsar0)243 字 (约 1 分钟)
85
上下文压缩策略可能显著影响LLM代理性能,某些策略虽减少token却导致运行时间增加。
入选理由:使用约三分之一token的策略可能使Qwen变慢20%-80%
精选推文#LLM#上下文压缩#UT Austin#性能优化英文
公司
也叫:UT
德克萨斯大学奥斯汀分校,发布LLM代理压缩研究。
最近变化
2026-10-05 · 使用约三分之一token的策略可能使Qwen变慢20%-80%
UT Austin 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
已收录 1 篇与「UT Austin」相关的 AI 资讯和分析。
上下文压缩策略可能显著影响LLM代理性能,某些策略虽减少token却导致运行时间增加。
入选理由:使用约三分之一token的策略可能使Qwen变慢20%-80%
与「UT Austin」经常一起出现的 AI 术语。
💡 想追踪「UT Austin」的长期趋势?去 实体雷达 · UT Austin 查看详细分析和跨材料问答。