如果AI写你的代码,为什么还要用Python?
Hacker News Best1704 字 (约 7 分钟)
87
AI已让Rust、Go等系统语言开发效率飙升,使Python的生态优势被削弱,开发者需重新评估语言选型策略。
入选理由:2026年GPT-5.5等模型在SWE-bench Verified上达到80%以上通过率,标志着AI已能高效编写系统级代码。
精选文章#AI编程#Rust#Go#系统编程#大模型英文
概念
也叫:swe-bench
软件工程基准测试
最近变化
2026-10-16 · EnvHarness通过setup/rule/link组件动态调整环境行为,无需修改代理代码
SWE-bench Verified 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
已收录 7 篇与「SWE-bench Verified」相关的 AI 资讯和分析。
AI已让Rust、Go等系统语言开发效率飙升,使Python的生态优势被削弱,开发者需重新评估语言选型策略。
入选理由:2026年GPT-5.5等模型在SWE-bench Verified上达到80%以上通过率,标志着AI已能高效编写系统级代码。
Google开源EnvHarness框架,通过动态适应环境提升代理学习效率,实测在多个基准中性能显著提升。
入选理由:EnvHarness通过setup/rule/link组件动态调整环境行为,无需修改代理代码
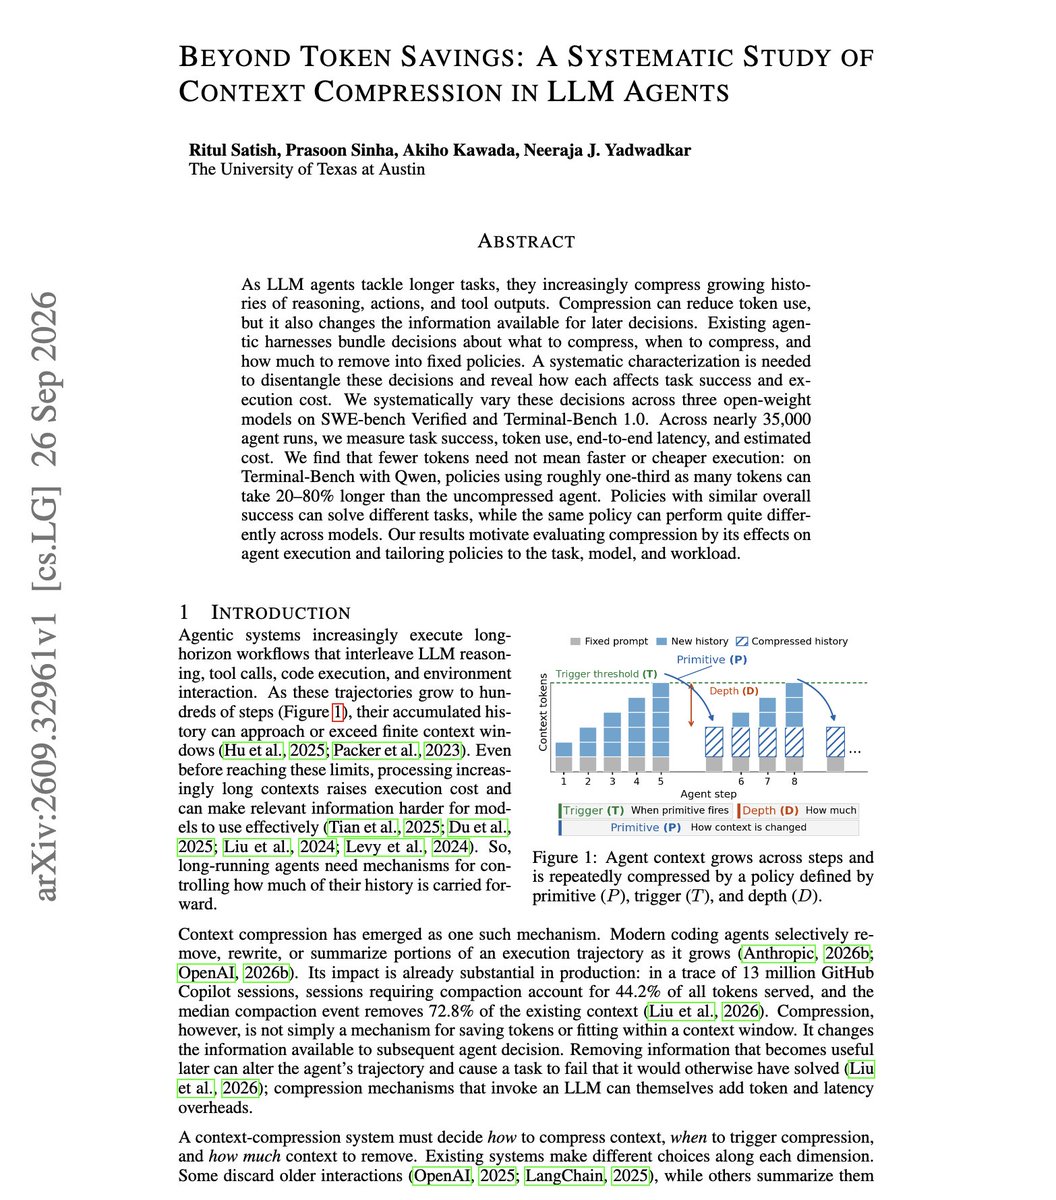
上下文压缩策略可能显著影响LLM代理性能,某些策略虽减少token却导致运行时间增加。
入选理由:使用约三分之一token的策略可能使Qwen变慢20%-80%
openJiuwen通过动态调整机制显著提升agent性能,基准测试成绩领先官方榜单。
入选理由:openJiuwen在SWE-bench Verified达到82.6%,Terminal-Bench 2.1达87.19%
微软发布Orchard开源框架,通过Orchard Env环境服务支持多领域智能体训练,30亿参数模型在SWE-bench测试中达到69.7%性能。
入选理由:Orchard框架支持软件工程、网页导航等多类型智能体训练
斯坦福AI实验室提出去中心化语言模型DeLM,无需中央协调器即可提高代理任务的准确性和降低成本。
入选理由:DeLM使代理任务如编程和多文档问答的准确性提高约10%。
英伟达推出开源框架 Polar,显著提升 Codex 等智能体的性能和效率。
入选理由:Polar 框架让 Codex 在 SWE-Bench Verified 测试中的 pass@1 分数提升了 594.74%。
与「SWE-bench Verified」经常一起出现的 AI 术语。
💡 想追踪「SWE-bench Verified」的长期趋势?去 实体雷达 · SWE-bench Verified 查看详细分析和跨材料问答。