Together Post-Training: frontier-grade model shaping, the way that fits you
Together AI Blog1964 字 (约 8 分钟)
85
Together AI推出Post-Training服务,提供灵活高效的自定义模型训练,无需重基础设施负担。
入选理由:支持LoRA训练和全权重实验,提升模型灵活性
精选文章#AI模型训练#自定义模型#Together AI#RL#SFT英文
概念
也叫:reinforcement learning
强化学习训练方法
最近变化
2026-10-19 · 支持LoRA训练和全权重实验,提升模型灵活性
RL 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
Together Post-Training: frontier-grade model shaping, the way that fits you
Together AI Blog · 8.5 分
Pay attention to decision models. From my recent tests, decision models can be extremely transforma...
elvis(@omarsar0) · 8.5 分
Banger report from Salesforce. Pretty interesting to see more of these custom enterprise models. S...
elvis(@omarsar0) · 8.5 分
已收录 22 篇与「RL」相关的 AI 资讯和分析。
Together AI推出Post-Training服务,提供灵活高效的自定义模型训练,无需重基础设施负担。
入选理由:支持LoRA训练和全权重实验,提升模型灵活性
SubQ Snap决策模型通过长上下文和RL训练,显著提升企业决策效率。
入选理由:SubQ Snap支持384K tokens上下文,是Jev的12倍
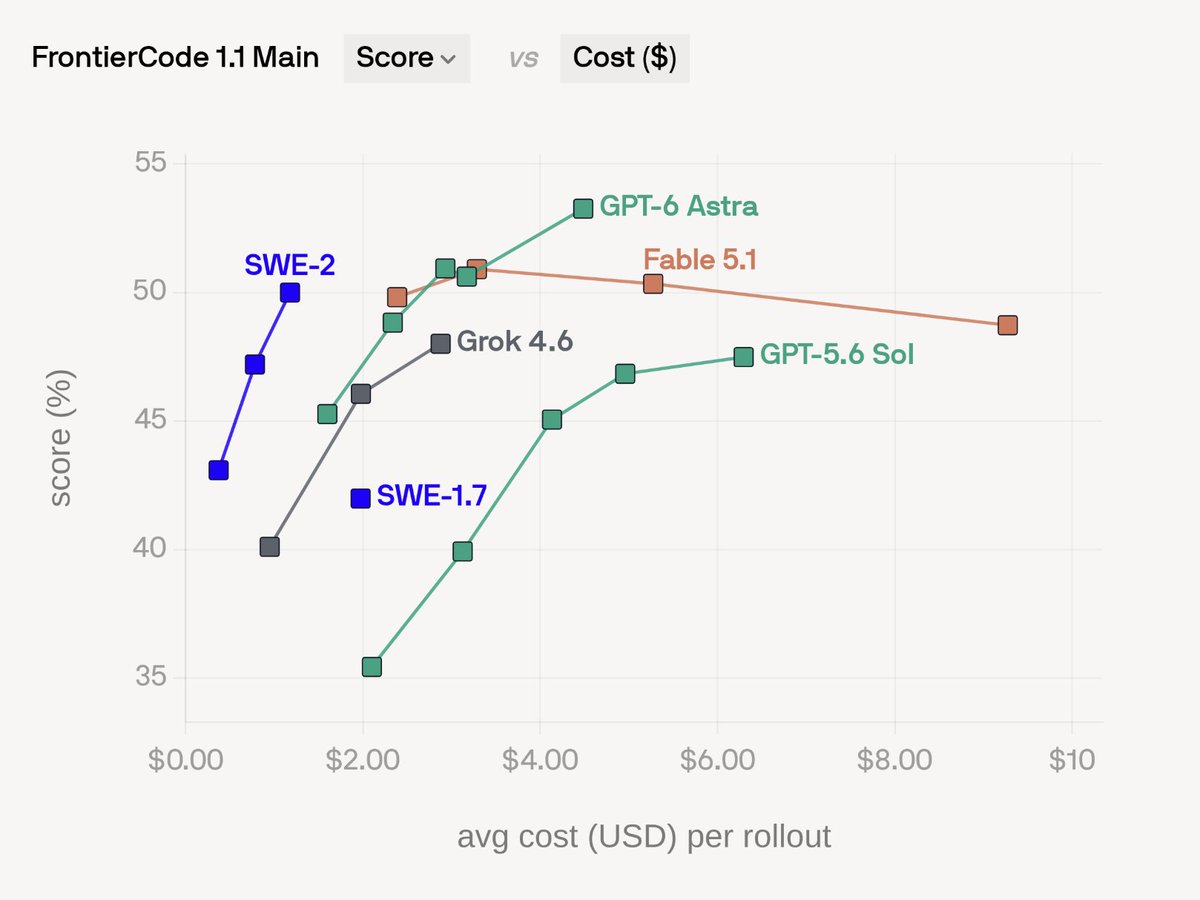
SWE-2模型发布,性能与前沿模型相当,成本降低70%。
入选理由:SWE-2模型在主流评估中表现与前沿模型持平,成本降低70%
Salesforce推出的Koa模型在CRM任务中表现接近 Claude Opus,通过结构化流程描述构建RL环境可提升企业模型训练效果。
入选理由:Koa在Tau2Bench得分69.41,超越其基座模型68.64分
OpenAI在2016年的‘World of Bits’项目尝试训练AI代理通过视觉和鼠标操作完成任务,但因方法局限未能成功,而Astra项目继承了这一理念并取得进展。
入选理由:2016年OpenAI尝试用强化学习训练代理操作屏幕,但因依赖人工设计奖励函数导致失败。
论文提出通过小规模RL训练信号优化蒸馏过程,使学生模型性能超越教师模型,降低训练成本。
入选理由:直接策略蒸馏利用RL训练中的策略变化提升蒸馏效果
OpenAI暂停前沿强化学习训练以确保安全对齐,强调AI安全标准的重要性。
入选理由:OpenAI暂停部分前沿RL训练以确保安全对齐
Fireworks AI 现已支持 DeepSeek V4 Flash 0731 模型的微调训练,提供 SFT/DPO/RL 三种训练方式,适用于编码代理和高并发场景,成本较传统方案降低 70%。
入选理由:DeepSeek V4 Flash 0731 可通过 Fireworks API 进行 SFT/DPO/RL 训练
Kimi K3通过后训练和多领域专家模型显著提升性能,接近Opus 4.8水平,采用创新的推理分层和策略蒸馏技术。
入选理由:Kimi K3后训练阶段结合SFT与RL,构建9个领域专家模型(3领域×3推理层级)
强化学习正成为AI基础设施核心,25家初创公司围绕模拟环境与评分系统构建工具链,解决模型可靠性难题。
入选理由:25家初创公司聚焦强化学习基础设施,解决AI模型可靠性问题
斯坦福AI实验室提出Spiral方法,通过集合强化学习(set RL)和标准强化学习(RL)训练模型,使其在推理时能利用更长的链条、并行样本和聚合计算。
入选理由:Spiral方法结合集合强化学习和标准强化学习,提升模型推理能力。
AI的进展主要依赖于数据量和计算资源的增加,而非样本效率的提升,且高质量数据获取成本极高。
入选理由:AI的进步主要依赖于数据量和计算资源的增加,而非样本效率的提升。
OpenAI 的新论文揭示了通过强化学习对齐大模型的道德行为,发现好行为可泛化到其他领域,对抗压力下表现更稳健。
入选理由:训练模型在特定领域表现诚实、透明,可泛化到其他领域,如健康、法律等。
AI的性能提升主要依赖于数据和计算规模,而非样本效率的提升,数据需求巨大且高度专业化。
入选理由:AI的性能提升主要依赖于数据和计算规模,而非样本效率的提升。
Fireworks AI 现在支持 Kimi 2.7 的完全可训练,提供低成本构建竞争模型的方案。
入选理由:Kimi 2.7 可通过 Fireworks AI 进行 SFT、DPO 和 RL 训练。
Cursor通过分析强化学习训练中权重变化的规律,将1TB模型的传输量压缩至1/20,实现跨地域快速同步,确保模型一致性。
入选理由:RL训练中仅少量权重变化,delta压缩使传输量减少20倍。
AlphaGo 通过蒙特卡洛树搜索(MCTS)和神经网络实现高效搜索,展示强化学习潜力。
入选理由:AlphaGo 使用 MCTS 和神经网络实现高效搜索,每步都有明确监督目标。
Mind Lab(Macaron AI)创始人Andrew提出,下一代模型公司正从Agent产品中诞生,通过LoRA强化学习和持续学习技术,在真实场景中让AI Agent不断进化,实现个性化、可交互的长期智能服务。
入选理由:Mind Lab实现了万亿参数规模的LoRA强化学习,并构建了支持DSA和MTP的LoRA RL基础设施。
研究人员应开放共享强化学习环境,以加速整个领域的发展。开源社区能将研究快速转化为可复用的训练环境,尽管存在共享障碍,但实践案例已证明其价值。
入选理由:开源社区可在研究发布后24小时内构建训练环境
在大规模强化学习训练中,由于模型版本不一致和数值计算差异,导致推理阶段的对数概率值出现不匹配,进而引发训练偏差。该问题被称为‘数值不匹配’,是当前大模型训练中的隐性缺陷。
入选理由:在异步训练中,需重运行前向传播以生成对数概率,但相同模型版本下结果可能不同。
Cursor团队在v9模型训练中贡献工程进展,但补充数据效果有限。
入选理由:Cursor团队在v9 SFT和RL训练中做出重大工程贡献
Cursor Composer 2.5正式发布,通过强化学习实现性能跃升,一周内提供双倍免费额度。新模型更擅长处理长期复杂任务,Cursor团队正与SpaceXAI合作扩展模型规模和算力。
入选理由:Composer 2.5采用强化学习优化,性能表现超出预期
与「RL」经常一起出现的 AI 术语。
💡 想追踪「RL」的长期趋势?去 实体雷达 · RL 查看详细分析和跨材料问答。