Write your own training loop — without managing GPUs — with Amazon SageMaker training session APIs

TL;DR · AI 摘要
AWS SageMaker推出训练会话API,允许用户自定义训练循环而无需管理GPU,提升算法灵活性与基础设施效率。
核心要点
- SageMaker训练会话API提供forward_backward()等操作,用户可组合成任意训练流程。
- 服务自动处理分布式执行、梯度同步等底层任务,用户专注算法实现。
- 配套食谱库包含SFT和RL示例,加速自定义训练方案落地。
结构提纲
按章节快速跳转。
思维导图
用一张图看清主题之间的关系。
查看大纲文本(无障碍 / 无 JS 友好)
- SageMaker训练会话API
- 核心优势
- GPU资源无感管理
- 算法自由度提升
- 技术实现
- LoRA适配模型加载
- 分布式执行自动化
- 应用场景
- SFT自定义损失函数
- RL奖励函数优化
金句 / Highlights
值得收藏与分享的关键句。
训练会话API将GPU管理抽象为forward_backward()等API调用,用户无需关心集群配置。
服务自动处理梯度同步、故障恢复等复杂任务,用户可驱动任意次数的API调用。
配套Cookbook包含RL训练编程竞赛问题的完整示例,代码通过单元测试验证。
标题:使用 Amazon SageMaker 训练会话 API 编写自己的训练循环 —— 无需管理 GPU | Amazon Web Services
URL 来源:https://aws.amazon.com/blogs/machine-learning/write-your-own-training-loop-without-managing-gpus-with-amazon-sagemaker-training-sessions/
发布时间:2026-10-22T10:00:01-08:00
Markdown 内容: 如今微调大型语言模型(LLM)通常需要在训练循环控制与操作简便性之间做出权衡。使用全托管服务时,您只需选择基础模型、提供数据和超参数,服务会处理其余所有内容,这在标准预包装方案能解决您的问题时效果良好。而管理程度较低的服务虽然提供更多控制权,但也需要您管理更多底层基础设施和训练框架。有时标准方案并不足够:您可能需要自定义损失函数或数据课程用于监督微调(SFT),自己的偏好优化方案,强化学习(RL)奖励函数,或上周发布的对齐算法。只要您需要自行设计训练流程,就必须承担相应的基础设施工作以换取算法自由度。
如今,Amazon SageMaker AI 的无服务器模型定制功能通过训练会话 API 进一步扩展,通过将抽象边界下移一层消除了这种权衡。这些 API 不再抽象算法本身,而是抽象计算资源。forward_backward()、optim_step() 和 sample() 等操作变为 SageMaker API 调用,您可以根据技术需求将它们组合成任意流程:SFT、偏好优化、RL 或全新方案。这些调用针对的是实时状态会话,因此模型会在各步骤中保持在 GPU 上加载,您可以根据需要对其发起任意次数的调用。服务负责处理运行时设置、分布式执行、梯度同步、故障恢复、租户隔离以及大规模 GPU 运行操作。您编写训练循环,SageMaker AI 负责运行基础设施。
除了服务本身,我们还发布了 SageMaker 训练会话配方集,这是一组即开即用的 SFT 和 RL 方案,可作为您自定义训练循环的蓝图。
在本文中,我们将介绍编程模型和三个 SDK 客户端,并展示训练会话 API 在 SageMaker AI 模型训练和定制选项中的定位。随后我们将拆解一个针对小学数学问题(GSM8K)的最小 RL 循环,展示这些操作如何协同工作,并以配方集中的真实工作负载收尾:在编程竞赛问题上进行强化学习,其中生成的代码通过运行单元测试进行评分。
什么是 SageMaker AI 训练会话 API?
通过 SageMaker AI 训练会话 API,您可以从本地机器上的 Python 进程直接驱动一个实时 GPU 支持的会话。您调用操作,SageMaker AI 会在加载了您选择的基础模型和 Low-Rank Adaptation(LoRA)适配器的托管加速器上运行这些操作。无需提前描述整个任务的配置文件,也无需创建集群步骤。您可以从代码中交互式地控制每一步的操作,从而快速进行迭代和调试。
责任划分如下:
您专注于您编写SageMaker AI 处理 您的数据、RL 环境、代理和算法 一个 Python 训练循环,调用需要 GPU 的操作,如 forward_backward()、optim_step() 和 sample() GPU 分配、模型和 LoRA 加载、分布式执行、故障恢复、检查点存储、安全
该 API 围绕 SageMaker Python SDK 中的三个客户端组织,按顺序创建。ServiceClient 保存平台级别设置(执行角色、模型包组、Amazon Simple Storage Service (Amazon S3) 输出位置,以及可选的 AWS Key Management Service (AWS KMS) 密钥和虚拟私有云 (VPC) 配置,您也可以按会话覆盖这些设置),并启动会话。ServiceClient 实例化一个 TrainingClient(训练和检查点操作,如 forward、forward_backward、optim_step 和 save_weights_for_sampler),后者又实例化一个 SamplingClient(sample 和 compute_logprobs,用于 rollout 和评估期间的生成和评分)。每个 API 调用对应循环中的一个操作。活动会话还会提供一个兼容 OpenAI 的聊天补全端点,因此现有的 OpenAI 客户端代码可以从该端点进行采样。
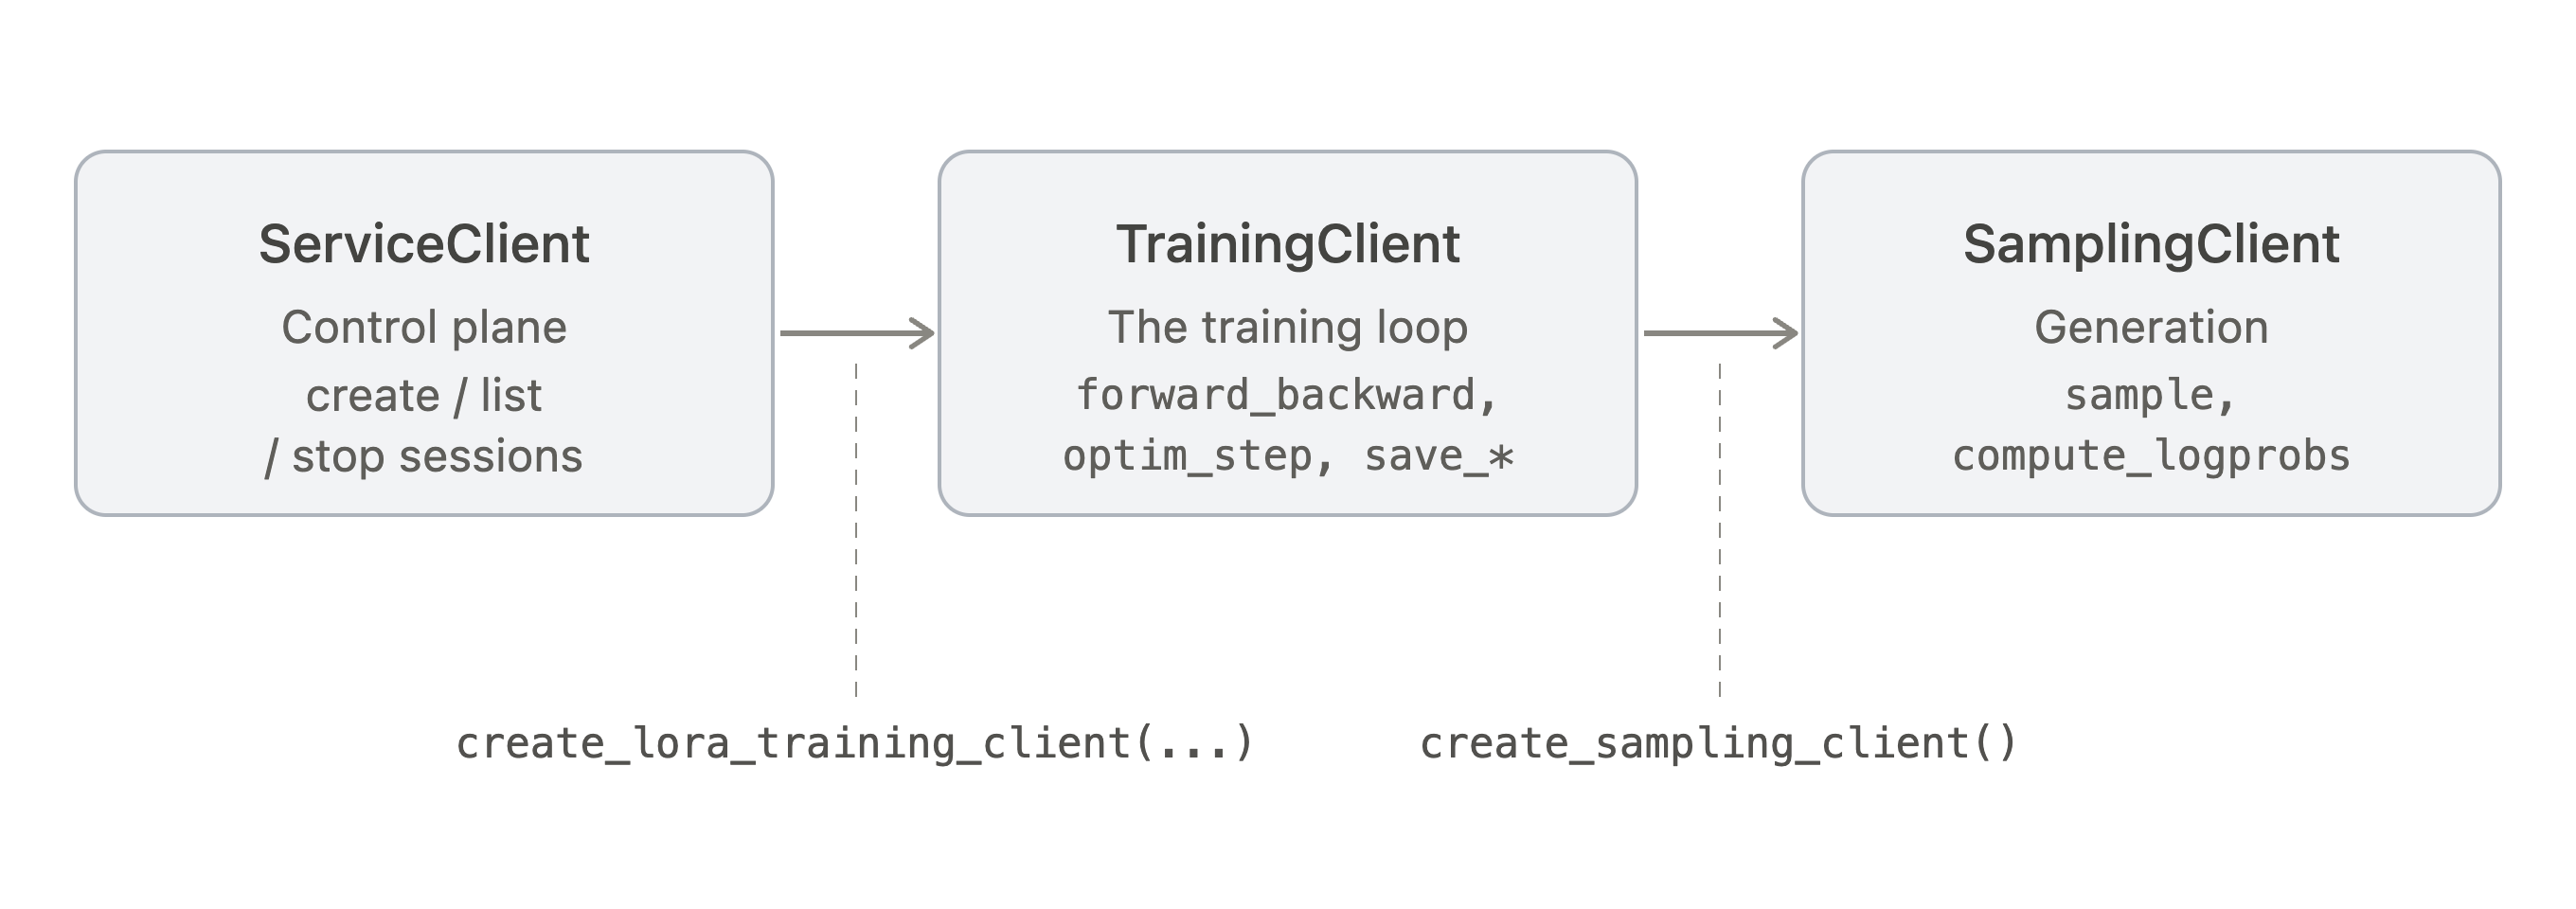
图 1:训练会话 API 的 SageMaker Python SDK 客户端层次结构
对于 强化学习,循环具有特定的形状。下图显示了一个训练步骤以及各部分的运行位置:绿色步骤在服务管理的 GPU 上调用 API,紫色步骤(您的循环控制和奖励逻辑)在您的机器上运行。
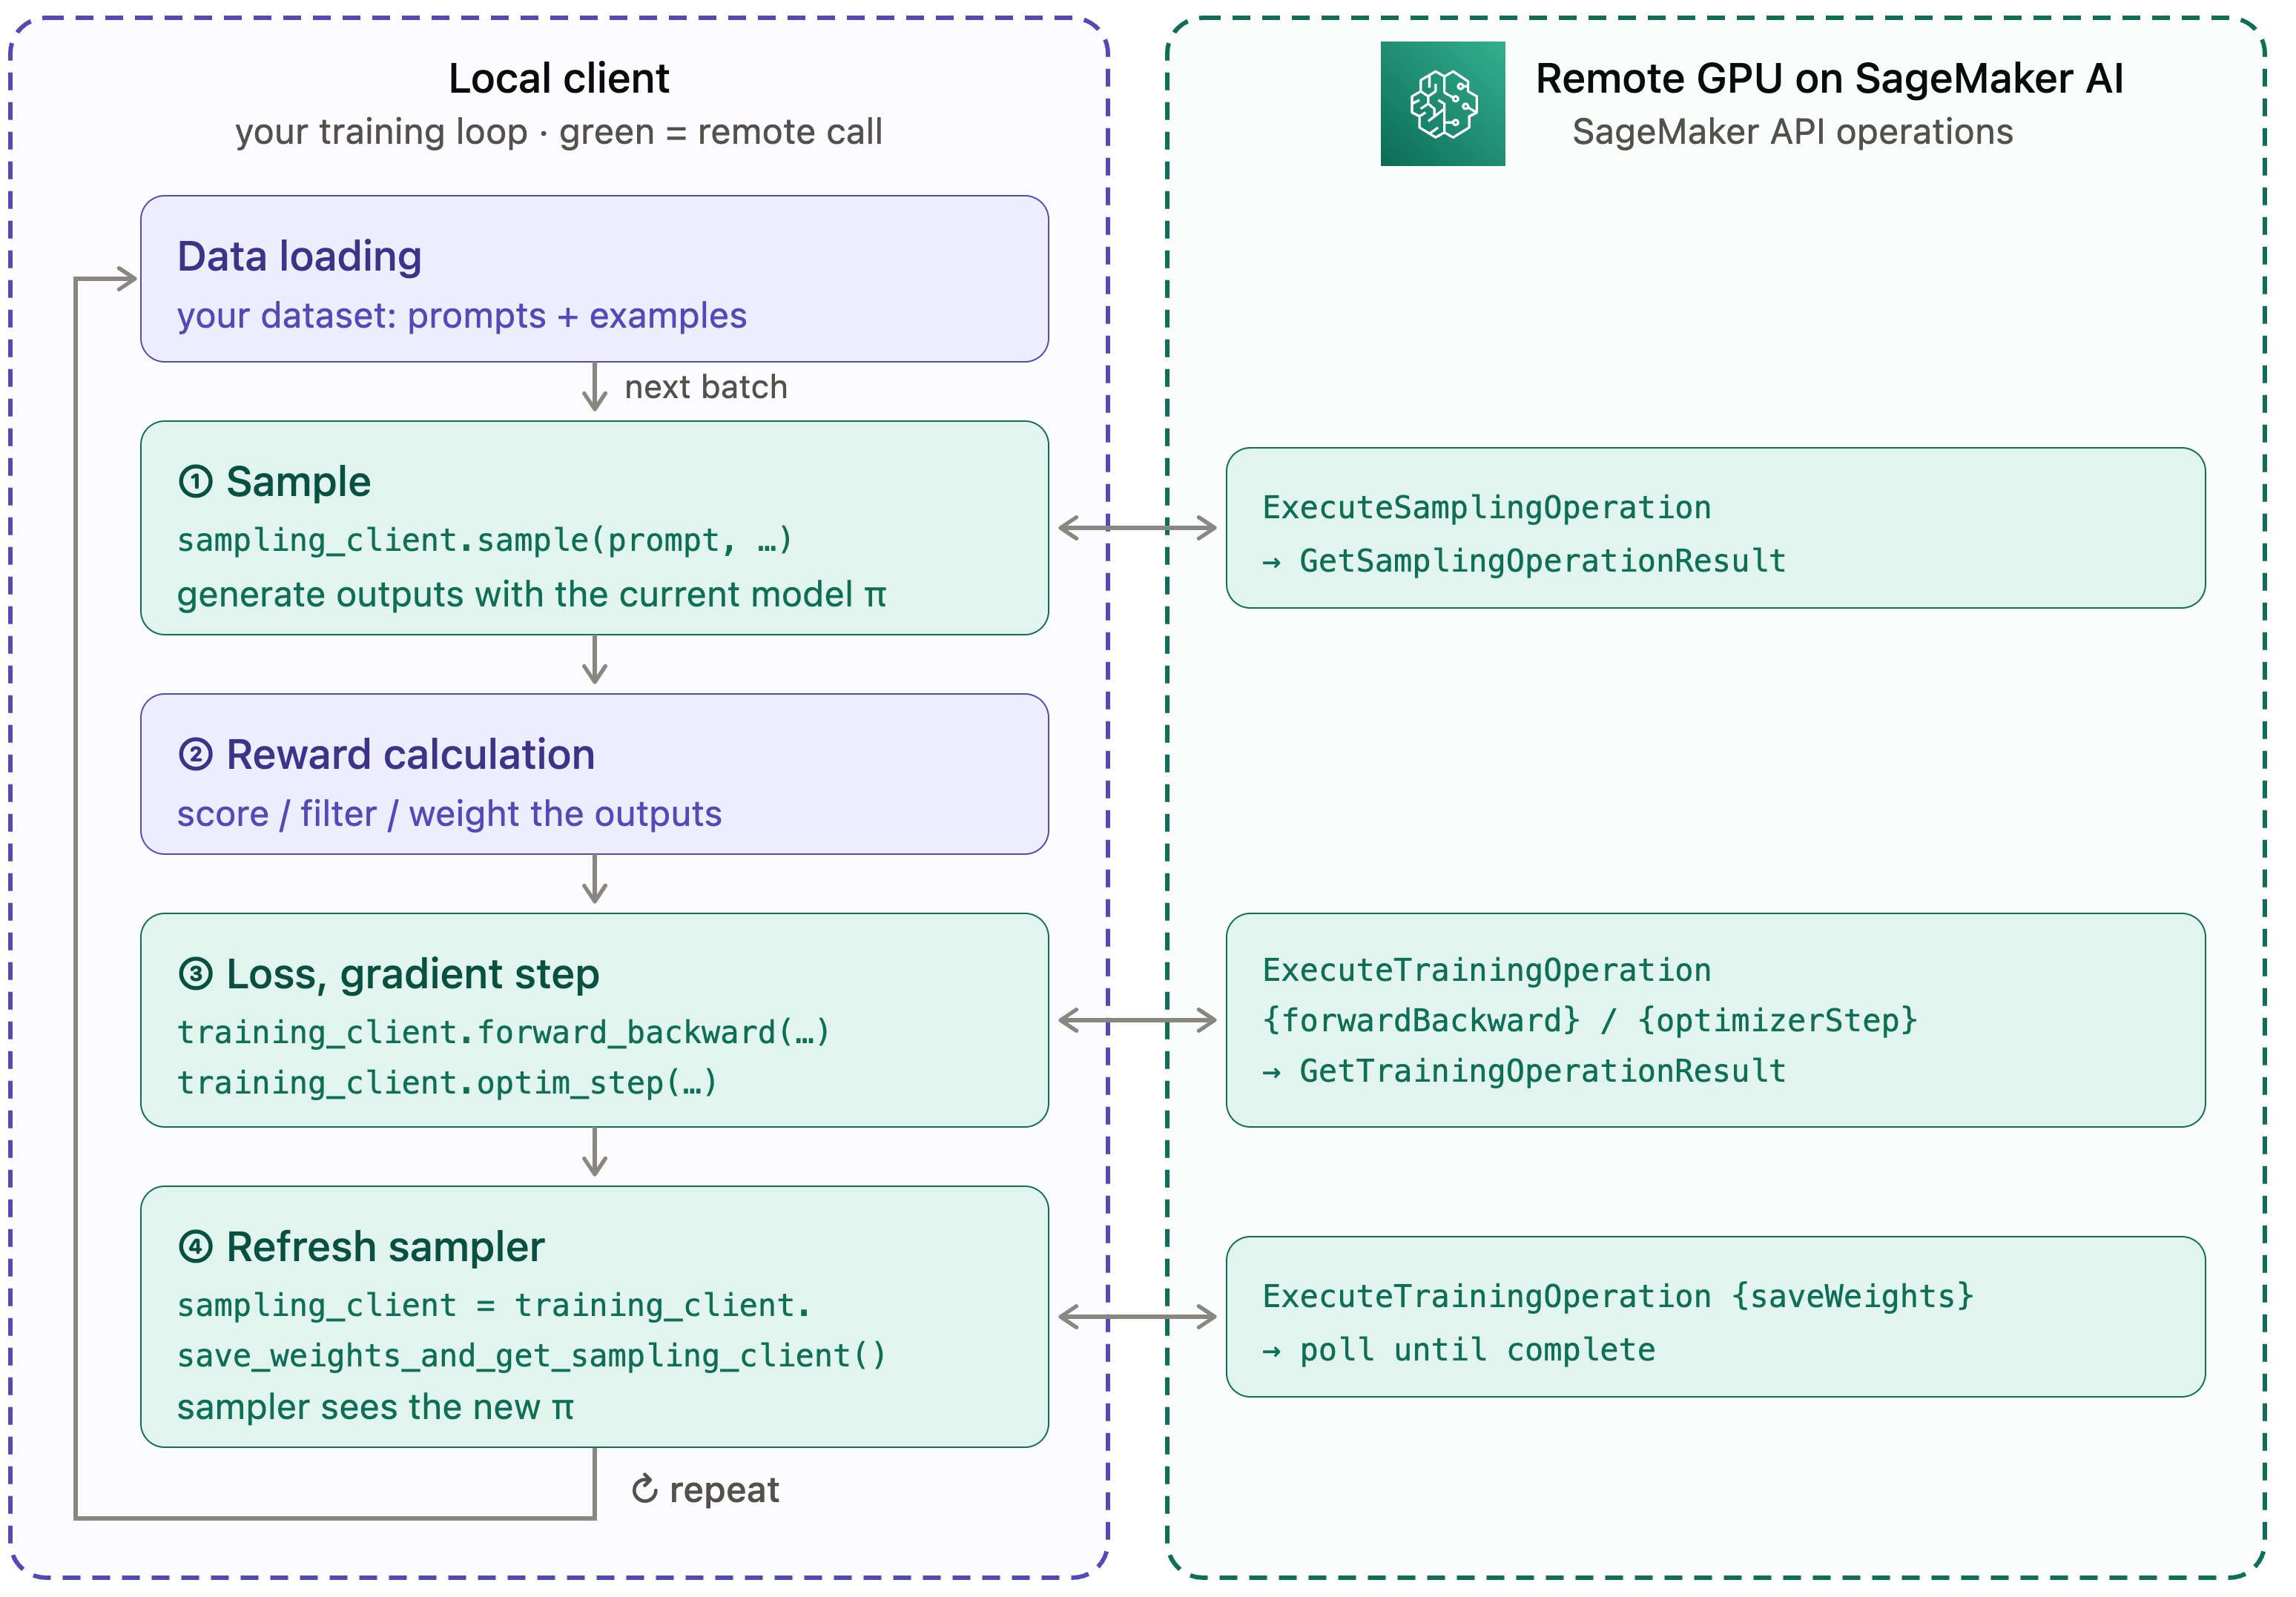
图 2:一个训练步骤,采样、梯度和检查点操作在托管 GPU 上运行,循环控制和奖励逻辑在您的机器上运行
每个步骤加载一批提示,(1) 在 GPU 上从当前模型进行采样。您的 Python 代码随后 (2) 对这些输出进行评分:验证器、奖励模型调用、测试套件、您可以用代码表达的任何内容。 (3) forward_backward 和 optim_step 将评分转换为 GPU 上的梯度更新,(4) save_weights_and_get_sampling_client() 刷新采样器,以便下一步从更新后的模型中进行采样。
您拥有数据、循环控制和奖励;SageMaker AI 运行 GPU 绑定的采样、梯度和检查点操作。相同的原语也适用于 监督微调 (SFT) 和其他 LLM 训练技术。对于 SFT,删除采样和奖励步骤,并使用标记示例上的 cross_entropy 损失调用 forward_backward。
这适用于谁,以及在 Amazon SageMaker AI 中的位置?
训练会话 API 是需要快速迭代周期和算法自由度的场景的理想起点,例如自定义损失函数、新的强化学习奖励信号或多阶段流水线,但又不想自行部署或管理 GPU 基础设施时。
按处理的 token 数计费,因此您只需为循环消耗的计算资源付费。如果您的奖励函数在本地机器上对一批数据进行评分需要 10 秒,那么在此期间不会产生 GPU 时间费用。与按小时计费的 GPU 相比,这种模式有两个实际优势。首先,没有空闲 GPU 的成本:奖励计算、数据加载、日志记录和调试均在非 GPU 计费时段运行,您仅在调用 GPU 相关操作时被计费。其次,成本随数据集规模和生成量变化,而非墙钟时间或集群规模,这使得支出更容易预测,实验也更容易比较。对于需要大量本地计算的工作负载(如复杂奖励模型、多工具代理流水线或人机协同评估),与为整个会话预留 GPU 相比,节省的成本可能非常显著。
训练会话 API 是为那些工作由训练算法定义(而不仅仅是数据集)的团队设计的。由于您自行构建循环,相同的原语支持使用 cross_entropy 损失函数对标注数据进行监督微调(SFT),使用 ppo、importance_sampling 或 cispo(GRPO、PPO 和其他基于组的相对方法)的强化学习,以及由相同组件构建的自定义目标(如偏好优化或知识蒸馏)。它们适用于以下场景:
- 从事后训练和对齐研究的团队,他们需要实现 RL 方法(GRPO、PPO、重要性采样变体)、自定义优势估计器或新目标。
- 需要非标准损失函数、数据课程或配置驱动配方无法表达的多阶段流水线的监督微调或偏好优化团队。
- 需要自定义流水逻辑、奖励塑造和课程的代理或多轮 RL 构建团队。
- 已超越配置驱动微调但又不想承担 GPU 集群运营负担的机器学习(ML)工程师。
- 需要移植现有训练循环代码的研究人员,因为基于操作的编程模型可直接映射到针对低级
forward_backward、optim_step和sampleAPI 编写的循环。
支持的基础模型及其可用的 AWS 区域列在 训练会话 API 文档 中。
#### 训练会话 API 在 Amazon SageMaker AI 中的位置
训练会话 API 在 SageMaker AI 的模型定制选项中占据独特位置:相比完全托管的 无服务器模型定制,它对训练算法的控制显著增强;相比在 Amazon SageMaker 训练作业 或 Amazon SageMaker HyperPod 上进行训练,它的运营责任要小得多。
选项对训练的控制基础设施 SageMaker 无服务器模型定制 – 管理的 API 低 – 选择模型,配置可用的超参数并提供数据 无服务器,无需实例选择 SageMaker 无服务器模型定制 – SageMaker AI 训练会话 API 高 – 你编写循环,调用原语 无服务器,无需实例选择 SageMaker 训练作业 全托管,临时作业,你可以选择实例类型 SageMaker HyperPod 全托管,持久集群,具有高级容错功能
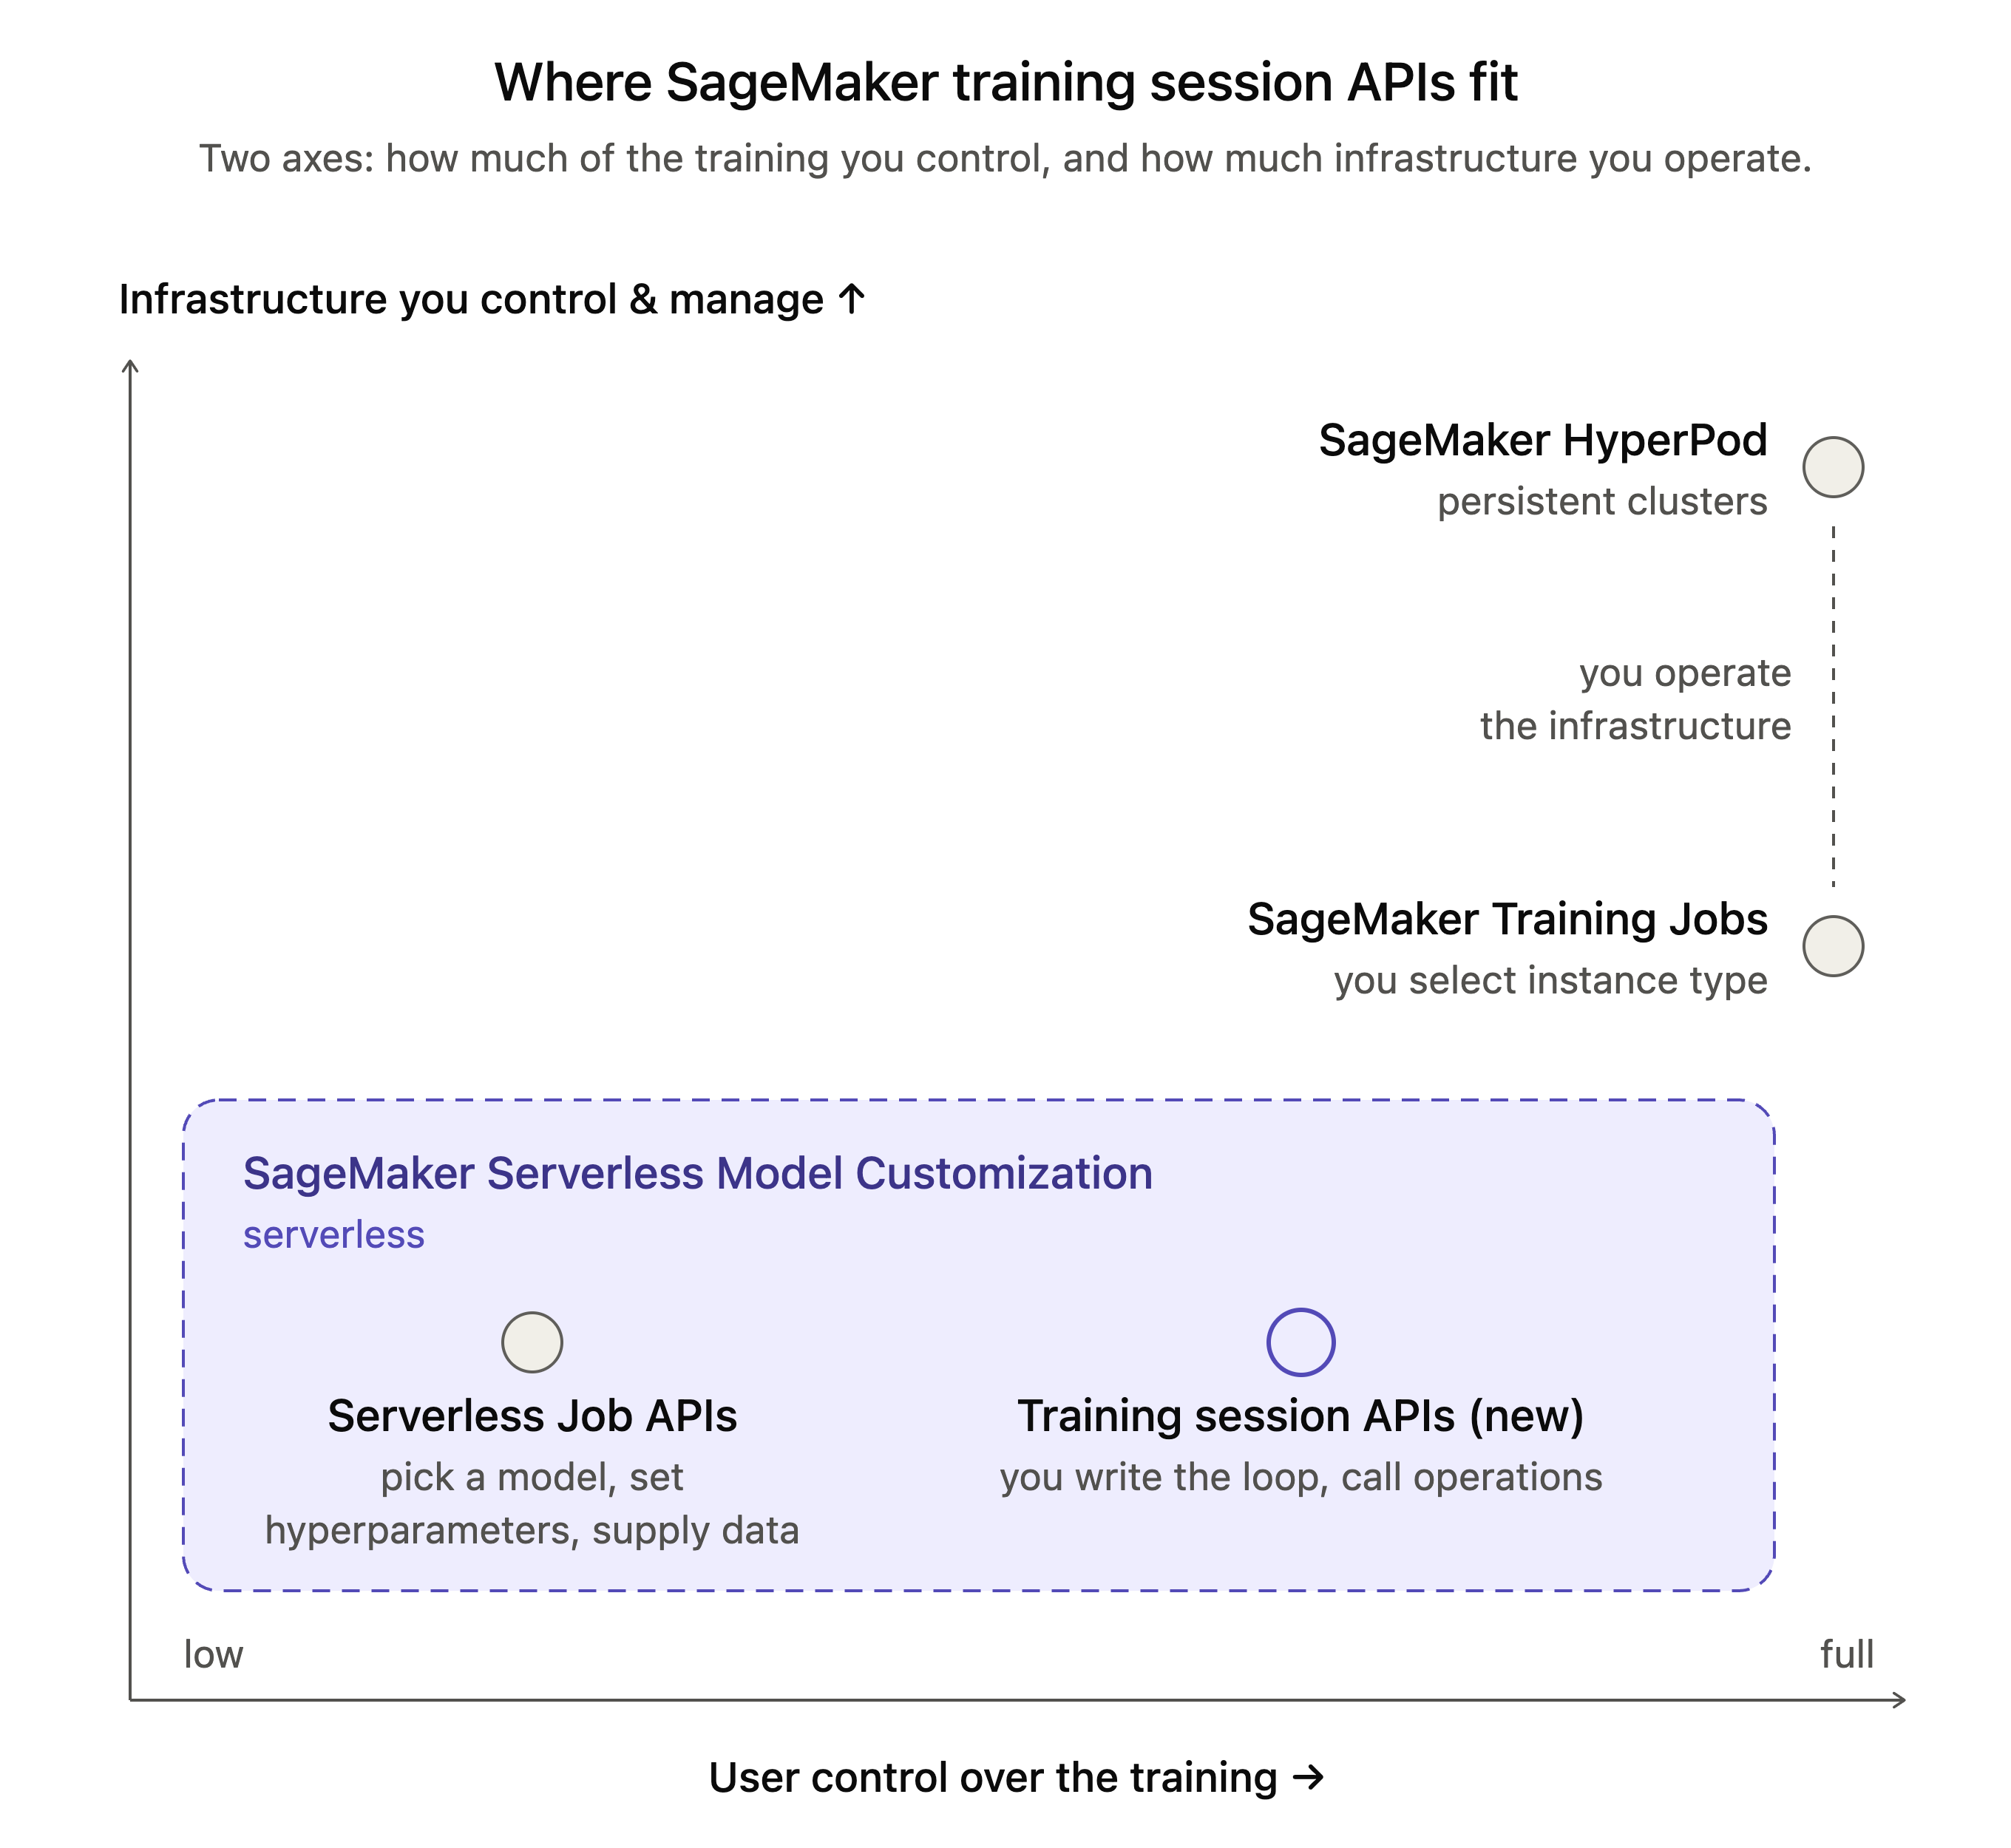
图 3:训练会话 API 在 SageMaker AI 模型定制选项中的位置
训练循环的结构:在数学问题上使用 GRPO
本节将剖析一个最小的强化学习循环,以展示这些操作如何配合使用。任务是 GSM8K,这是一个包含约 8,500 个小学数学文字题的基准测试,每个问题都有一个数字答案,例如:
_Natalia 在四月向她的 48 个朋友出售了发夹,然后在五月出售的发夹数量是四月的一半。Natalia 在四月和五月总共出售了多少个发夹?_ → 72
我们为 OpenAI 的 GPT-OSS 20B 训练一个 LoRA 适配器,使用组相对策略优化(GRPO):对于每个问题,模型生成多个响应,每个响应都会根据正确性进行评分,表现优于组平均值的响应会得到强化。完整的可运行示例位于 Amazon SageMaker 示例存储库 中。
在打开会话之前,请完成文档中的 先决条件。
打开会话
创建会话,然后从会话中获取分词器和 SamplingClient:
from sagemaker.train.training_session import ServiceClient, SamplingParams, AdamParams

svc = ServiceClient(role_arn=role, region=REGION)

training_client = svc.create_lora_training_client(
    "openai/gpt-oss-20b",                        # 从 svc.list_base_models() 获取的名称
    training_session_name=SESSION_NAME,
    rank=32, alpha=64,                           # LoRA 秩和缩放因子
    model_package_group_arn=MODEL_PACKAGE_GROUP_ARN,
    s3_output_path=OUTPUT_S3_PATH,
)
tokenizer = training_client.get_tokenizer()
sampling_client = training_client.create_sampling_client()
Python
定义奖励和优势
任务特定的逻辑是运行在你本地机器上的两个简短函数:
def compute_reward(response_text, ground_truth):
    predicted = extract_answer(response_text)      # 解析 "#### " 后的数字
    return 1.0 if predicted == ground_truth else 0.0

def compute_advantages(rewards):
    rewards = np.array(rewards)
    advantages = rewards - rewards.mean()          # 在组内居中(GRPO 基线)
    return advantages / (rewards.std() + 1e-8)     # 归一化
Python
循环
for step in range(NUM_STEPS):
    datums, pending = [], []
    # (1) 每个问题在单个请求中采样 K 个响应(GPU);立即返回一个 future
    for question, ground_truth in draw(PROMPTS_PER_STEP):          # 数据加载是本地的
        prompt = tokenizer.encode(build_prompt(question), add_special_tokens=False)
        pending.append((prompt, ground_truth, sampling_client.sample(
            prompt, num_samples=K,
            sampling_params=SamplingParams(max_tokens=512, temperature=0.7, top_p=0.9))))

    for prompt, ground_truth, future in pending:
        result = future.result()                                    # 批次在飞行中时等待一次
        # (2) 对每个响应进行评分,然后在组内对奖励进行中心化(本地)
        rewards = [compute_reward(tokenizer.decode(s.tokens), ground_truth) for s in result.sequences]
        advantages = compute_advantages(rewards)
        datums += [build_training_datum(prompt, s, a) for s, a in zip(result.sequences, advantages)]

    # (3) 对批次进行一次梯度更新(GPU);优化器步骤在其后按顺序执行
    fwd_bwd_op = training_client.forward_backward(datums, loss_fn="ppo")
    optim_op = training_client.optim_step(AdamParams(learning_rate=1e-5))
    fwd_bwd_op.result(), optim_op.result()

    # (4) 刷新采样器,使下一步的 rollout 来自更新后的策略(GPU)
    sampling_client = training_client.save_weights_and_get_sampling_client()

training_client.stop()
Python
使这个循环正常工作的三个关键点:
操作返回 future。每个与 GPU 相关的调用会立即返回一个 APIFuture:请求由后台提交器排队并发送,.result() 会等待结果值。循环会在等待任何请求之前提交整个步骤的采样请求,因此整个批次可以并发生成。训练操作按照调用顺序执行,因此可以在 forward_backward 完成之前提交 optim_step。
datum 包含损失函数所需的所有信息。build_training_datum 将提示和响应 token、sample() 返回的每个 token 的 logprobs、优势值以及一个 weights 掩码(用于将提示排除在损失之外)打包在一起。
检查点是模型包。每次保存都会在您的模型包组中注册一个版本,包括上面循环中每步的采样器刷新。训练结束后,另外两次保存会添加一个用于部署的合并模型和一个包含权重和优化器的可恢复状态。
training_client.save_weights_for_sampler(merge_weights=True).result()   # 合并后的可部署模型
training_client.save_state().result()                                   # 可恢复状态(权重 + 优化器)
Python
要恢复训练,可以从最新检查点使用 create_training_client_from_state_with_optimizer 启动新会话。
运行中的会话会占用您的并发会话配额,直到您调用 stop() 或会话过期,因此在完成时(包括错误路径)应停止会话,或使用 with 块打开客户端。合并后的检查点可以部署到实时端点。如果要将检查点作为 LoRA 适配器部署,请参阅食谱中的 部署笔记本。
在我们的样本运行中,对40个问题进行10次训练步骤后,保留集的准确率从56%提升至75%。
实际工作负载:在编程竞赛中的强化学习
GSM8K使机制保持可见,但生产级的强化学习工作负载需要更多内容:更长的生成长度、多轮交互、外部评分器,以及足够的吞吐量以保持GPU繁忙。SageMaker训练会话食谱将这些工程内容封装到基于相同操作的可复用训练循环中。对于新的强化学习任务,您只需编写环境:模型能看到的内容、答案的评分方式,以及是否获得下一轮机会。该食谱处理批处理、聊天模板、优势估计、重叠采样与训练、验证、支持恢复的检查点以及每步指标,并记录每次运行的配置以便重复使用。code_rl食谱利用它来训练解决编程竞赛问题的模型。
任务描述。问题来自DeepCoder数据集(PrimeIntellect、TACO和LiveCodeBench用于训练;Codeforces和LiveCodeBench用于测试)。模型编写Python解决方案,并在您的机器上的SandboxFusion容器中运行问题的单元测试。当所有测试通过时奖励为1,否则为0,若响应中不包含代码块则额外惩罚0.1。
多轮工具使用。通过两轮交互,模型可以调用check_solution工具,读取测试结果并在最终评分前修改答案。工具调用和结果以模型原生的聊天格式呈现,因此模型在训练时使用与推理相同的token格式。
该食谱对基础循环的增强:
- 重叠采样与训练: rollout工作线程在训练器执行步骤时持续生成。若采样响应来自至多k步前的旧策略则直接使用,否则重新排队,
cispo损失用于修正策略差异。 - 流式梯度计算:
forward_backward按组分批提交,而非每步一次性提交。 - 保留集验证、检查点恢复和每步指标,可选地发布到SageMaker托管MLflow。
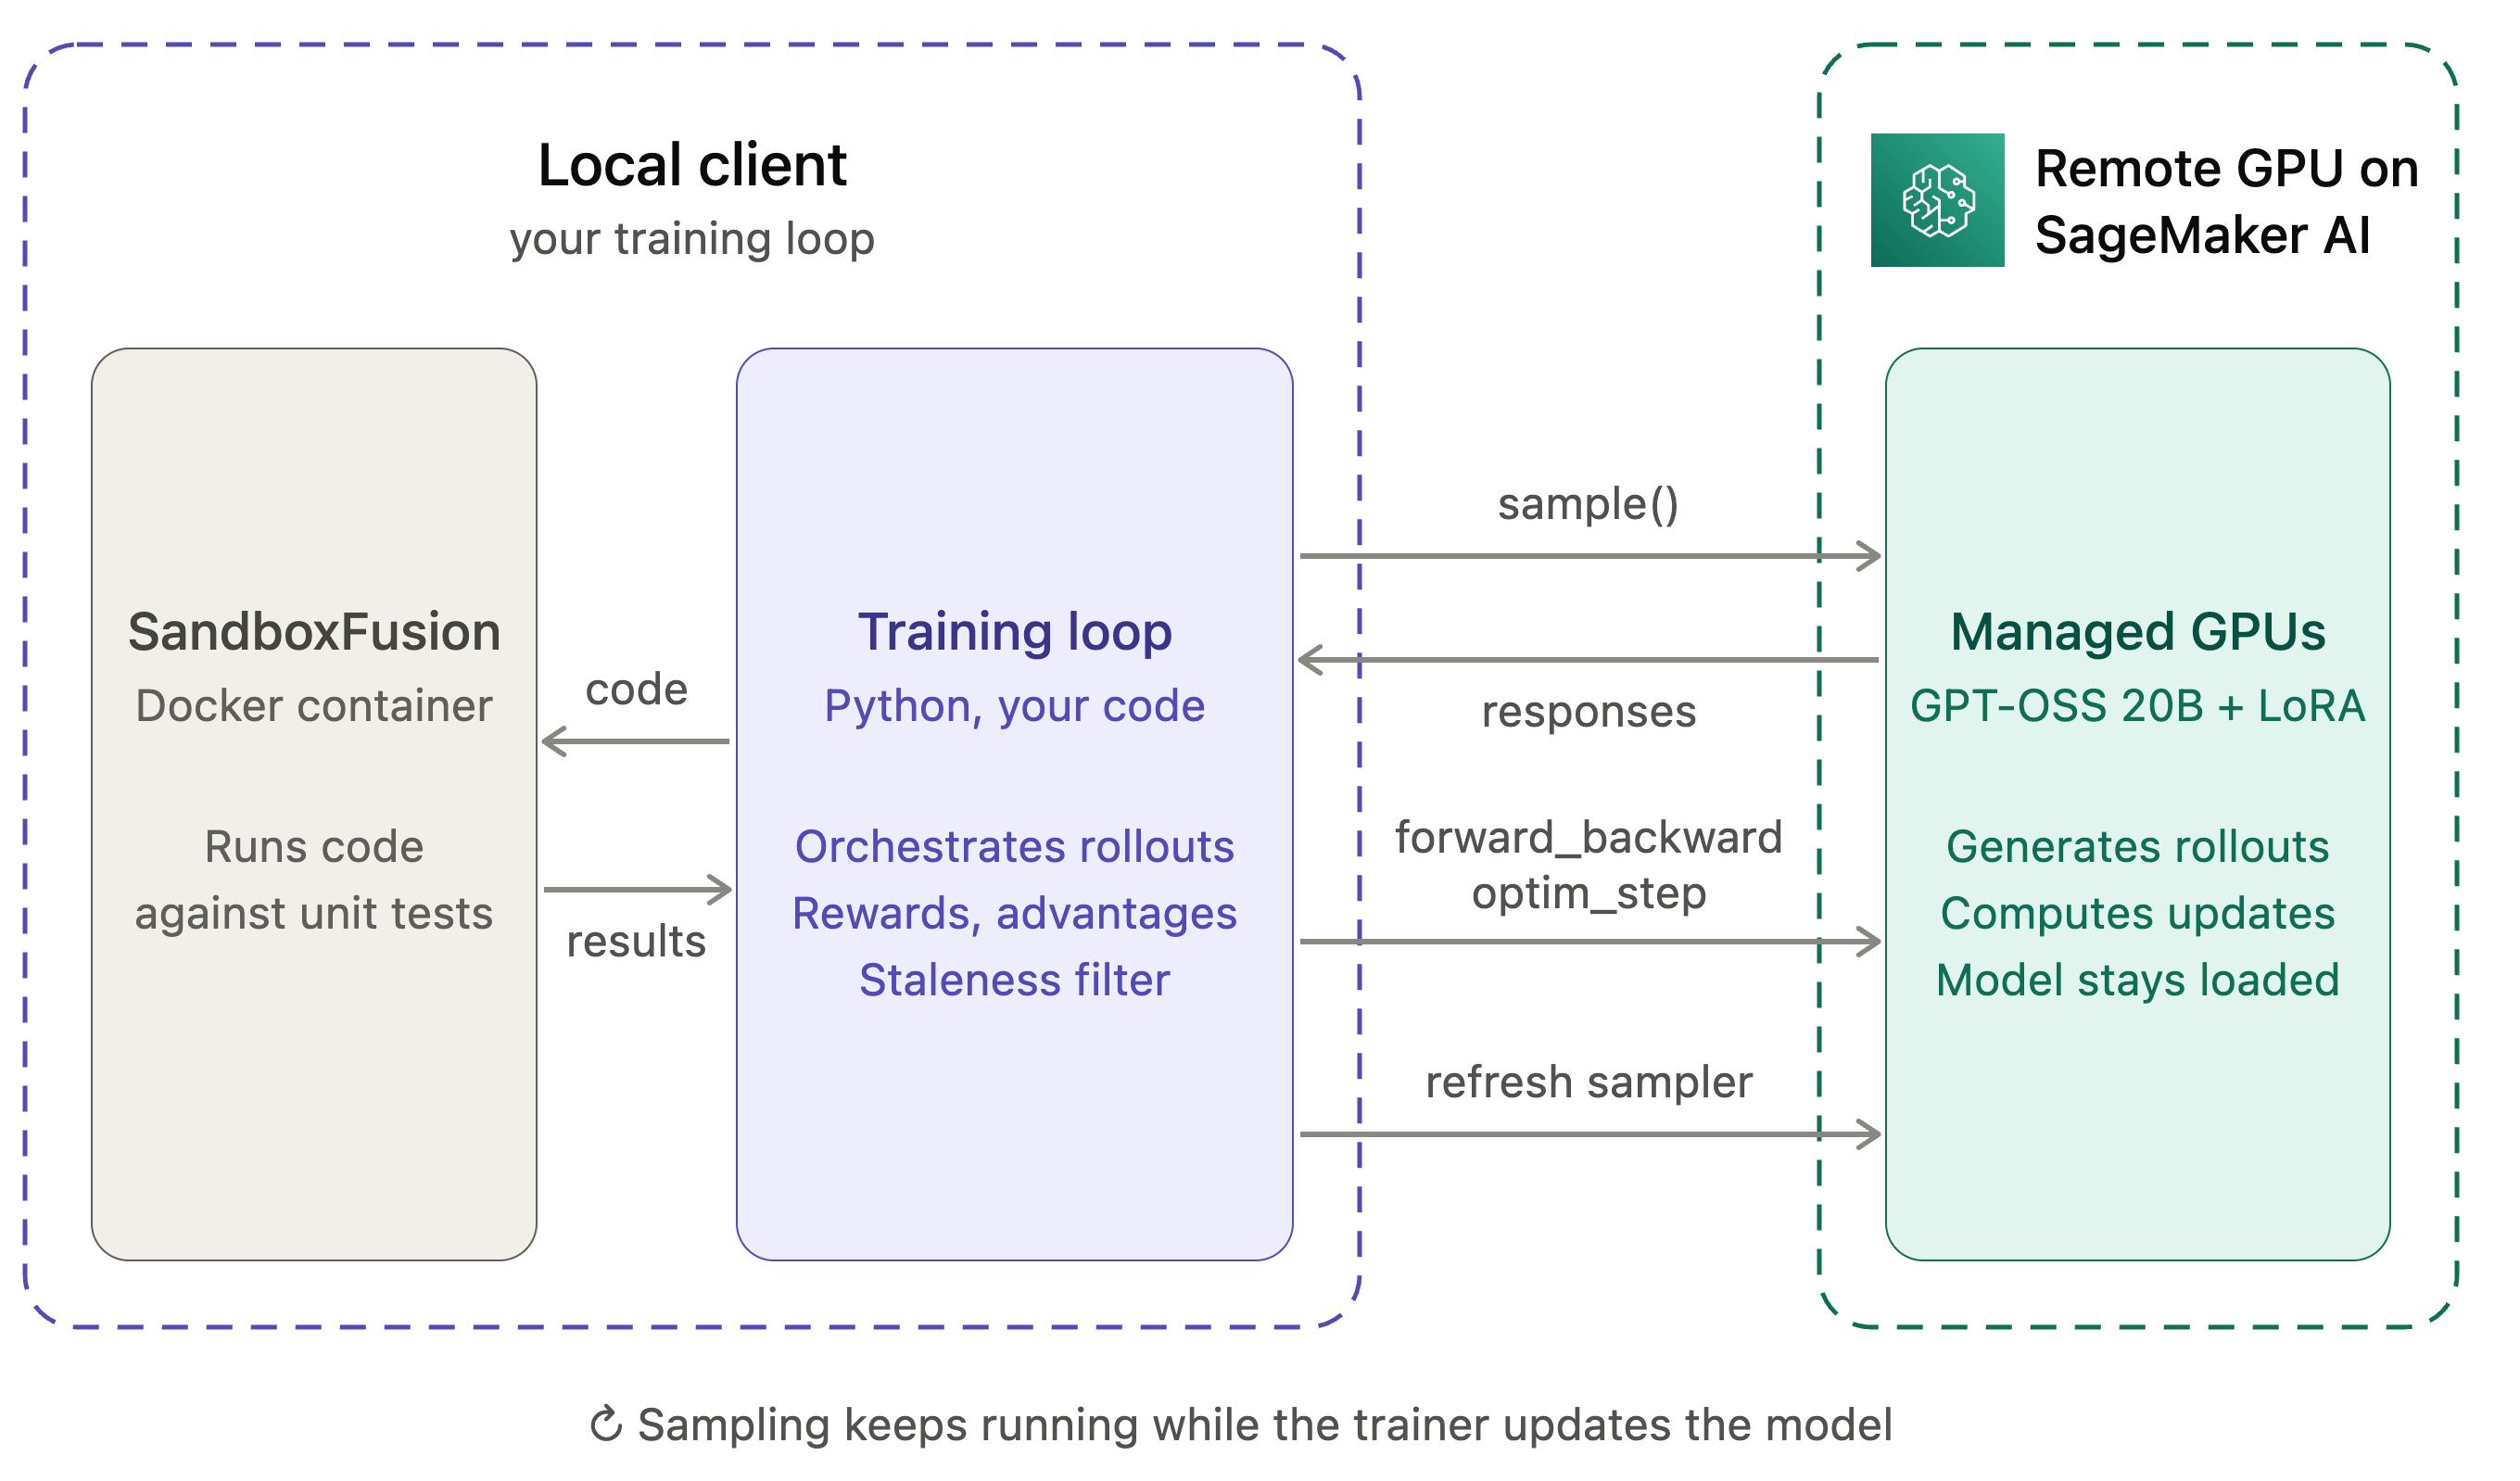
图4:代码RL设置,左侧是本地训练循环和沙箱,右侧是托管GPU
我们为GPT-OSS 20B训练了一个LoRA适配器(秩32),训练50步,每步包含128个问题,每个问题生成8个响应,使用两轮交互和陈旧度阈值k=3。训练奖励从0.46提升至0.60,在200个保留测试问题上的准确率从40%提升至50.5%。
运行方法:启动沙箱并启动食谱:
# 命令行示例bash tools/sandbox_up.sh
python -m training_sessions_cookbook.recipes.code_rl.train \
--config training_sessions_cookbook/recipes/code_rl/configs/coderl_oss20b_service.json \
--max_steps_off_policy 3 --stale_policy requeue --num_rollout_workers 80 --max_steps 50 \
--base_model_arn "$BASE_MODEL_ARN" \
--model_package_group_arn "$MODEL_PACKAGE_GROUP_ARN" \
--role_arn "$ROLE_ARN" \
--output_s3_path "$OUTPUT_S3_PATH"Bash
食谱库中还有更多结构相同的配方,包括在对话数据集(Tulu 3、UltraChat)上进行监督微调、在GSM8K上进行全规模强化学习,以及通过二元反馈进行KTO偏好对齐。每个配方的README文件都会列出其命令、超参数和预期指标。
结论
SageMaker AI训练会话API将抽象边界下移到训练操作层面:你可以在自己的机器上用Python编写训练循环,服务则会在托管GPU上运行,处理模型和LoRA加载、分布式执行、故障恢复和检查点保存。一个完整的GRPO循环仅需四个操作:sample、forward_backward、optim_step和save_weights_and_get_sampling_client,奖励和优势逻辑由你自己的代码实现。相同的操作可以扩展到多轮对话和使用工具的强化学习,如Code RL配方所示。
自定义奖励、智能体rollouts、逐步调试和新发布的技术都使用相同的编程模型:算法保留在你的循环中,SageMaker AI负责运行GPU。
要开始使用:
- 从SageMaker训练会话食谱库中选择一个配方,例如Code RL。
- 运行来自Amazon SageMaker示例仓库的GSM8K示例,并替换为自己的奖励函数。
- 阅读训练会话API文档,了解先决条件、配额、区域、支持的模型和API参考。
致谢
感谢Arun Nagarajan、Xichao Wang和Shruti Sharma为本文提供的贡献和指导。
- * *