构建金融产品时,准确性至关重要。Perplexity Computer 的每个输出数字均可追溯至来源。
Perplexity Computer 在金融产品中实现数据可追溯性,所有输出数字均链接至原始来源(如SEC文件、财报),确保准确性与可信度,重塑AI在金融决策中的可靠性标准。
入选理由:金融类产品必须保证数据输出完全可追溯,否则将丧失专业可信度。
公司
也叫:Perplexity AI
提供AI决策模型的公司
最近变化
2026-10-19 · Meta的Muse应用首月下载量达500万次,代理流量在8-9月增长三倍。
Perplexity 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
Accuracy is everything when you build products for Finance. Every output number on Perplexity Comput...
Aravind Srinivas(@AravSrinivas) · 8.7 分
Making the internet better for AI agents might make it worse for everyone else
MIT Technology Review · 8.5 分
Perplexity's Decider V1.2 models now available on AI Gateway
Vercel News · 8.5 分
已收录 30 篇与「Perplexity」相关的 AI 资讯和分析。
Perplexity Computer 在金融产品中实现数据可追溯性,所有输出数字均链接至原始来源(如SEC文件、财报),确保准确性与可信度,重塑AI在金融决策中的可靠性标准。
入选理由:金融类产品必须保证数据输出完全可追溯,否则将丧失专业可信度。
AI代理的兴起可能迫使互联网重新设计,优先服务机器而非人类用户,引发法律与体验冲突。
入选理由:Meta的Muse应用首月下载量达500万次,代理流量在8-9月增长三倍。
Perplexity推出Decider V1.2多模态决策模型,支持文本/图像分类、路由和评分,提供27B和4B两个版本,通过AI Gateway统一调用。
入选理由:Decider V1.2 27B适合复杂判断,4B适合高吞吐量任务
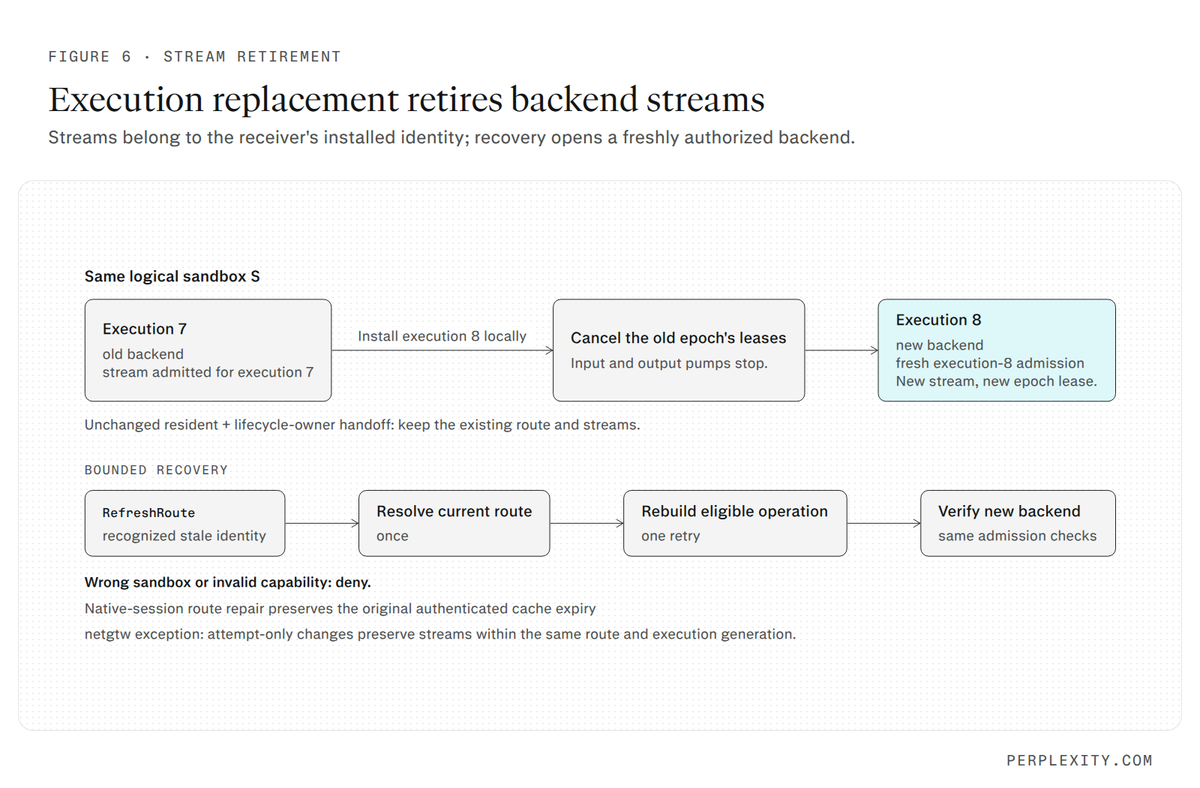
Perplexity的SPACE系统通过加密身份验证确保请求正确路由到对应的沙箱执行实例,错误率低于0.0002%。
入选理由:SPACE系统使用短期签名证明实现执行身份绑定,错误率低于0.0002%
Qdrant通过TurboQuant技术将向量大小减少21倍,同时保留99.9%的检索质量。测试基于Perplexity模型和ViDoRe数据集,但需原始向量进行重排序。
入选理由:TurboQuant技术使向量体积从856KB压缩至40KB/页(减少21倍)
Qdrant通过TurboQuant技术将向量存储体积压缩21倍,仅损失0.1%检索质量,但需原始向量重排序。
入选理由:TurboQuant技术可将向量存储体积压缩至原大小的1/21
Perplexity发布的pplx-embed-v2-late模型在MADQA数据集上达到92.4%准确率,是当前检索器中的最佳表现。
入选理由:pplx-embed-v2-late模型在MADQA数据集上达到92.4%准确率,超越其他检索器
Perplexity发布两个新嵌入模型,支持跨模态检索,在MADQA数据集上达到92.4%准确率。
入选理由:pplx-embed-v2-late模型在MADQA数据集上实现92.4%准确率
Perplexity开源了多个高性能AI模型和工具,包括多模态决策模型和本地推理引擎,性能优于现有方案。
入选理由:pplx-decider-v1-27b在11个基准测试中平均准确率达85.7%,超越Jev模型。
Perplexity推出新上下文嵌入模型pplx-embed-v2-context-9b-preview,在ConTEB和context-bench基准测试中取得新SOTA。
入选理由:pplx-embed-v2-context-9b-preview在ConTEB基准测试中达到新SOTA
Perplexity将搜索API集成至Hermes Agent,当前索引含4500亿高质量URL并计划年底达万亿级。
入选理由:Perplexity索引已包含450B+高质量URL,计划年底扩展至万亿级
Q2D-Web通过三种数据集组合提升模型性能,减少标注偏差并验证相关性定义影响。
入选理由:使用代理引用、生产网络排名和LLM扩展集三类数据提升效果
Perplexity的pplx-embed-v1-4b模型在Web Ranking和Combined数据集上以Recall@1000指标领先,Nemotron-3-Embed-8B在Citation数据集表现最佳。
入选理由:pplx-embed-v1-4b在Web Ranking数据集取得65.73的Recall@1000成绩
Perplexity推出Q2D-Web检索基准,包含19亿文档和7万查询,提供模型评估请求表单及技术报告。
入选理由:Q2D-Web基准包含19亿文档和7万个生产衍生查询
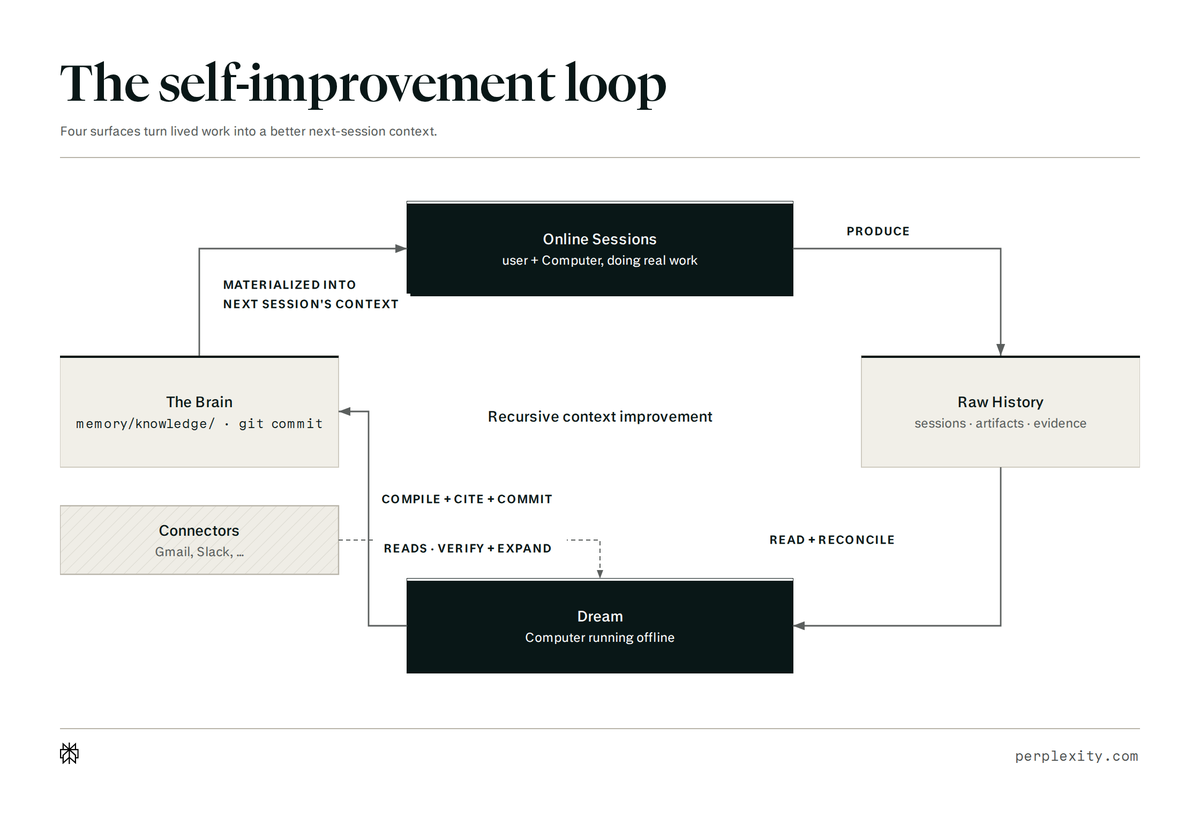
Perplexity推出的Brain系统通过结构化知识管理提升性能指标,正确性提高9.3点,时效性提高8.0点,召回率提高8.9点,同时减少15%的token使用。
入选理由:Brain系统提升正确性9.3点,时效性8.0点,召回率8.9点
Perplexity通过Dream agents实现模型持续自我优化,离线运行并确保更新一致性。
入选理由:Dream agents在离线环境中运行,避免实时干扰
Perplexity 的 Brain 通过 Agentic Memory 机制实现用户历史记录的高效管理,无需加载完整历史到每个提示中。
入选理由:Brain 采用按需加载机制,避免冗余数据传输
Perplexity Search API在Artificial Analysis搜索指数中占据前三,medium设置以每任务约$0.091的成本提升5分。
入选理由:medium设置比前导者高出5分,成本约$0.091/任务
NVIDIA推出30B参数MoE模型Nemotron 3.5 Lightning,3B活跃参数实现4倍输出速度,支持本地硬件高效运行。
入选理由:Nemotron 3.5 Lightning拥有30B总参数和3B活跃参数,适合高吞吐场景
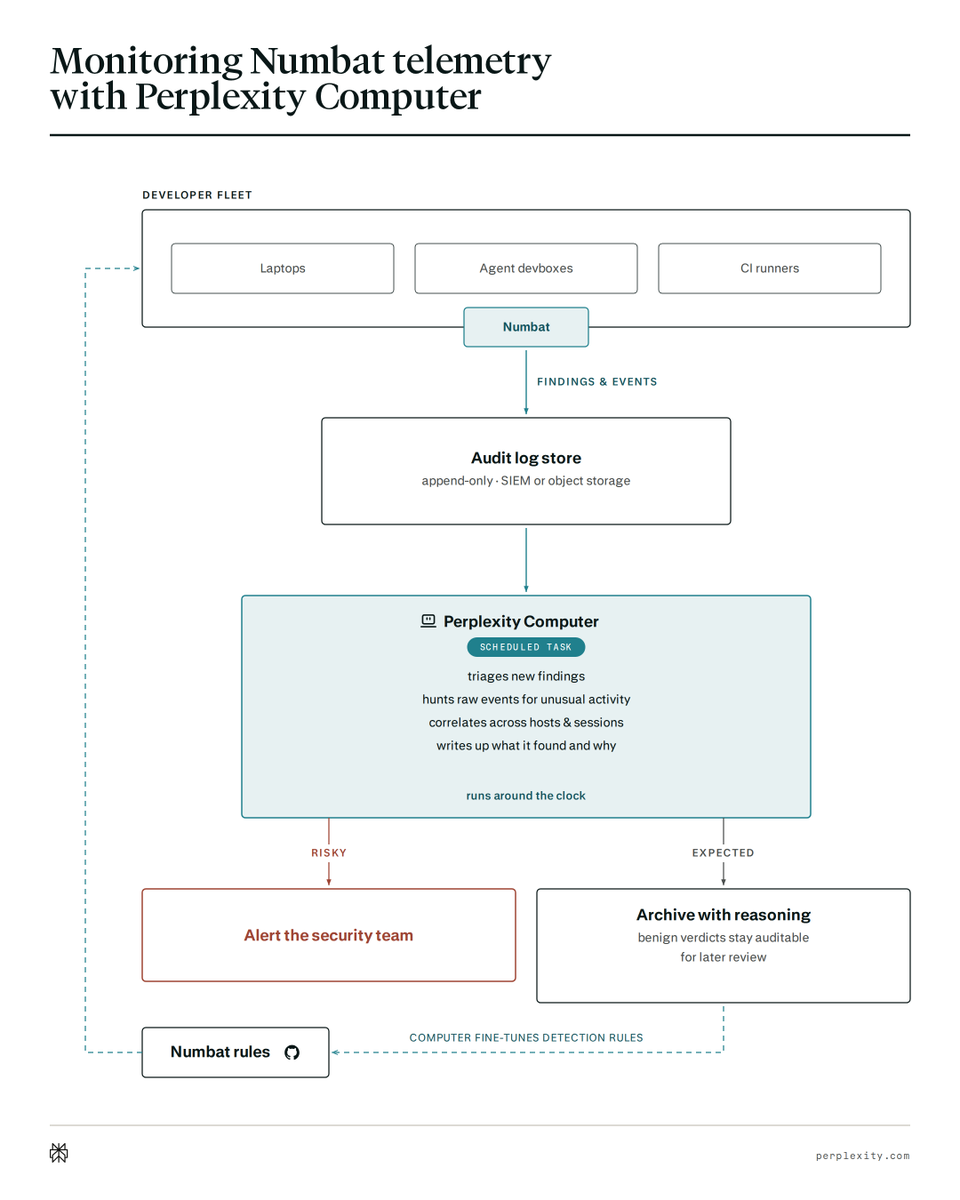
Perplexity开源了Numbat,一个跨代理的检测与响应系统,通过实时监控和持续改进机制提升安全防护。
入选理由:Numbat支持跨不同代理执行环境的统一监控
Perplexity通过SPACE机制和Firecracker微虚拟机实现沙箱隔离,任务结束后自动销毁虚拟机并保留快照数据。
入选理由:每个任务使用独立的Firecracker微虚拟机,任务结束后自动销毁
当前AI领域价值重心转向重度用户,其资源消耗远超传统预期。
入选理由:Meta工程师年均在编程工具上支出近1000万美元
Perplexity 推出 Brain,一个自我改进的上下文图谱系统,提升 Computer 的状态保持和自优化能力。
入选理由:Brain 是一个自我改进的上下文图谱系统,用于 Perplexity 的 Computer 平台。
Perplexity 的 Brain 技术通过保留上下文信息,显著提升任务处理效率和准确性。
入选理由:Brain 技术使任务正确率提升 25%,召回率提升 16%。
Perplexity Computer 的 Deep Research 功能已集成到核心系统,通过 Search as Code 架构实现并行检索,显著提升性能。
入选理由:Perplexity Computer 的 Deep Research 现在是原生功能,无需单独使用。
Perplexity 的 Search as Code 架构通过模型自动生成代码实现并行检索,显著优于传统方法。
入选理由:Search as Code 架构允许模型自动生成代码以执行搜索任务。
Perplexity Computer在实际部署中比传统搜索节省87%时间与94%成本,且提升任务完成质量。
入选理由:Perplexity Computer完成任务的时间比传统搜索少87%。
Perplexity 开源其高效的 Unigram 分词器,CPU 利用率降低 5-6 倍,显著减少延迟。
入选理由:Perplexity 开源 Unigram 分词器,CPU 利用率降低 5-6 倍。
Perplexity开源了重构的Unigram分词器,CPU利用率降低5-6倍。
入选理由:Perplexity开源了Unigram分词器,CPU利用率降低5-6倍。
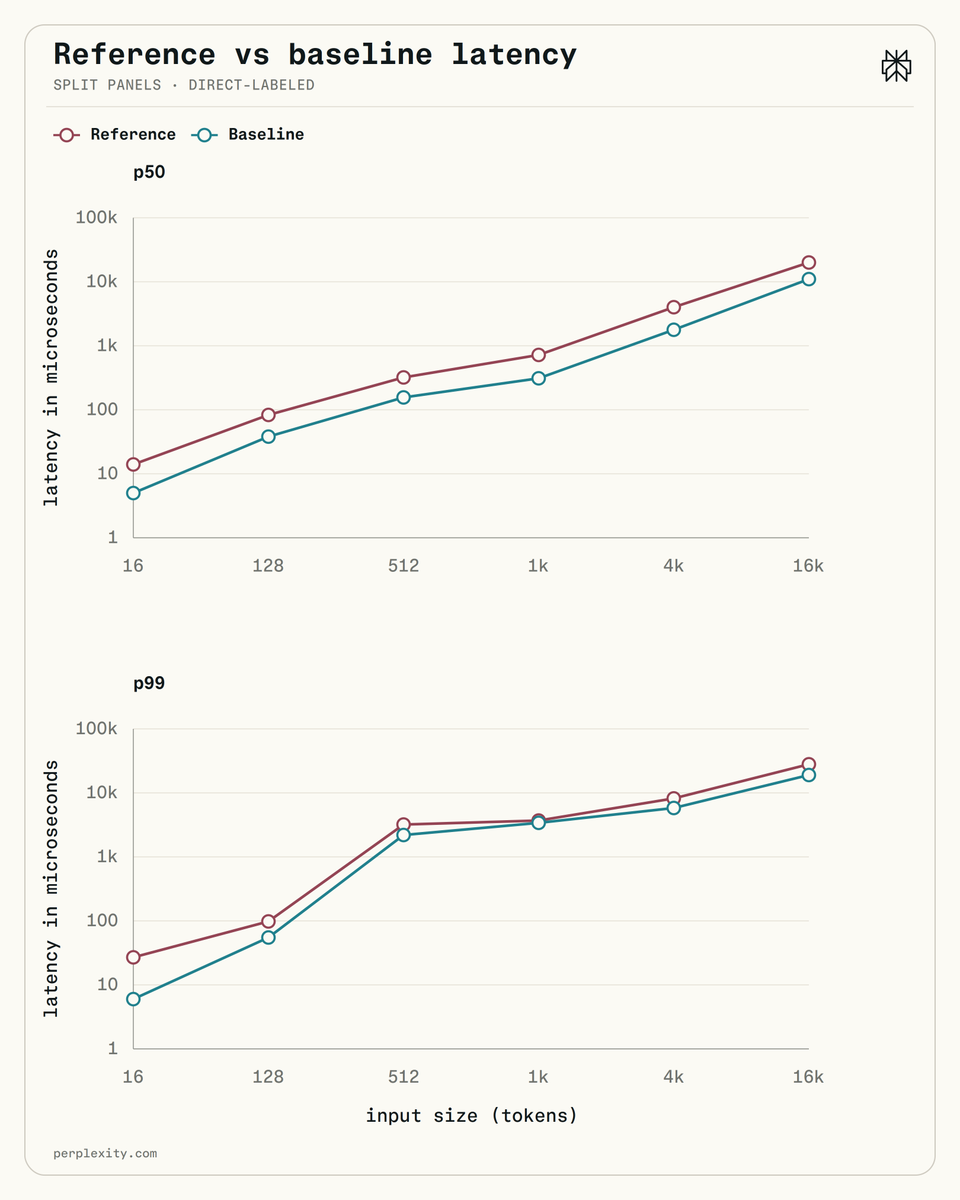
Perplexity 的编码器在生产输入长度下将 p50 延迟降低了约 5 倍,相比 HuggingFace 分词器,2 倍相比 SentencePiece C++,1.5 倍相比 IREE C。
入选理由:Perplexity 编码器在生产输入长度下延迟降低约 5 倍
与「Perplexity」经常一起出现的 AI 术语。
💡 想追踪「Perplexity」的长期趋势?去 实体雷达 · Perplexity 查看详细分析和跨材料问答。