There isn't an easy exploit for this PHP vulnerability
Hacker News Best907 字 (约 4 分钟)
85
该PHP漏洞的利用难度远高于Log4Shell等著名漏洞,且目前没有实际可行的利用方法。
入选理由:当前PHP漏洞的利用难度远高于Log4Shell,需谨慎对待。
精选文章#PHP#安全#漏洞#LLM#PoC英文
概念
也叫:Large Language Models
大型语言模型
最近变化
2026-10-21 · 当前PHP漏洞的利用难度远高于Log4Shell,需谨慎对待。
LLMs 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
已收录 30 篇与「LLMs」相关的 AI 资讯和分析。
该PHP漏洞的利用难度远高于Log4Shell等著名漏洞,且目前没有实际可行的利用方法。
入选理由:当前PHP漏洞的利用难度远高于Log4Shell,需谨慎对待。
编程职业将因AI代理兴起而发生根本性转变,传统逻辑谜题式编程工作可能消失,程序员需转向系统构建角色。
入选理由:AI代理将取代解决复杂逻辑谜题的编程工作(Jeremy Scheff观点)
Cloudflare推出Clairic,一种新型System One提取模型,能高效提取和预测结构化数据,适用于发票处理、交通预测等场景。
入选理由:Clairic在提取任务中准确率比传统LLMs高,且延迟降低50%。
Nick Cammarata提出LLMs可能比预期更易理解,引发AI安全领域重大争议,但其结论尚未被主流学界完全验证。
入选理由:Cammarata主张LLMs的内部结构可能比想象中更易解析,但斯坦福学者Chris Potts质疑其结论缺乏实证
词嵌入通过向量空间中的几何关系捕捉词语间的语义关联,是NLP中实现语义理解的关键技术。
入选理由:词嵌入将词语映射为向量,通过向量距离反映语义相似性
当前大语言模型(LLMs)缺乏真正的推理能力,AlphaGo的成功依赖于搜索机制而非直觉。
入选理由:AlphaGo通过搜索机制评估了数千种未来棋局,而非单纯依赖直觉。
机器学习研究代理通过压缩模型避免过拟合,且压缩可作为诊断工具。实验显示成功策略高度可压缩,信息瓶颈测试能区分真实结构与数据记忆。
入选理由:ML模型多次迭代后仍不因基准测试过拟合,与教科书预测矛盾
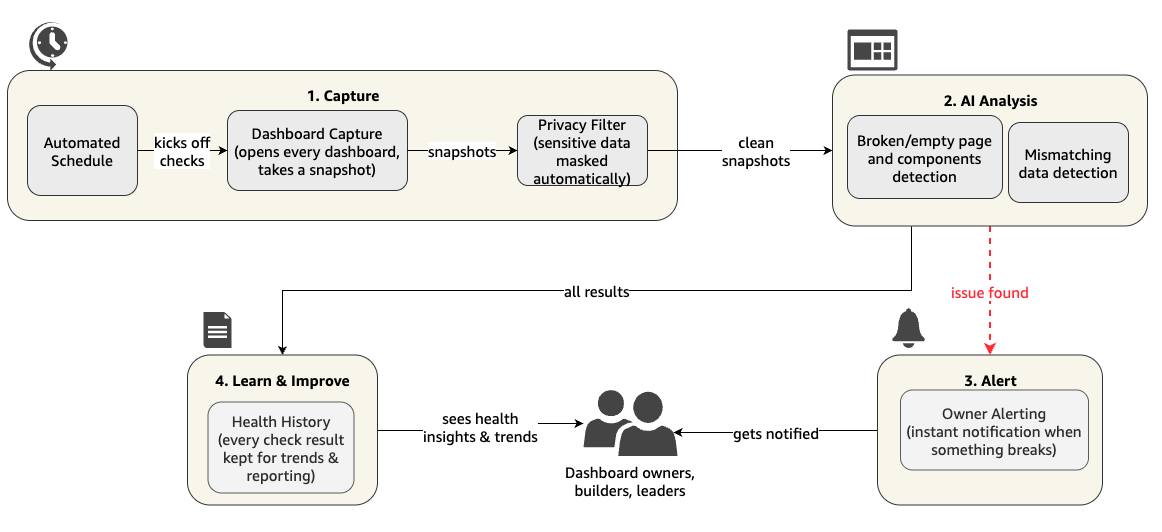
AWS团队利用Amazon Bedrock的LLM实现仪表板内容自动化验证,将故障检测时间从72小时缩短至1小时。
入选理由:使用Amazon Bedrock的LLM进行视觉和数值双重验证,覆盖802种内容故障场景
神经网络的内部表示可能隐式实现符号结构,从而在语言、逻辑等领域表现出色。研究通过数学方程近似验证了这一假设,并展示了对LLM行为的干预方法。
入选理由:神经网络的符号结构可被数学方程近似,误差低于5%
大语言模型在概率信念更新中存在系统性不一致性,非贝叶斯启发式方法在实际任务中表现更优。
入选理由:非贝叶斯启发式更新在下游任务中优于精确贝叶斯更新
Andrew Ng发布AI工程技能地图,明确构建AI应用、软件工程基础等四项核心技能,基于10,000个职位分析和专家访谈得出。
入选理由:构建AI应用需掌握LLMs、RAG等技术及统计评估方法
Anthropic工程师分享LLMs在事件响应中的实践:AI擅长日志分析但难以判断因果关系,需与人类专家协作。
入选理由:LLMs可处理90%的常规日志分析任务,但无法替代人类判断因果关系
AI代理的幻觉源于模型的错误猜测,且错误会通过代理的步骤放大,需通过评估验证。
入选理由:LLMs本质上是词猜测器,错误猜测时与正确猜测同样自信
OpenAI通过整合用户显式/隐式反馈构建了统一数据层,结合LLM管道和聚类分析实现自动化问题追踪,使截图可直接生成修复代码。
入选理由:OpenAI的反馈系统使截图能自动定位代码问题并生成pull request
DSLs通过明确边界和抽象确保LLMs生成代码的准确性,Tickloom案例展示其与LLMs的协同效应。
入选理由:DSLs提供清晰边界,使LLMs生成代码符合预期意图
UpDoc成为首个获得FDA批准的基于患者面向LLMs的医疗设备,可管理2型糖尿病患者胰岛素。其功能包括远程联系患者、调整剂量、记录决策等,基于斯坦福临床试验。
入选理由:FDA首次批准基于LLMs的医疗设备,用于糖尿病胰岛素管理
AI驱动的SOC成为公共部门应对AI网络威胁的新范式,通过自动化与人类协作降低碎片化成本并提升响应速度。
入选理由:66%的SOC每周损失1天时间整合分散工具数据
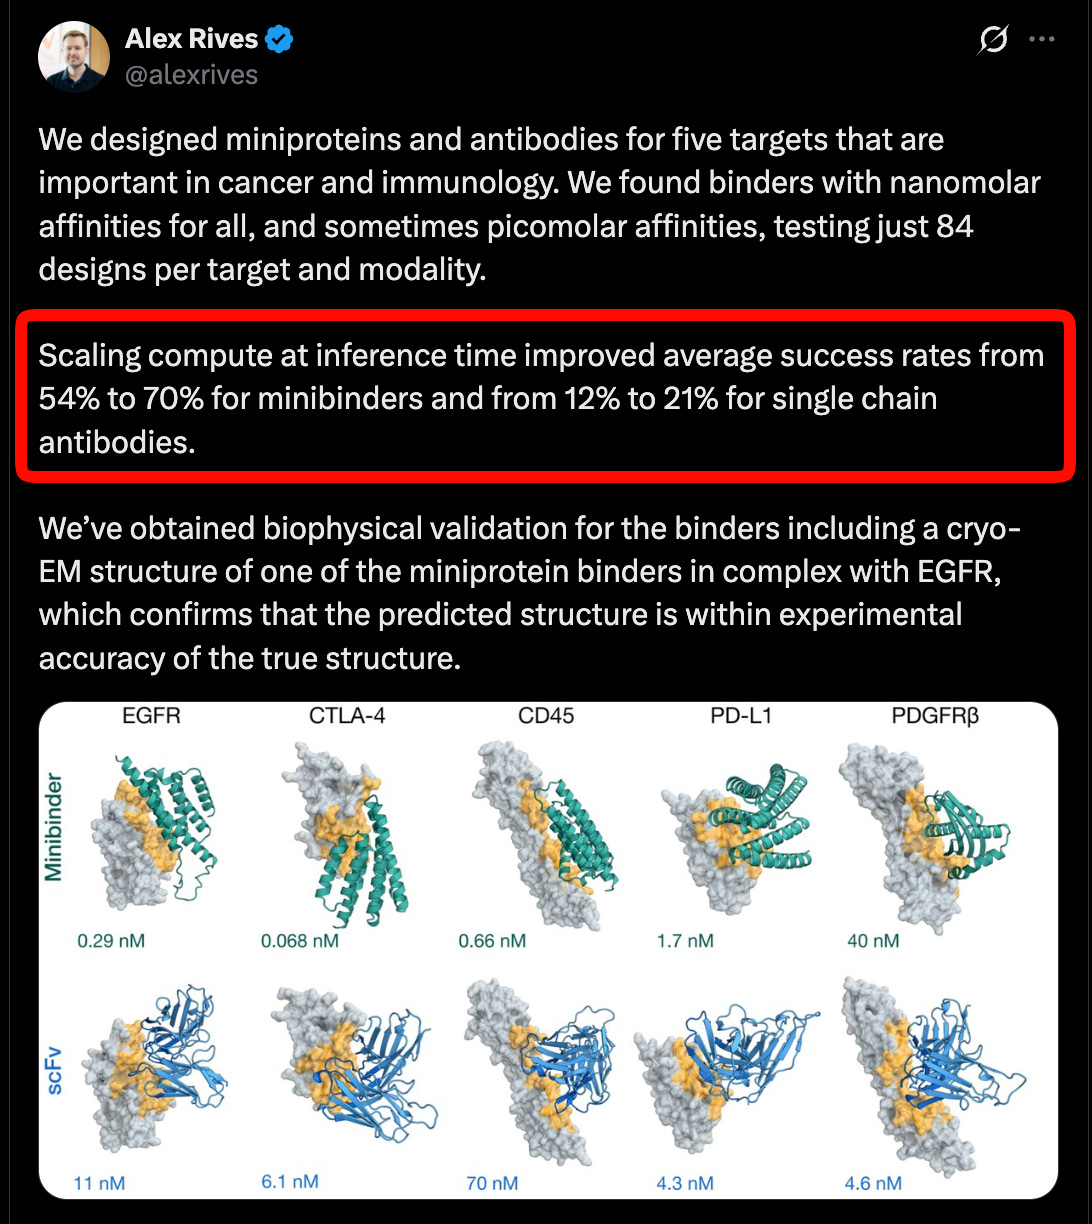
BioHub 发布 ESMFold2,展示通用语言模型在蛋白质折叠中的强大能力,挑战专有模型如 AlphaFold3。
入选理由:ESMFold2 在蛋白质相互作用预测中表现优异,尤其是抗体。
Large language models (LLMs) can replicate average responses of major household surveys, but they fail to capture the dispersion of responses, leading to a 'mode collapse' where the model's responses are too homogeneous. The paper 'Can LLMs Mimic Household Surveys?' explores this issue and attempts to address it through unlearning techniques, showing some improvement in capturing the variability of human responses.
入选理由:LLMs can accurately replicate average survey responses but fail to capture the diversity of individual responses.
LLMs生成的代码在企业级应用中面临质量差距,需通过改进开发流程和工具来解决,以实现可持续的生产级代码生成。
入选理由:Carnegie Mellon研究显示Cursor用户前三个月代码生成速度提升3-5倍,但随后因复杂度增加导致速度下降
在大语言模型时代,代码的核心价值已从机器指令执行转向概念模型设计,开发者需聚焦领域词汇和系统设计。
入选理由:LLMs使代码指令生成成本降低,但概念模型设计(如领域词汇)成为核心价值。
Karpathy在Sequoia Ascent 2026的炉边谈话中强调了LLMs超越加速现有技术的新领域,如无需代码的应用menugen、安装.md技能代替.sh脚本,以及LLM知识库处理非结构化数据的能力。
入选理由:LLMs开启新应用领域,如menugen无需传统编码即可生成输出。
LLMs可进化汇编程序进行竞争,验证器使AI在Core War中表现优异,将指数问题转为线性搜索。
入选理由:LLMs在Redcode语言零样本表现差,但结合进化算法后效果显著
MIT技术评论聚焦AI灭绝危机讨论,专家警告先进AI可能带来人类存亡风险,但需理性看待技术威胁。
入选理由:LLMs存在安全漏洞,易被攻击诱导生成危害性内容
文章探讨了AI应用开发中从使用前沿API到进行模型微调的趋势,指出随着公司和产品成熟,微调成为提升性能、降低成本的关键选择,并介绍了Modal作为新兴云提供商如何简化这一过程。
入选理由:公司和产品成熟后,越来越多转向模型微调以提升性能和降低成本。
构建未来系统时应使用可替换和迭代的基本组件,特别关注LLMs和Agent Harness的定制化。
入选理由:使用可替换和迭代的基本组件来构建未来系统。
文章探讨了如何利用大型语言模型(LLMs)进行细致阅读,提供了实际案例和益处分析,但信息密度一般。
入选理由:LLMs能帮助识别文本外延连接。
Andrej Karpathy加入Anthropic,认为未来几年大语言模型前沿研究将极具塑造性,他将重返研发并计划重新投入教育工作。
入选理由:Andrej Karpathy已加入Anthropic,将重返LLM研发一线。
Yann LeCun 认为大语言模型(LLMs)在工业流程控制和高维噪声数据理解方面价值有限,但强调长期来看,真正的智能和规划能力才是关键。
入选理由:LLMs 在工业流程控制和高维噪声数据理解方面价值有限。
网站阻止AI代理是短视行为,未来AI代理将主导在线交易,企业需调整策略以避免客户流失。
入选理由:阻止AI代理可能导致失去大量客户(如Delta、JPMorgan已限制代理访问)
与「LLMs」经常一起出现的 AI 术语。
💡 想追踪「LLMs」的长期趋势?去 实体雷达 · LLMs 查看详细分析和跨材料问答。