Image-to-WebDev Arena update: Claude Opus 5.5 (Max) by @AnthropicAI takes the #1 spot with 1749 pts,...
Claude Opus 5.5在图像到Web开发榜单登顶,成本比GPT-6 Astra低60%。
入选理由:Claude Opus 5.5 (Max) 以1749分登顶,价格16/M,比GPT-6 Astra低60%。
公司
也叫:Anthropic
人工智能公司,被提议进行Microducks评估
最近变化
2026-10-17 · Cursor用于云端基础设施与本地开发协同
AnthropicAI 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
Image-to-WebDev Arena update: Claude Opus 5.5 (Max) by @AnthropicAI takes the #1 spot with 1749 pts,...
lmarena.ai(@lmarena_ai) · 8.5 分
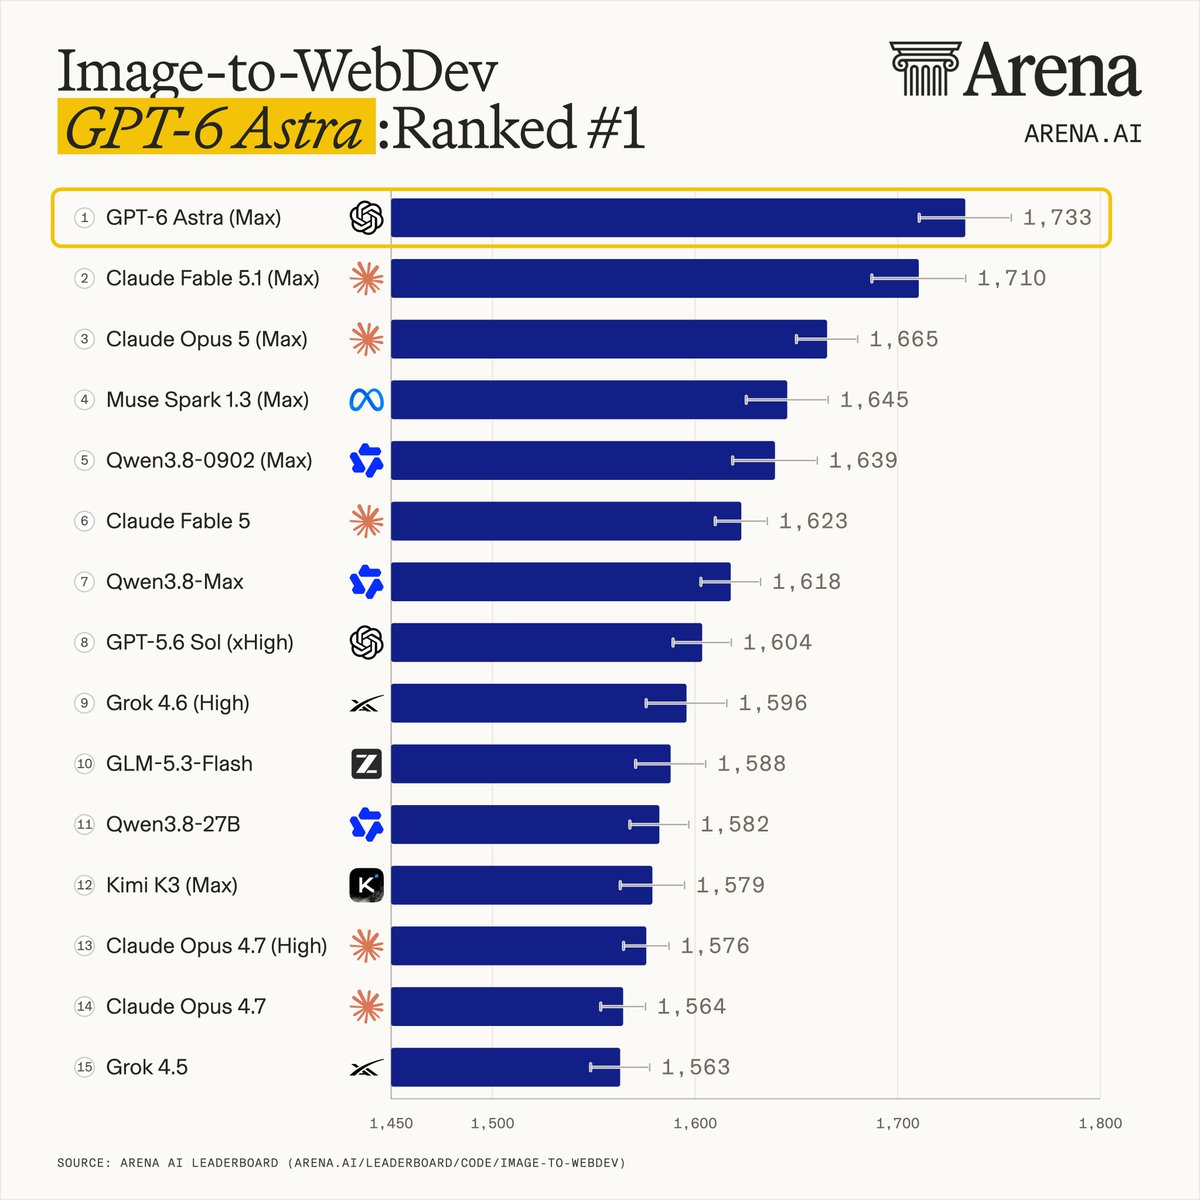
Image-to-WebDev Arena update: four newly evaluated model releases have landed! - #1 GPT-6 Astra (Ma...
lmarena.ai(@lmarena_ai) · 8.5 分
Claude Opus 4.8 debuts on Agent Arena tied #1 with GPT 5.5 (High) for Thinking & ranked #8 for Non-T...
lmarena.ai(@lmarena_ai) · 8.5 分
已收录 30 篇与「AnthropicAI」相关的 AI 资讯和分析。
Claude Opus 5.5在图像到Web开发榜单登顶,成本比GPT-6 Astra低60%。
入选理由:Claude Opus 5.5 (Max) 以1749分登顶,价格16/M,比GPT-6 Astra低60%。
GPT-6 Astra、Claude Fable 5.1等四款新模型在Image-to-WebDev Arena中发布,性能和成本效益显著提升。
入选理由:GPT-6 Astra得分1733,比GPT-5.6 Sol高129分,位列第一
Claude Opus 4.8 在 Agent Arena 上与 GPT 5.5 并列第一,但在非思考任务中排名第八。
入选理由:Claude Opus 4.8 在开启思考模式时表现优于 4.7 版本。
AnthropicAI's Claude Opus 4.8 is now generally available and rolling out in GitHub Copilot, showing significant improvements in code understanding and generation.
入选理由:Claude Opus 4.8 demonstrates a clear step forward in code understanding and generation across a range of real-world coding tasks.
测试包括与 Gemini 和 GLM 的对比,涵盖多种场景。
入选理由:Claude Opus 4.8 在 200 多项前端测试中胜过 Gemini 3.1 Pro 和 GLM 5.1。
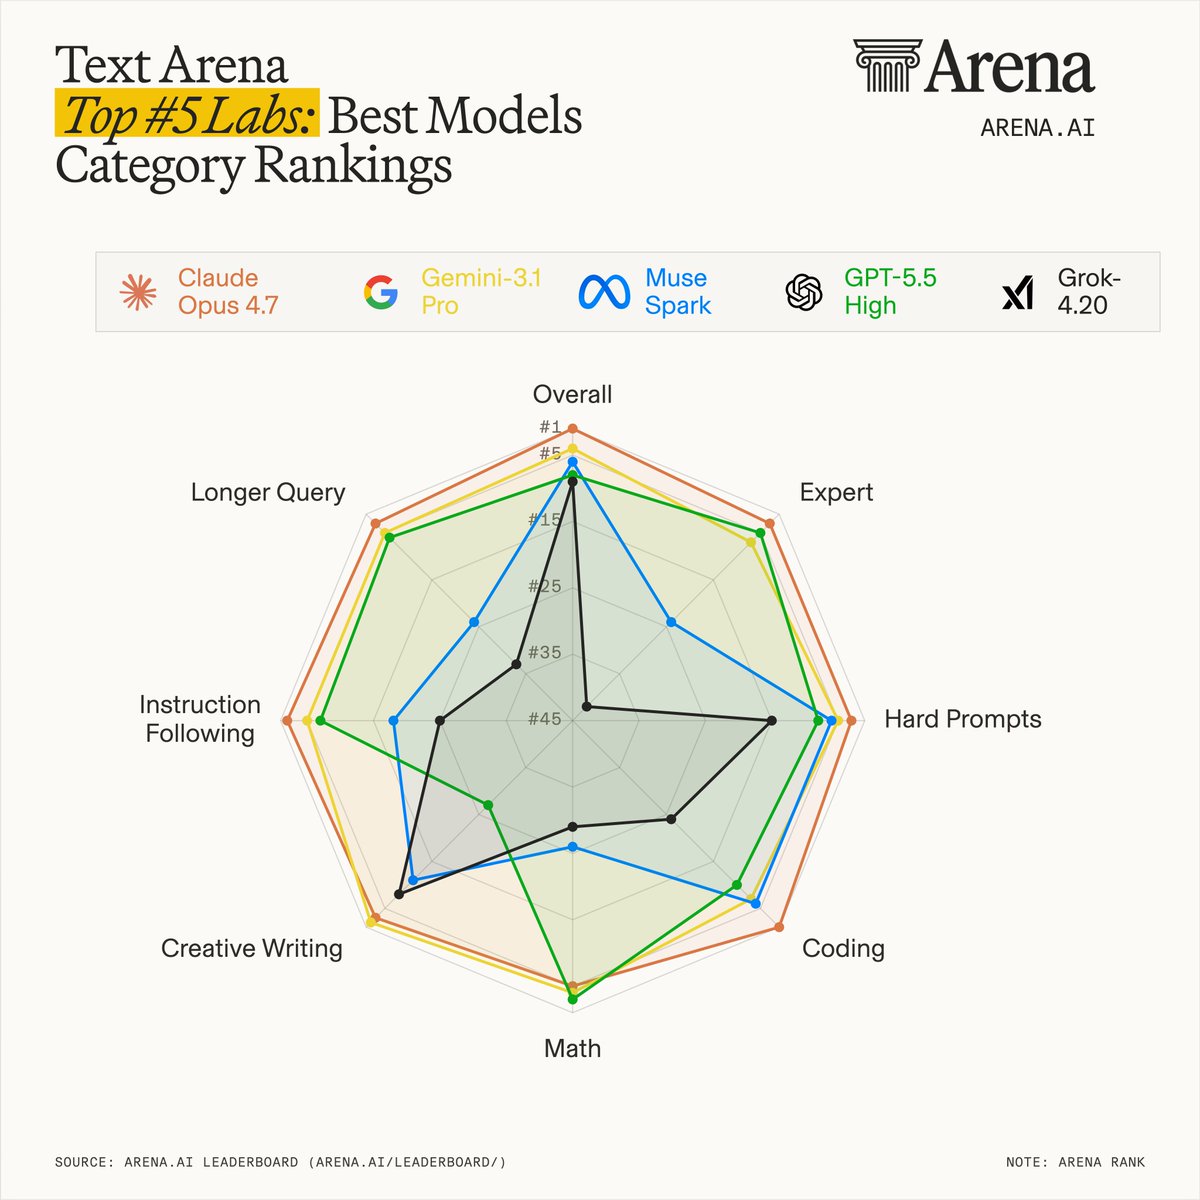
文章分析了文本竞技场排名前五的实验室及其模型,展示了前沿模型在不同领域的优势和权衡。AnthropicAI的Claude Opus 4.7表现最为全面,而Google DeepMind的Gemini 3.1 Pro在创意写作方面尤为突出。
入选理由:AnthropicAI的Claude Opus 4.7在几乎所有主要类别中都表现出色,是最具统治力的模型。
Thomas Wolf is excited about the extension of Terminal-Bench to scientific fields, known as Terminal-Bench Science. This benchmark evaluates AI models' ability to control tools via the command line to achieve scientific goals. It's open for contributions of real scientific workflows until August 2026, aiming to improve AI models' assistance in research work.
入选理由:Terminal-Bench Science evaluates AI models' performance in handling scientific workflows through command-line tools.
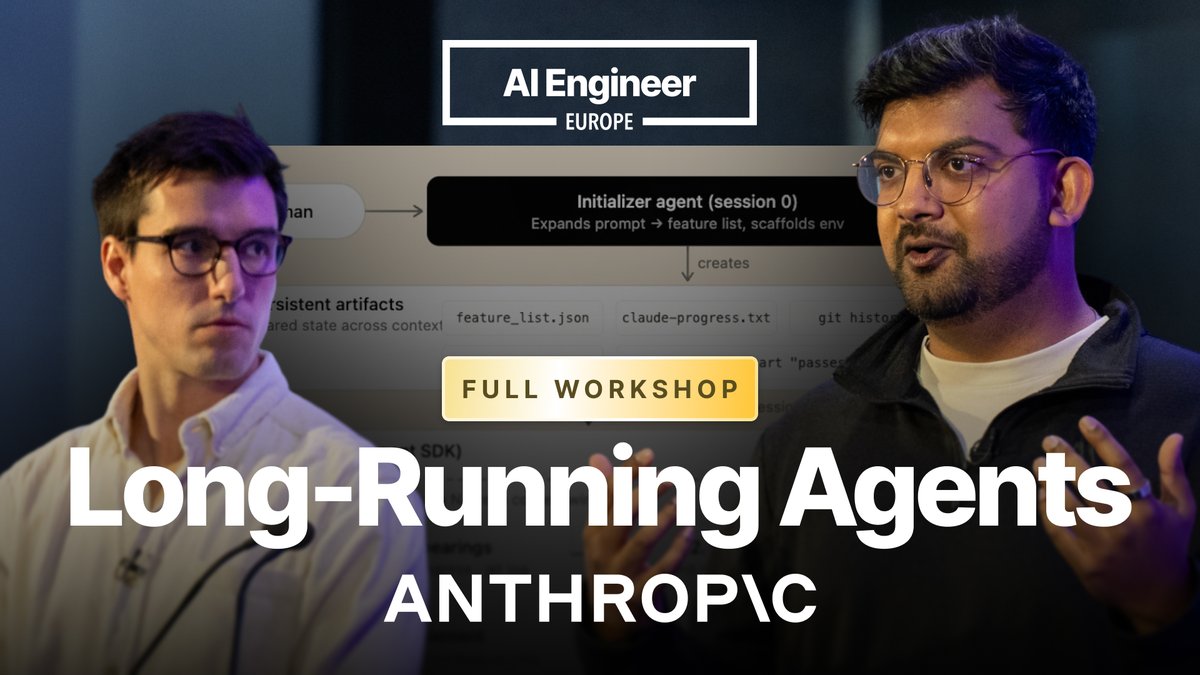
AnthropicAI 的研讨会展示了如何构建能够长时间运行的 AI Agent,解决大多数代理几秒内失效的问题。
入选理由:多数 AI Agent 在启动后几秒内即失效,难以持续运行。
Agent Arena 已上线两周,GLM-5.2 和 Claude Fable 5 表现突出,提供真实任务评估。
入选理由:GLM-5.2 (Max) 在 Agent Arena 中取得 +9.4% 的确认成功和 +14.9% 的赞誉对比。
提示工程成功依赖心智模型匹配与领域词汇掌握,需准确判断模型的一次性处理能力。
入选理由:心智模型匹配是提示工程成功的关键因素之一
AnthropicAI发布Fable 5.1模型并接入Agent Arena评估系统,采用因果追踪方法衡量模型在复杂任务中的表现。
入选理由:Fable 5.1和Mythos 5.1是当前最先进的代码与知识工作模型
Sapiom公司推出三项产品聚焦代理基础设施成本优化,获3500万美元融资,包含模型路由和运行时追踪工具。
入选理由:Sapiom推出成本感知模型路由器和Agent Studio开发平台
Claude Opus 5在Arena中测试,展示其在实际任务中的表现及Fable 5级别的智能。
入选理由:Claude Opus 5达到Fable 5级别智能,但未披露具体技术细节
Kimi K3 在前端设计竞技中超越 Fable 5 和 Claude 全系模型,成为榜首。GPT-5.6 Sol 前端能力仍不足,跌出前十。
入选理由:Kimi K3 在 Design Arena 前端设计榜单中以 Elo 1326 排名第一
中美AI差距从278%缩小至2.7%,美国仍保持领先。
入选理由:中美AI差距从278%缩小至2.7%
AnthropicAI 的快速发展得益于其内部使命一致性。
入选理由:AnthropicAI 的快速发展归功于强大的内部使命一致性。
工程师分享使用Cursor、Codex、Claude等AI工具的日常实践,但缺乏技术深度和系统性分析。
入选理由:Cursor用于云端基础设施与本地开发协同
Agent Arena 更新 Bash Recovery 信号为 Bash Reliability,当前 Claude Opus 5.5 领先 GPT-6.1 Sol 和 Claude Fable 5.1。
入选理由:Claude Opus 5.5 当前排名第一,由 AnthropicAI 提供
Anthropic的Claude Opus 5.5和Sonnet 5.5在Image-to-WebDev任务中分别获得1749和1740分,均位于Pareto前沿。
入选理由:Claude Opus 5.5在Image-to-WebDev任务中得分1749,排名第一
AnthropicAI发布Claude Sonnet 5.5模型,Augment Code计划将其集成到agent loops中。
入选理由:Claude Sonnet 5.5模型已在Cosmos平台发布
技术社区发起罕见病AI创新挑战赛,提供5万美元奖金及算力资源,但缺乏技术细节与工程实践指导。
入选理由:黑客松聚焦AI与基因组学结合解决罕见病问题
AnthropicAI的Opus 5模型在生成历史场景时存在细节问题,但展示了AI在游戏开发中的潜力。
入选理由:Opus 5模型生成的1660年纽约市场景存在运河异常、建筑边缘缺失等问题
GitHub宣布AnthropicAI的Claude Opus 5集成到Copilot,提升复杂任务处理效率。
入选理由:Claude Opus 5在代理编码工作流程中表现强劲
AnthropicAI的Claude Fable 5在Arena平台进行了60+复杂测试,展示其3D生成和世界构建能力,但缺乏技术细节。
入选理由:Claude Fable 5通过60+复杂测试验证能力
GitHub Copilot 现已支持 AnthropicAI 的 Claude Fable 5 模型,适用于长期自主编码任务。
入选理由:Claude Fable 5 是 AnthropicAI 的 Mythos 模型系列首代产品
文章介绍 Fiona Fung 在 AnthropicAI 的工作经历及成就,但信息密度低,缺乏技术深度。
入选理由:Fiona Fung 曾在 Microsoft 和 Meta 工作,参与多个重要项目。
GitHub 宣布 AnthropicAI 的 Mythos 模型系列首推 Claude Fable 5,已集成到 GitHub Copilot 中,用于长周期、自主编码和知识工作。
入选理由:Claude Fable 5 是 AnthropicAI 的 Mythos 模型系列的首个版本。
文章讨论了 Mythos 验证 VM 的过程,但信息密度较低,缺乏深度技术细节。
入选理由:Mythos 用于验证 Opus 编写的 VM。
AnthropicAI 推出 Claude Fable 5 的 Agent 模式,允许用户测试其在实际任务中的能力。
入选理由:Claude Fable 5 现在支持 Agent 模式,用于完成实际任务。
Dify 平台现已支持 Anthropic 的 Claude Fable 5 模型,提供软件工程、知识工作和视觉能力的升级。
入选理由:Dify 平台支持 Claude Fable 5 模型的集成,简化了基础设施管理。
与「AnthropicAI」经常一起出现的 AI 术语。
💡 想追踪「AnthropicAI」的长期趋势?去 实体雷达 · AnthropicAI 查看详细分析和跨材料问答。