如何从 PDF 构建金融知识图谱?
meng shao(@shao__meng)571 字 (约 3 分钟)
92
LandingAI 黑客松项目 ArthaNethra 展示了从 PDF 到可查询、可溯源、可推理的知识图谱的完整流程:上传 → ADE 提取 → 归一化 → 双库索引 → 风险检测。
入选理由:使用 LandingAI ADE 实现结构化提取,>15MB 文档走异步 + 指数退避机制
精选推文#知识图谱#金融合规#PDF 解析#Weaviate#Neo4j中文
公司
别名:weaviate_io
提供AI数据库解决方案的科技公司
已跟踪 30 条高相关材料
最近变化
2026-10-08 · Engram插件通过异步保存和提取记忆,无需手动命令。
为什么值得关注
Weaviate 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
如何从 PDF 构建金融知识图谱? LandingAI 黑客松项目「ArthaNethra」,展示了从 PDF 到可查询、可溯源、可推理的知识图谱的完整流程: 上传 → ADE 提取 → 归一化 →...
meng shao(@shao__meng) · 9.2 分
LandingAI 黑客松项目 ArthaNethra 展示了从 PDF 构建金融知识图谱的端到端流程:上传 → ADE 提取 → 归一化 → 双库索引 → 风险检测,支持 10 类实体、26 种关系,结合 Weaviate(语义检索)与 Neo4j(图遍历),实现可查询、可溯...
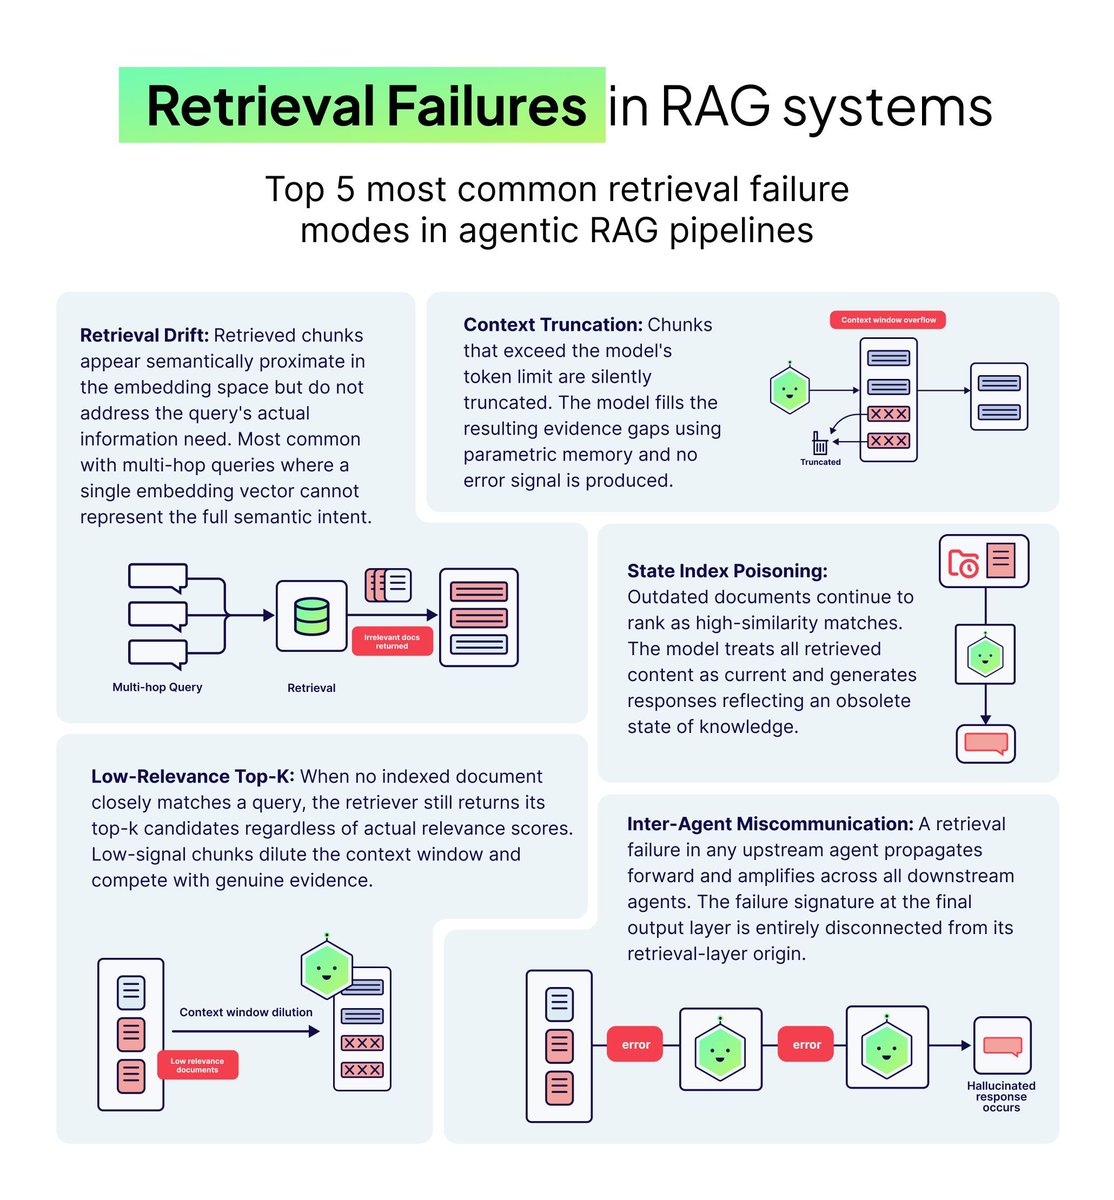
𝗬𝗼𝘂𝗿 𝗥𝗔𝗚 𝘀𝘆𝘀𝘁𝗲𝗺 𝗽𝗿𝗼𝗱𝘂𝗰𝗲𝘀 "𝗵𝗶𝗴𝗵𝗲𝗿-𝗳𝗹𝘂𝗲𝗻𝗰𝘆 ...
Weaviate • vector database(@weaviate_io) · 8.7 分
研究发现,RAG系统中检索质量差是导致高流畅性幻觉(更自信但更错误)的主因,模型升级无法弥补检索缺陷。
Your CLAUDE.md tells Claude how to work on a project. It doesn't tell Claude what you actually did t...
Weaviate • vector database(@weaviate_io) · 8.5 分
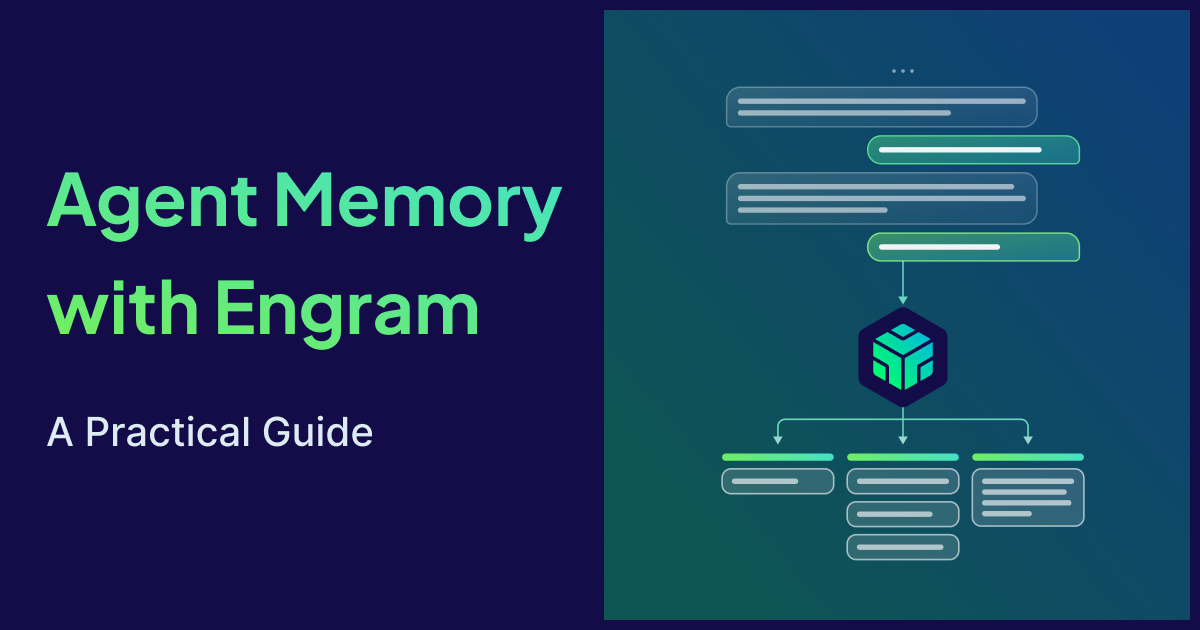
Weaviate推出的Engram插件为Claude Code提供跨会话的长期记忆功能,提升开发效率。
已收录 30 条与 Weaviate 相关的内容,按评分排序。
LandingAI 黑客松项目 ArthaNethra 展示了从 PDF 到可查询、可溯源、可推理的知识图谱的完整流程:上传 → ADE 提取 → 归一化 → 双库索引 → 风险检测。
入选理由:使用 LandingAI ADE 实现结构化提取,>15MB 文档走异步 + 指数退避机制
研究发现,RAG系统中检索质量差是导致高流畅性幻觉(更自信但更错误)的主因,模型升级无法弥补检索缺陷。
入选理由:检索质量差是RAG输出退化的最主要预测指标,模型能力增强反而加剧幻觉可信度。
Weaviate推出的Engram插件为Claude Code提供跨会话的长期记忆功能,提升开发效率。
入选理由:Engram插件通过异步保存和提取记忆,无需手动命令。
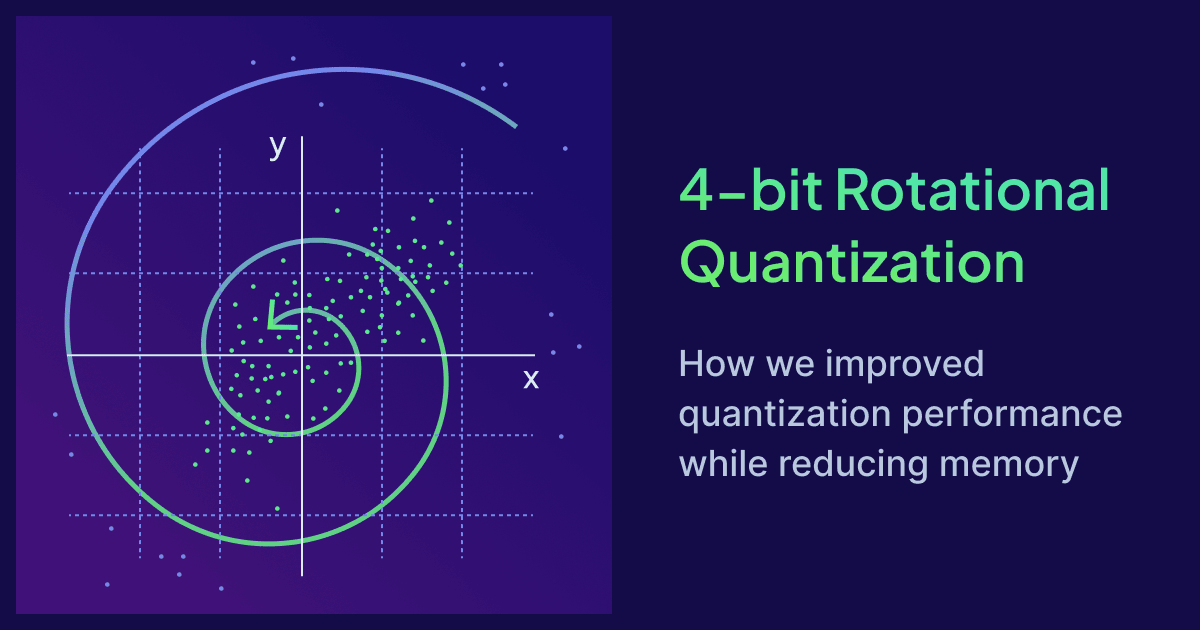
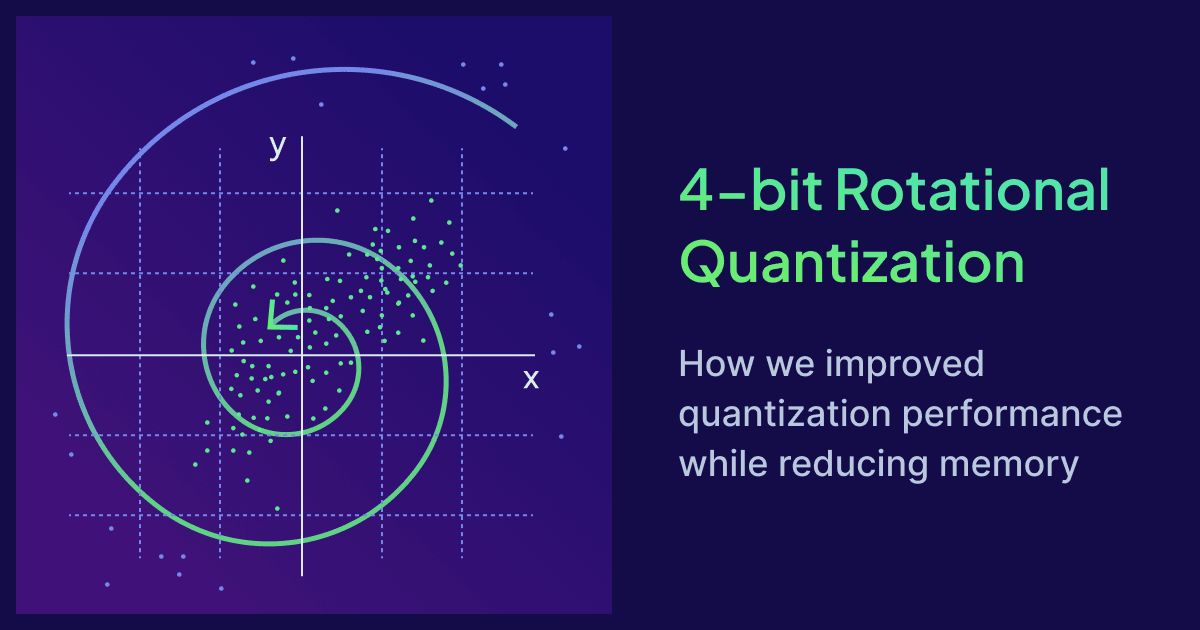
Weaviate 1.39通过4位旋转量化技术实现向量搜索性能提升3.8倍,内存占用减少45%,并引入SIMD加速的FWHT转换。
入选理由:4位RQ在保持相似召回率情况下减少45%堆内存使用
Engram通过异步处理和主题描述机制,实现代理记忆的自动化管理,影响检索模式和提示位置的四个关键决策。
入选理由:Engram使用异步管道处理原始数据,提取并转换记忆
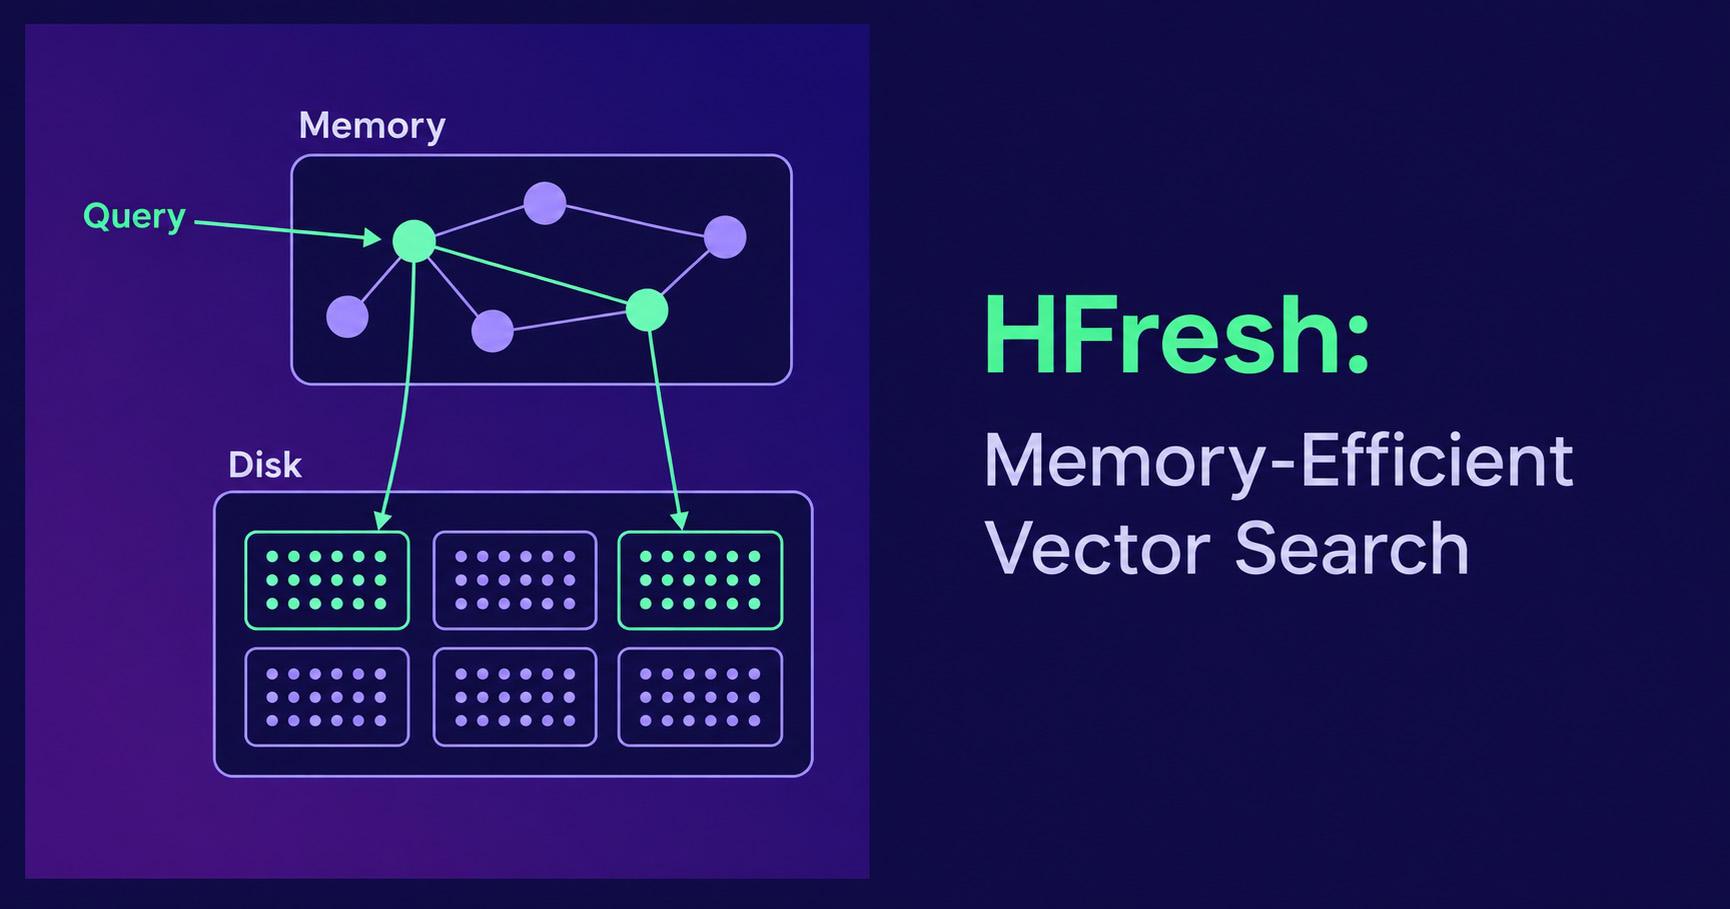
向量索引选择需权衡性能与内存效率,HNSW适合高吞吐场景,HFresh通过压缩技术优化内存使用。
入选理由:HNSW在低延迟和高查询吞吐场景表现最优
将AI记忆视为不断增长的聊天历史会导致性能下降,Weaviate的Engram通过异步处理优化记忆管理。
入选理由:Engram通过异步处理提取、对比、解决矛盾的四步流程优化记忆管理
Weaviate 1.39 引入 4 位旋转量化,减少内存使用并提升性能,同时保持高召回率。
入选理由:4 位旋转量化减少内存占用,同时保持强召回率。
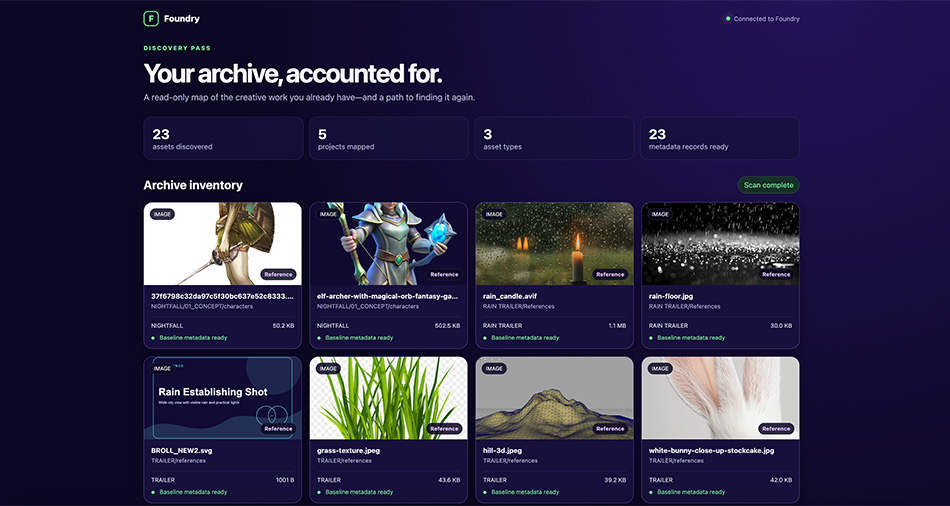
Weaviate的Foundry工具通过扫描现有档案并生成可搜索的创意库,实现高效的内容检索,无需重命名或移动文件。
入选理由:Foundry通过只读扫描生成清单,无需修改原始文件。
HFresh是Weaviate推出的基于磁盘的向量索引,通过分区和两阶段搜索策略实现低内存使用和大规模数据集的高效查询。
入选理由:HFresh将内存使用降低到传统HNSW的1/10,适合资源受限场景
Weaviate通过多向量检索技术实现PDF图像级搜索,无需OCR和文本提取即可定位图表信息。
入选理由:Weaviate的late-interaction多向量检索可直接处理PDF图像,无需OCR转换
Weaviate数据库新推出的Ask Mode模式让用户可自主选择查询时的评估流程,在速度与准确性间取得平衡。
入选理由:设置result_evaluation为'none'可使响应速度提升30%并降低50%成本
Weaviate 1.38 新增 Boost API,通过查询时重新排序解决硬过滤条件过严问题,提升搜索结果相关性。
入选理由:Boost API 支持结合最多20个条件调整搜索权重
Weaviate 1.39发布Boost API和MMR多样性选择,4-bit量化预览提升搜索性能,开源社区功能持续优化。
入选理由:Boost API实现查询时动态重排序,支持过滤/数值衰减等条件组合
Weaviate提出Late Interaction RAG方法,通过多向量模型直接解析PDF图表,解决传统RAG无法提取图表信息的缺陷。
入选理由:传统RAG处理PDF图表时,30%的查询会因图表信息缺失导致错误
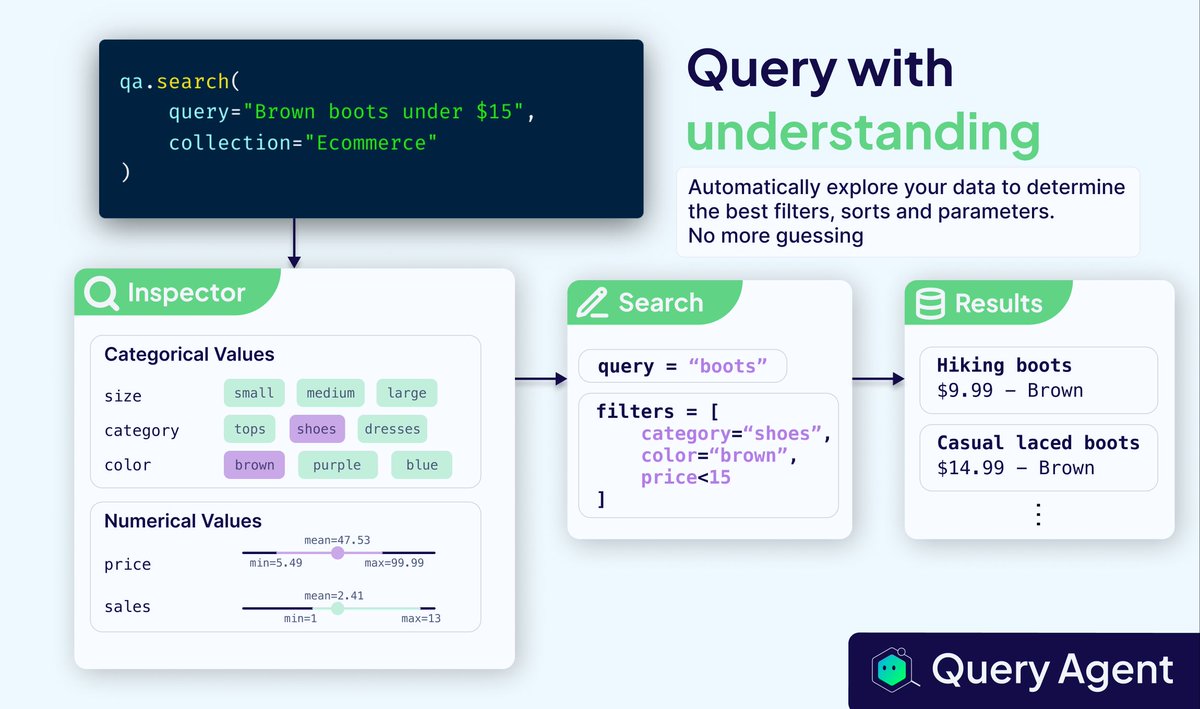
Weaviate的Query Agent现在在搜索前自动探索数据,提升过滤和搜索效率,无需手动配置。
入选理由:Query Agent自动识别过滤值和数值属性统计信息(如平均值、中位数)
可靠代理式RAG需控制信息到达模型的方式,而非单纯优化提示词。Weaviate提出上下文工程的五大系统框架。
入选理由:查询增强需重构用户输入以提升检索精度
RAG技术因文本转换瓶颈限制多模态能力,Weaviate联合Gemini Embedding 2实现原生多模态向量嵌入。
入选理由:多模态RAG跳过文本转换步骤可保留原始媒体语义
Weaviate 1.39发布,新增Boost API、MMR多样性选择等特性,优化搜索与存储效率。
入选理由:Boost API允许在查询时动态调整搜索结果排序,无需丢弃数据。
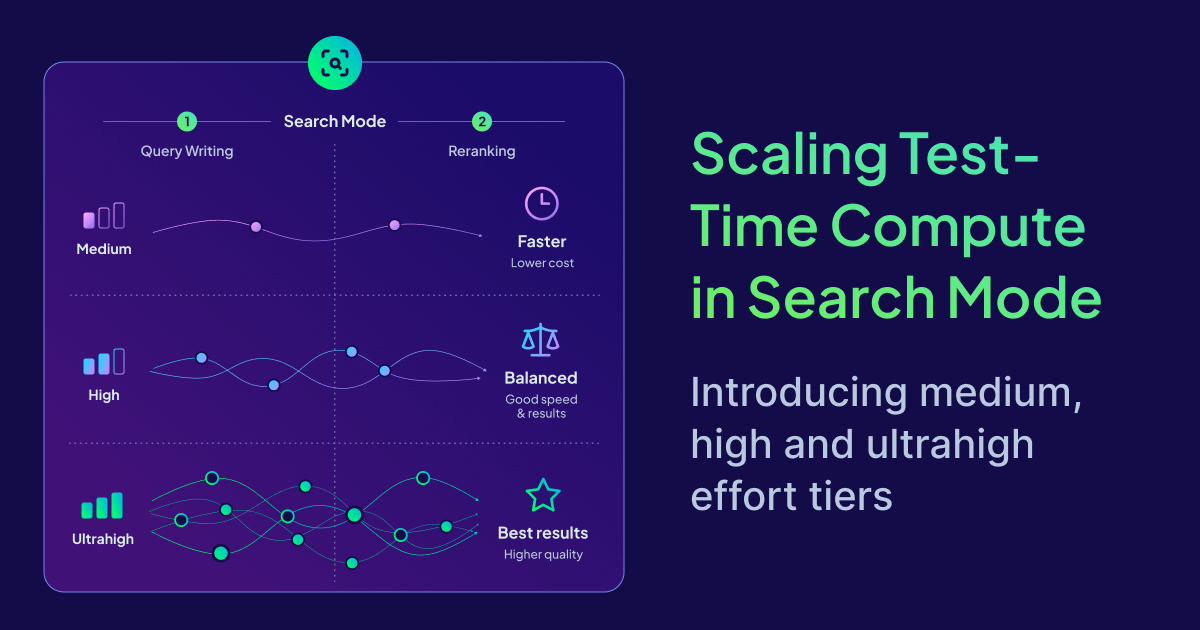
Weaviate的Search Mode通过调整effort参数显著提升检索效果,ultrahigh级别在BRIGHT Biology基准上将nDCG@10从13.0提升至57.5。
入选理由:Search Mode的ultrahigh effort在BRIGHT Biology基准上提升nDCG@10至57.5
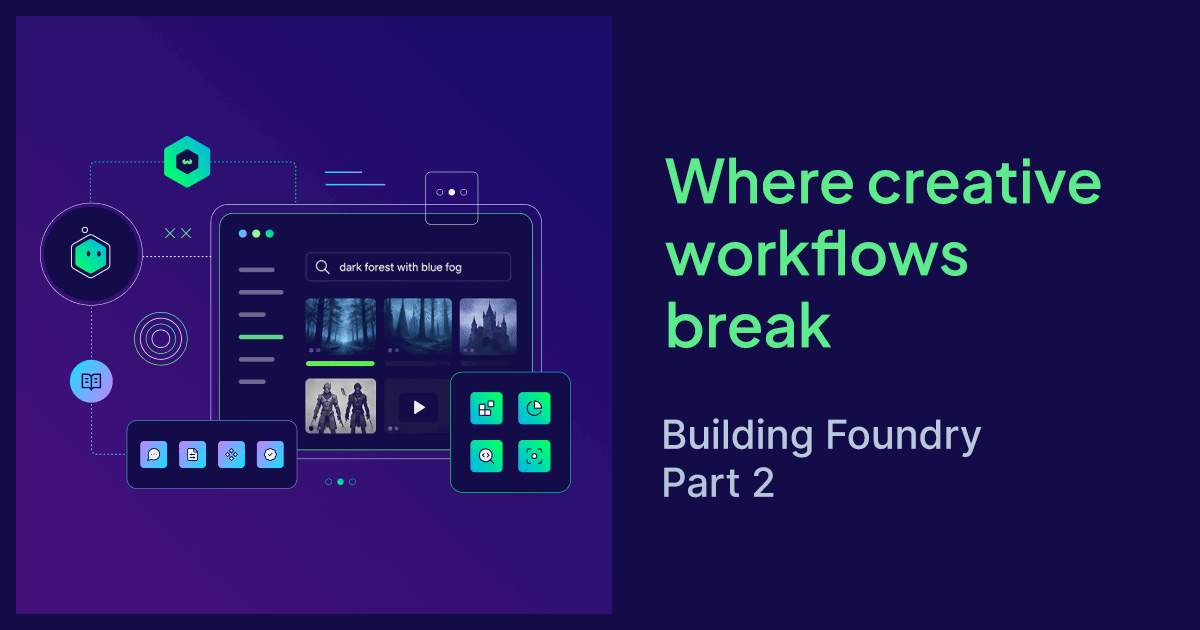
创意工作流程在文件夹结构、标签系统和关键词搜索三个层面存在根本性失效,导致项目规模扩大后检索效率骤降。
入选理由:文件夹结构在跨团队协作时产生30%以上的元数据不一致
Weaviate推出的Query Agent新增Suggest Queries模式,通过自动生成建议查询提升AI聊天界面的用户体验。
入选理由:Suggest Queries模式支持两种场景:对话启动时生成引导问题,对话中生成自然追问
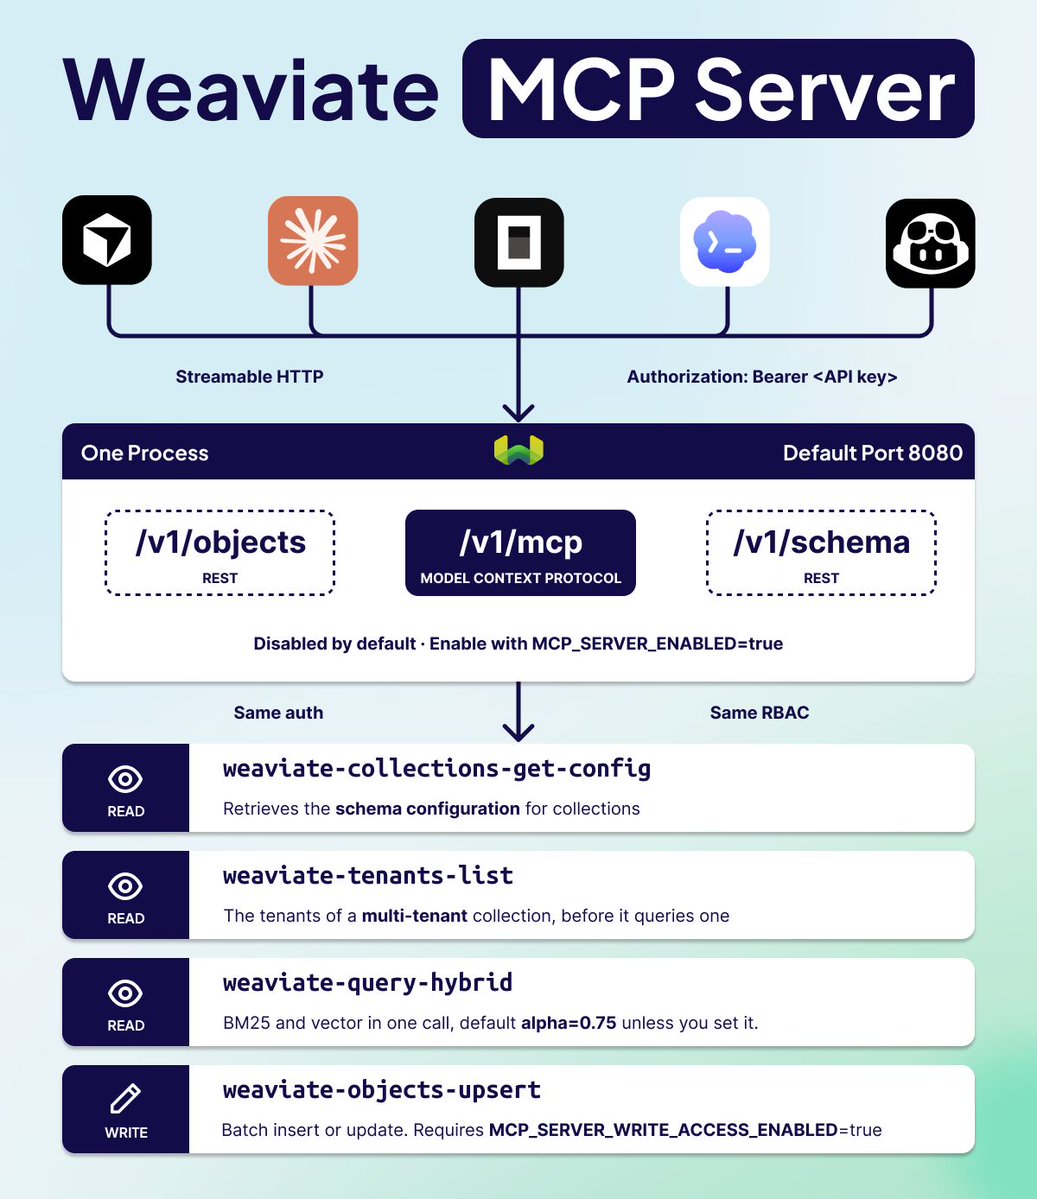
Weaviate数据库新增MCP协议支持,允许直接通过/v1/mcp端点进行操作,无需独立服务。提供四个工具实现配置查询、租户管理、混合搜索和对象操作。
入选理由:Weaviate通过/v1/mcp端点原生支持MCP协议,兼容Claude Code/Cursor/VS Code
Weaviate推出Search Mode的effort参数,允许用户通过调整计算资源提升搜索质量,但需权衡性能与成本。
入选理由:Search Mode提供medium/high/ultrahigh三级effort参数控制计算资源投入
Weaviate推出可配置召回率与精确率权衡的Query Agent搜索模式,工程师可按需选择多查询召回或单查询精确策略。
入选理由:recall模式通过多查询提升相关性结果数量,适合优先考虑覆盖率的场景。
AI通过优化检索系统减少创意工作中的摩擦,而非取代创造力。文章揭示了创意行业普遍存在的文件检索困境,并提出AI驱动的解决方案。
入选理由:创意行业70%时间消耗在文件检索与版本管理而非创作本身
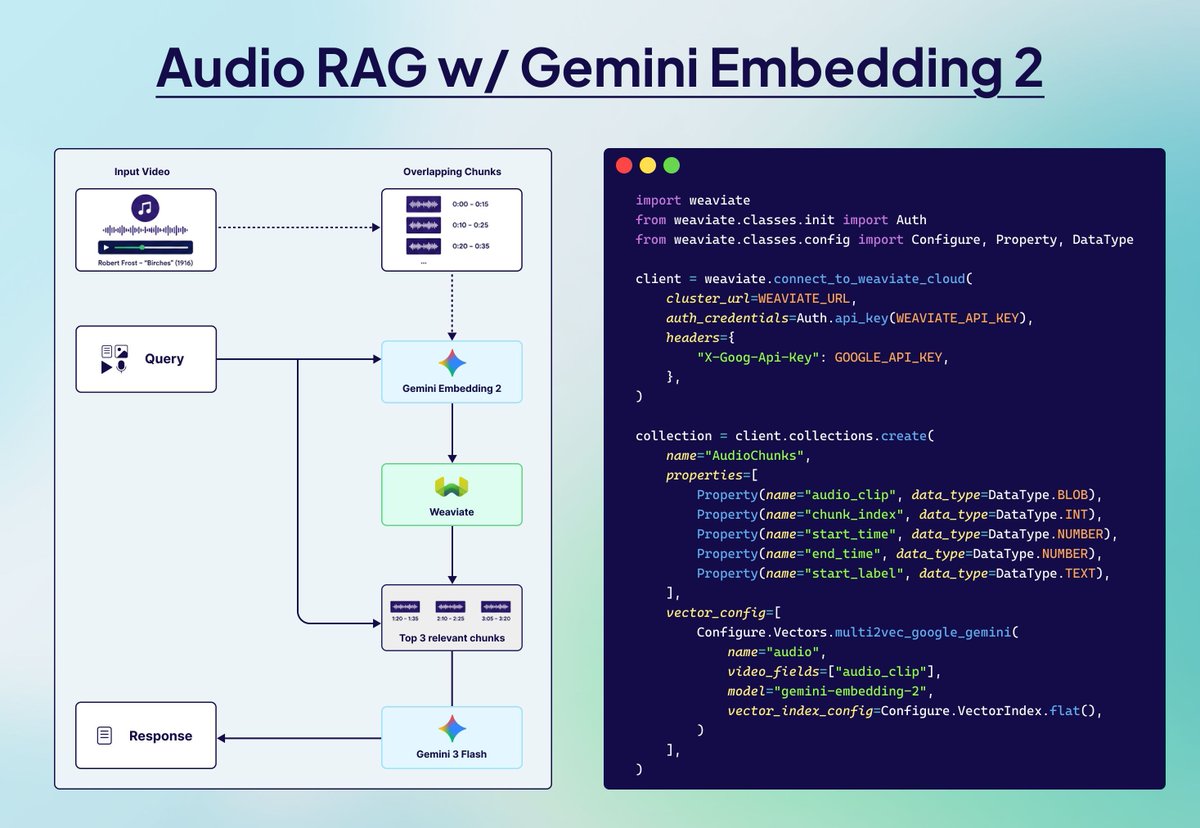
本文展示如何使用Weaviate和Gemini模型直接处理音频,无需转录文本。通过音频分块、多模态嵌入和向量检索技术,实现音频内容的高效存储与检索。
入选理由:使用Gemini Embedding 2生成音频多模态嵌入向量
Weaviate推出查询性能分析功能,可精准定位慢查询的瓶颈。通过per-query profiling直接返回各阶段耗时,无需重启或等待查询变慢。
入选理由:启用query_profile标志可获取每个查询的详细性能分析
Weaviate 的 Engram 系统通过异步流水线实现多代理记忆管理,支持无阻塞学习与去重。
入选理由:Engram 通过提取、转换、提交三步骤处理多代理记忆,避免重复和阻塞。
增加上下文窗口无法解决agentic RAG管道问题,核心在于上下文工程。长上下文会引入矛盾信息,需通过五层系统设计控制信息流。
入选理由:RAG管道需优化查询增强、检索、记忆、工具和代理五层系统