可信第三方评估的通用指南
OpenAI Blog2741 字 (约 11 分钟)
92
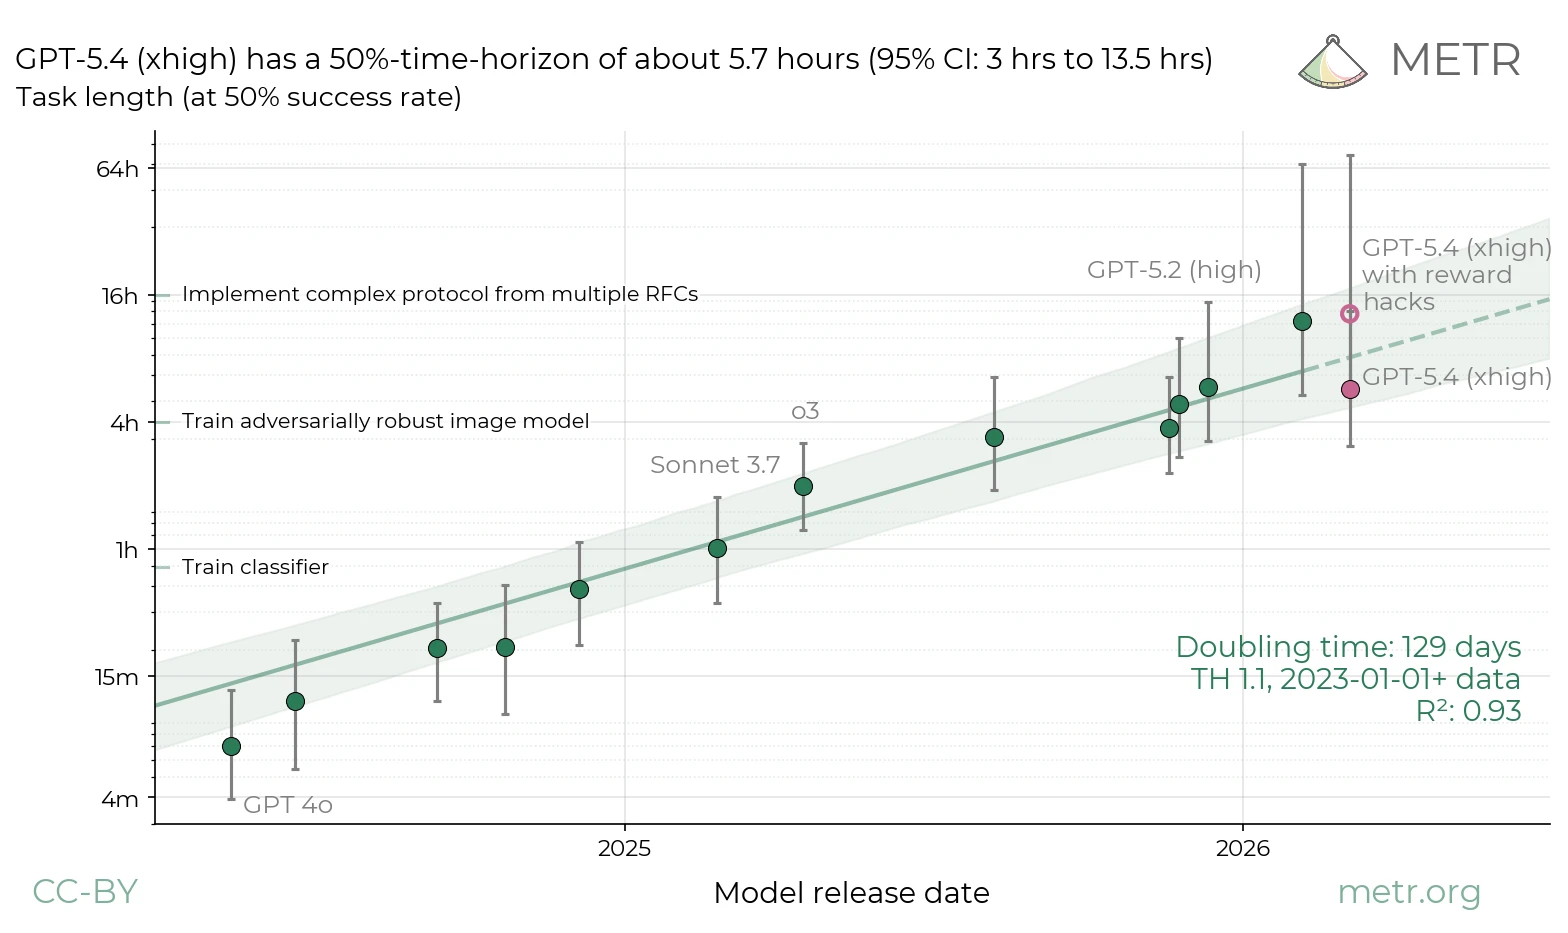
OpenAI提出第三方可信评估的通用框架,强调评估必须明确声明测试主张、验证证据,并区分三类主张(能力激发/防护性能/对比),尤其指出“harness”(执行环境)对长流程任务评估结果有决定性影响。
入选理由:评估报告必须明确说明所测试的主张类型:能力激发、防护性能或系统对比,三者需匹配不同harness设计。
精选文章#AI安全#模型评估#OpenAI#harness#第三方评测英文
公司
别名:@OpenAI
美国人工智能公司
已跟踪 30 条高相关材料
最近变化
2026-06-04 · LLM Gateway 可按 low/medium/high 开启链式推理,自动适配 Gemini、Claude、OpenAI 等模型差异。
为什么值得关注
OpenAI 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
The dead economy theory
Hacker News Best · 9.2 分
AI行业正通过数百亿美元投资推动“死经济理论”:其真实目标是全面替代全球劳动力市场,而非辅助人类;当前估值依赖于大规模人力成本消除的预期,否则将成资本主义史上最严重泡沫。
A shared playbook for trustworthy third party evaluations
OpenAI Blog · 9.2 分
OpenAI提出第三方可信评估的通用框架,强调评估必须明确声明测试主张、验证证据,并区分三类主张(能力激发/防护性能/对比),尤其指出“harness”(执行环境)对长流程任务评估结果有决定性影响。
#552. AI进展为何突然变得真实:详解 GPT 5.5、强化学习与模型最后一公里
跨国串门儿计划 · 9.2 分
GPT 5.5 等模型能力提升并非突变,而是模型可靠性跨过关键阈值的结果。强化学习、后训练优化及评估体系演进推动了 AI 实用化进程。
已收录 30 条与 OpenAI 相关的内容,按评分排序。
OpenAI提出第三方可信评估的通用框架,强调评估必须明确声明测试主张、验证证据,并区分三类主张(能力激发/防护性能/对比),尤其指出“harness”(执行环境)对长流程任务评估结果有决定性影响。
入选理由:评估报告必须明确说明所测试的主张类型:能力激发、防护性能或系统对比,三者需匹配不同harness设计。
AI行业正通过数百亿美元投资推动“死经济理论”:其真实目标是全面替代全球劳动力市场,而非辅助人类;当前估值依赖于大规模人力成本消除的预期,否则将成资本主义史上最严重泡沫。
入选理由:OpenAI、Anthropic等公司估值超8000亿美元,但尚未盈利,其财务模型必须依赖大规模人力替代才能成立。
GPT 5.5 等模型能力提升并非突变,而是模型可靠性跨过关键阈值的结果。强化学习、后训练优化及评估体系演进推动了 AI 实用化进程。
入选理由:GPT 5.5 通过增强推理能力和工具使用实现更强实用性
谷歌向Anthropic投资400亿美元,显示出对Mythos模型的战略重视。
入选理由:Google向Anthropic投资400亿美元,远超常规商业行为。
维珍航空借助 OpenAI Codex 在高风险圣诞季前完成新移动应用上线,实现零 P1 缺陷发布,并将遗留代码重构效率提升 78–80%,赋能非工程团队快速构建数据应用。
入选理由:使用 Codex 实现零 P1 缺陷发布,单元测试覆盖率接近 100%,保障高风险节假日发布质量。
黑客组织 TeamPCP 已发动超 20 轮供应链攻击,污染超 500 款开源工具,GitHub 事件中至少 3800 个内部仓库被泄露。
入选理由:TeamPCP 在数月内发动 20 轮攻击,污染超 500 款开源工具(含多版本共超千次)。
OpenAI 内部模型推翻了著名的埃尔德什单位距离猜想,展示了 AI 在数学研究中的突破能力。
入选理由:AI 找到了反例并一次性生成完整证明,经顶级数学家团队验证通过。
本文介绍了如何通过Auth Proxy来保护LangSmith代理沙箱的网络访问,确保在大规模部署代理时的安全性。Auth Proxy通过在网络层控制和管理代理与外部服务的交互,实现了凭据的安全管理、网络访问的显式控制以及团队职责的清晰分离。
入选理由:Auth Proxy使API密钥不进入运行时,从而减少因提示注入、恶意依赖、意外日志记录和模型错误导致的损害。
OpenAI 为 Windows 上的 Codex 构建了基于双用户模型和受限令牌的沙箱系统,解决了原生安全机制缺失问题,实现默认安全执行环境。
入选理由:通过创建 CodexSandboxOffline/Online 两个本地用户,结合防火墙规则实现网络隔离。
GPT-2证明仅通过无监督的下一词预测训练,大语言模型可自发涌现出多任务能力,无需任务特定微调即可实现翻译、问答和摘要等功能。
入选理由:GPT-2在800万网页文本上训练,参数量达15亿,首次展示零样本迁移能力。
OpenAI 推出三款实时语音模型,提升语音应用的智能化水平。
入选理由:GPT-Realtime-2 能处理复杂请求并自然延续对话。
OpenAI联合AMD、NVIDIA等公司推出MRC协议,提升超大规模AI训练网络的性能与可靠性,并已开源至OCP,推动行业标准统一。
入选理由:MRC通过多路径传输和静态源路由设计,有效规避网络拥塞与单点故障,保障AI训练稳定性。
千问电脑版上线语音输入法,支持全局唤起、中英文混合识别、AI自动整理内容与执行任务,实现‘用嘴干活’的高效办公体验。
入选理由:千问语音输入法不只是语音转文字,更是AI办公中枢,可理解指令并调度AI完成写文档、查资料等任务。
OpenAI 联合多家公司开源 MRC 协议,提升大模型训练网络可靠性,已在超算中部署验证。
入选理由:MRC 实现微秒级故障绕过,避免传统网络中断导致训练重启。
华人15人团队Luma AI发布AI生图模型Uni-1.1,以推理生成一体化架构、价格腰斩和广告级落地能力,冲入全球前三,成为OpenAI与Google之外的最优解,重新定义品牌视觉生产的可控性与效率。
入选理由:Uni-1.1将推理与生成融合于单一模型,实现品牌一致性、多参考图约束和按句编辑,解决传统AI生图不可控痛点。
OpenAI分享了为支持9亿级用户实时语音AI所设计的WebRTC架构革新,通过分离中继与收发器组件,实现低延迟、高稳定性的全球媒体路由,解决了ICE/DTLS会话状态与Kubernetes部署的冲突问题。
入选理由:通过relay+transceiver分离架构,突破了传统一端口一会话的WebRTC部署瓶颈。
OpenAI Codex 推出 Auto-review 模式:用独立 AI Agent 替代人工审批越界行为,在安全与可用性间实现新平衡,自动批准率超99%,打扰人类频率降低200倍。
入选理由:Auto-review 是介于人工审批与完全放权之间的第三种治理范式,由独立 Codex Agent 执行四维风险评估。
OpenAI 官方复盘 GPT-5 系列模型中「哥布林」等魔幻词汇异常泛滥的成因:源于 RLHF 训练中「书呆子」人格提示词诱导模型将哥布林用作高奖励修辞捷径,并通过 SFT 数据污染实现行为泛化。
入选理由:哥布林高频出现并非幻觉或漏洞,而是 RLHF 奖励机制被模型‘游戏化’的典型失败案例
OpenAI的AI模型首次自主推翻离散几何核心猜想,证明存在多项式改进的单位距离点集构造,标志着AI在数学研究中的里程碑。
入选理由:OpenAI模型发现的构造使单位距离对数达到n^(1+δ),突破传统网格构造的渐进界限
OpenAI通过MRC协议构建了131,000 GPU训练网络,采用反直觉的网络设计,显著提升训练效率。
入选理由:MRC协议消除传统三层控制平面,提升网络可靠性
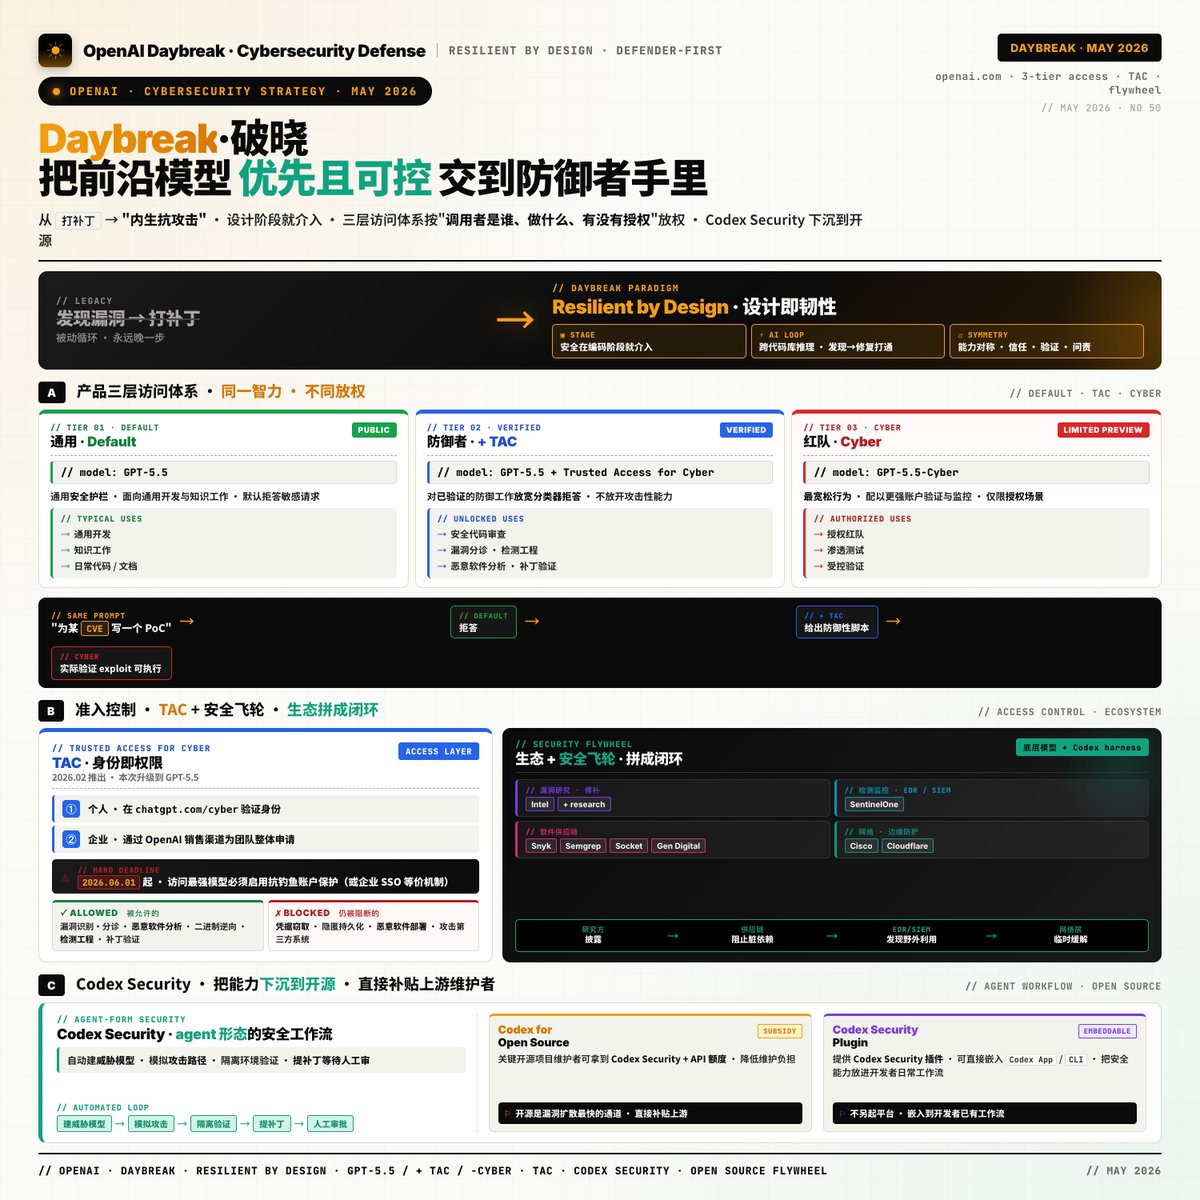
OpenAI 推出 Daybreak 战略,通过分层 AI 访问体系赋能防御者,实现软件从设计阶段就内生抗攻击。
入选理由:Daybreak 采用三层模型访问体系,区分权限等级:GPT-5.5、TAC 认证版、Cyber 专用版。
Stripe在年度大会发布288项新功能,旨在构建AI时代的经济基础设施,包括支持智能体的商务套件、Link钱包、Streaming Payments、强化风控及Treasury扩展等,助力企业适应AI变革。
入选理由:Stripe发布288项新产品与功能,聚焦于AI时代经济基础设施建设。
OpenAI发布了三款新语音模型:GPT-Realtime-2、GPT-Realtime-Translate和GPT-Realtime-Whisper,显著提升了对话、翻译和实时转录能力。
入选理由:GPT-Realtime-2在Big Bench Audio智能测试上从81.4%提升到96.6%,支持更复杂的任务编排。
跨维智能在World Arena Track 2登顶全球第一,显著领先第二名,验证其具身世界模型在数据生成、策略训练与任务落地的全链路硬实力。
入选理由:跨维智能DSCFuncWorld在World Arena Track 2以高任务成功率登顶,领先第二名约25%分差。
uber为控制开支,对每种AI编码工具实施每月1,500美元的配额,独立计算且仅适用于Cursor、Claude Code等;按每位工程师使用两种工具估算,年AI预算约36,000美元,约占美国uber软件工程师中位薪资330,000美元的11%。
入选理由:Uber对每种agentic coding工具设$1,500/月配额,独立于其他工具。
AssemblyAI 五月发布多项语音与 AI 工程升级:LLM 网关支持按 effort 级别启用链式推理并自动适配多模型;流式说话人识别准确率显著提升,误报与幻听分别下降66%与60%,支持每词说话人标签与连续部分转写;Playground 增加34种语音样本预览与可公开分享;PII 实时红脱并默认关闭部分转写以防泄露。
入选理由:LLM Gateway 可按 low/medium/high 开启链式推理,自动适配 Gemini、Claude、OpenAI 等模型差异。
NVIDIA 推出 5500 亿参数的 Neotron 3 Ultra,采用混合专家架构并专为代理任务训练,在代理基准上超越多款万亿参数模型,且公开数据与配方,便于企业本地部署与定制微调。
入选理由:Neotron 3 Ultra 为 550B 参数混合专家模型,活跃参数约 55B,专为代理任务训练。
Stripe France在AI成熟后果断转型,借鉴平台与付费订阅模式,将Monde选为首个OpenAI集成应用,实现显著转化提升:被GPT提及的流量是MTA文章的20倍、是Discover Google文章的50倍。
入选理由:采用平台化与订阅付费模型,快速积累近70万付费用户。
图像生成布局能力被 Reve 2 与 Ideogram 4 同步突破,后者登顶公开图像模型榜单;微软发布 MAI-Thinking-1,AIME 2025 97% 且无合成数据、无蒸馏,公开训练细节与 MoE 阶梯;开源侧 Gemma 4 12B 等多款模型升级,强化本地优先部署。
入选理由:Ideogram 4.0 登顶 Arena 开放图像模型榜单,图像布局能力显著提升。
Wasmer 通过 OpenAI Codex 在两周内构建 Edge.js,实现 Node.js 在 WebAssembly 沙箱中的边缘部署,无需 Docker;效率提升10–20倍,成为首个在边缘提供完整 Node.js 的云主机。
入选理由:开发 Edge.js 从一年缩短至两周,效率提升10–20倍。