T
traeai
Sign in

模型

什么是 PyTorch?

也叫:PyTorch model

主流深度学习框架

为什么现在值得关注?

最近变化

2026-10-21 · FlyDSL在MXFP4格式下实现1.68x几何均值加速,优于ATen基准

PyTorch 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。

📰 PyTorch 最新动态

已收录 30 篇与「PyTorch」相关的 AI 资讯和分析。

The next chapter in flood resilience: Open sourcing Google’s hydrology framework

The Next Chapter in Flood Resilience: Open-Sourcing Google’s Hydrology Framework

Google Research Blog1143 字 (约 5 分钟)
92

Google has open-sourced its AI hydrology framework powering Flood Hub, enabling agencies to train localized flood models using LSTM architecture and the Caravan dataset. The upgraded model extends reliable forecast horizons by six days in gauged basins, supports PyTorch-based fine-tuning, and empowers meteorological services to build high-accuracy early warning systems while retaining full data sovereignty.

入选理由:开源框架基于PyTorch和LSTM架构,提供完整训练管线与交互式教程Notebook。

FeaturedArticle#AI Hydrology#LSTM#Open Source Framework#Flood Forecasting#PyTorch英文
在AWS上进行基础模型训练与推理的核心构建模块

Building Blocks for Foundation Model Training and Inference on AWS

AI HOT 精选4633 字 (约 19 分钟)
92

AWS provides a comprehensive technical stack for large-scale foundation model training and inference, integrating high-performance compute, networking, storage, and open-source software to support NVIDIA's 'three scaling laws'.

入选理由:NVIDIA 的三大缩放定律包括预训练、后训练(如 SFT 和 RL)和推理时计算,需统一基础设施支持。

FeaturedArticle#AWS#Foundation Models#Distributed Training#PyTorch#Scalability英文
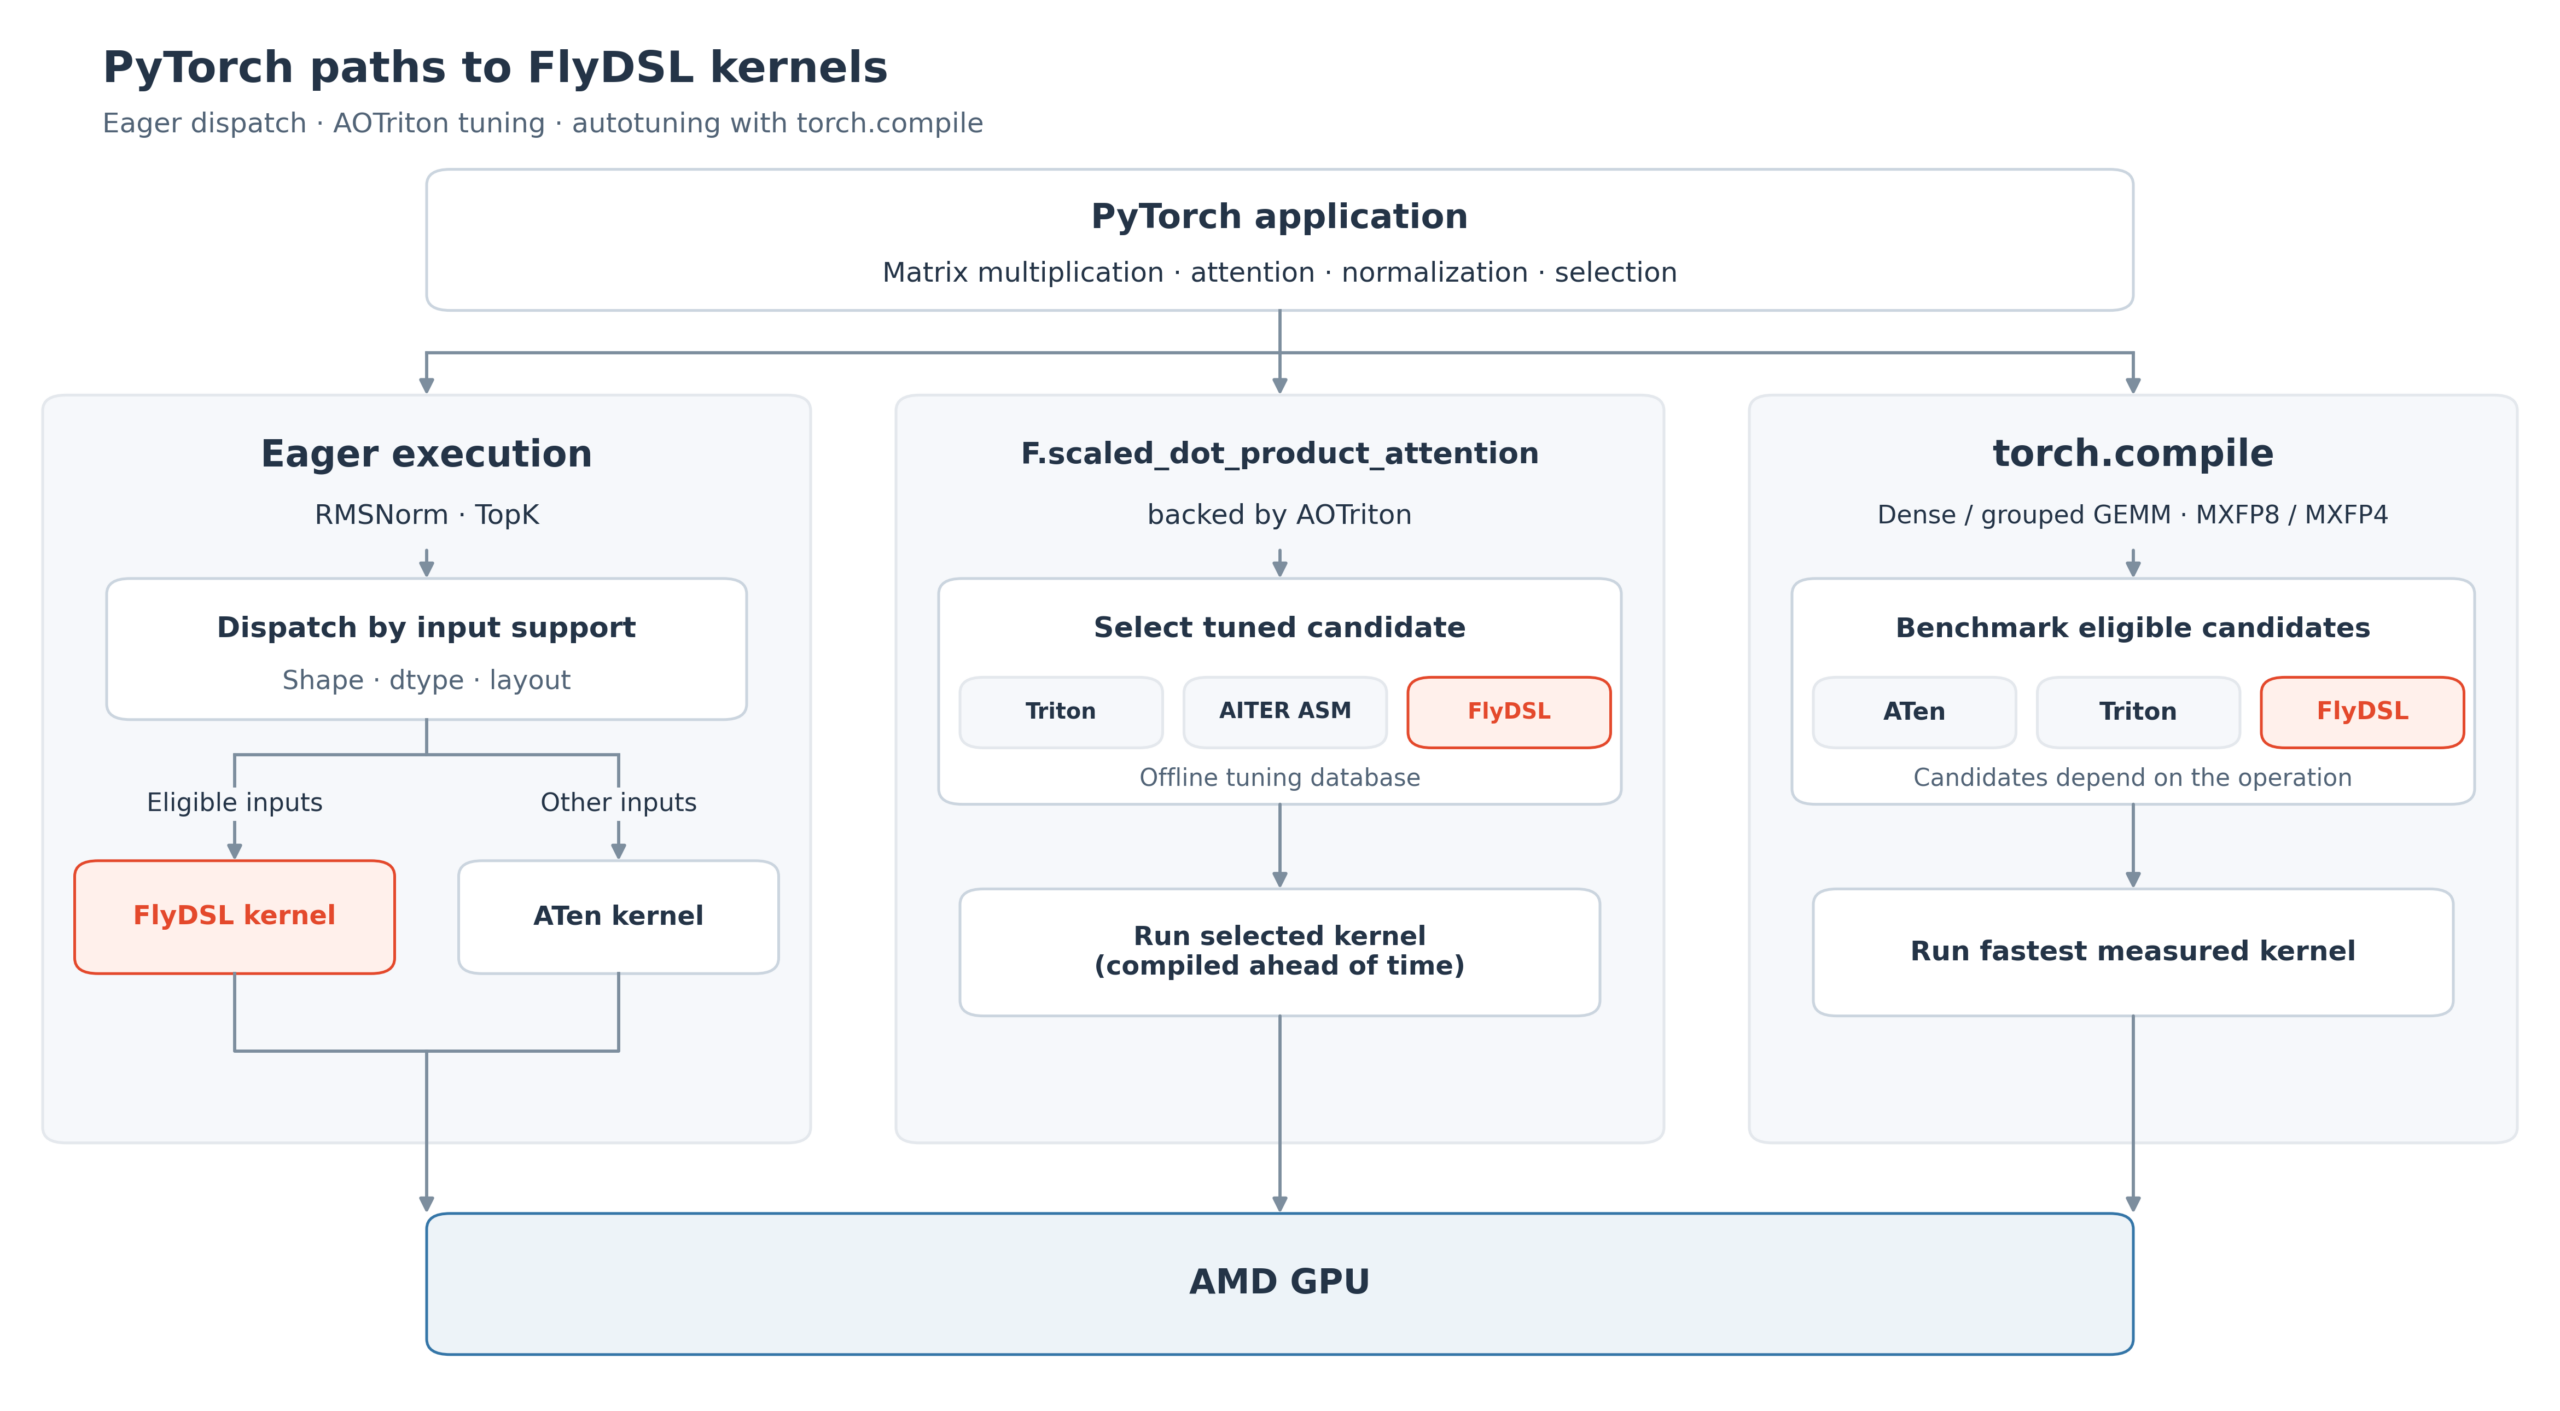
Accelerating PyTorch on AMD GPUs with FlyDSL

Accelerating PyTorch on AMD GPUs with FlyDSL

PyTorch Blog4733 字 (约 19 分钟)
85

FlyDSL通过显式硬件映射控制,使PyTorch在AMD GPU上实现最高3.66x加速,特别适用于大模型训练场景。

入选理由:FlyDSL在MXFP4格式下实现1.68x几何均值加速,优于ATen基准

FeaturedArticle#PyTorch#AMD GPU#FlyDSL#性能优化#深度学习框架英文
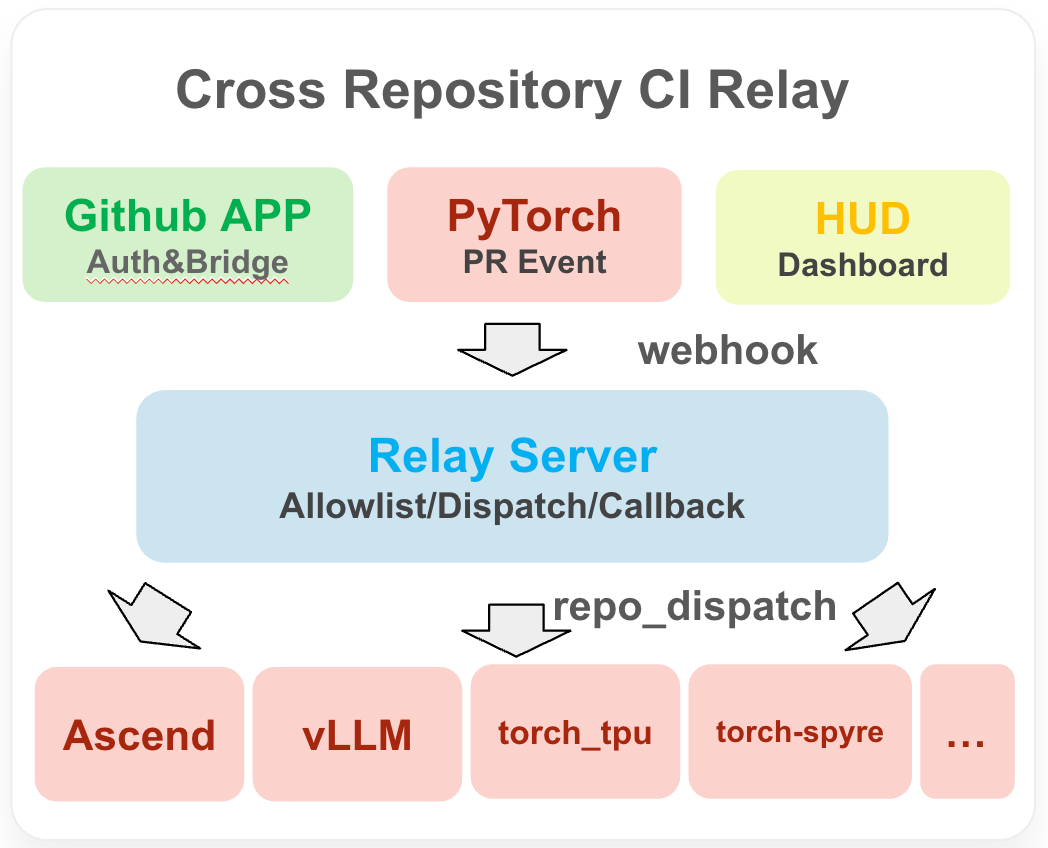
PyTorch Hardware Enablement: Updates from the Acceleration Integration Working Group

PyTorch加速器集成工作组在2026上半年推动跨平台硬件标准化,通过CRCR机制和测试套件重构提升集成效率。

入选理由:CRCR机制实现跨仓库CI自动化协调,减少集成延迟

FeaturedArticle#PyTorch#硬件集成#CI/CD#开源生态英文
PyTorch Blog 图标

A Ray-Focused Guide to PyTorch Conference North America

PyTorch Blog1573 字 (约 7 分钟)
85

Ray框架成为AI基础设施标准,与Kubernetes整合构建统一AI栈,LinkedIn展示三层PyTorch训练架构。

入选理由:Ray与Kubernetes协同进化是AI基础设施核心趋势

FeaturedArticle#PyTorch#Ray#Kubernetes#分布式计算#AI基础设施英文
Accelerate Your AI Journey with new Introduction Track at PyTorch Conference NA 2026 and PyTorch Associate Training

PyTorch 2026北美会议新增入门课程与认证培训,覆盖GPU编程、模型优化等核心技能,适合不同层次开发者系统提升实战能力。

入选理由:2026年10月19日加州圣何塞将举办PyTorch Associate认证培训(9am-5pm)

FeaturedArticle#PyTorch#机器学习#GPU编程#AI培训英文
TinyTorch: Don’t Just Import PyTorch. Build It.

TinyTorch: Don’t Just Import PyTorch. Build It.

PyTorch Blog2772 字 (约 12 分钟)
85

TinyTorch是PyTorch官方推出的开源教学框架,通过纯Python实现从张量到Transformer的完整构建,帮助学习者深入理解机器学习框架内部机制。

入选理由:TinyTorch可在4GB内存设备上运行,无需GPU

FeaturedArticle#PyTorch#教育#开源#机器学习框架英文
How Shopify built a continual learning loop with PyTorch and vLLM

How Shopify built a continual learning loop with PyTorch and vLLM

PyTorch Blog2165 字 (约 9 分钟)
85

Shopify通过PyTorch和vLLM构建持续学习循环,将生产失败转化为模型权重,提升质量并降低96%服务成本。

入选理由:使用PyTorch和vLLM构建持续学习循环可降低96%服务成本

FeaturedArticle#PyTorch#vLLM#持续学习#机器学习#Shopify英文
freeCodeCamp.org 图标

Hands-On Evolution of Deep Learning – Geoffrey Hinton’s AI Legacy

freeCodeCamp.org330 字 (约 2 分钟)
85

本文介绍一门27小时深度学习课程,系统复现Geoffrey Hinton的突破性研究,涵盖从Boltzmann机到AlexNet等核心算法的PyTorch实现。

入选理由:课程复现Hinton的15项深度学习突破,包括AlexNet和Dropout等关键算法

FeaturedArticle#深度学习#Geoffrey Hinton#PyTorch#AI课程英文
From Video to Voice: Build Faster with TensorRT Model Connect

From Video to Voice: Build Faster with TensorRT Model Connect

NVIDIA Developer6926 字 (约 28 分钟)
85

NVIDIA TensorRT Model Connect工具通过两步命令实现模型快速部署,结合TensorRT优化技术显著加速推理过程。

入选理由:使用TensorRT Model Connect可将PyTorch模型转换为部署包仅需两步命令

FeaturedVideo#TensorRT#模型部署#NVIDIA#AI工具英文
PyTorch 2.14 Release Blog

PyTorch 2.14 Release Blog

PyTorch Blog8497 字 (约 34 分钟)
85

PyTorch 2.14 引入 NVGEMM 性能优化、Apple Silicon 原生线性代数支持及分布式容错机制,显著提升大规模训练和推理效率。

入选理由:NVGEMM 技术使 CUTLASS 内核融合效率提升 30% 以上

FeaturedArticle#PyTorch#深度学习#AI框架#分布式计算#硬件支持英文
PyTorch x Hugging Face in Bengaluru: Building India’s Next Generation of ML Systems Contributors

印度正通过PyTorch与Hugging Face合作培养下一代AI系统构建者,聚焦分布式训练、推理优化等基础设施技术。

入选理由:PyTorch profiling工具链包含record_function和profile API,可分离等待/预热/采集阶段

FeaturedArticle#PyTorch#Hugging Face#AI基础设施#分布式训练#印度英文
Cambricon Joins the PyTorch Foundation as a Platinum Member

Cambricon Joins the PyTorch Foundation as a Platinum Member

PyTorch Blog967 字 (约 4 分钟)
85

Cambricon成为PyTorch基金会铂金会员,致力于推动AI芯片与PyTorch生态的深度整合。

入选理由:Cambricon在PyTorch中贡献了torch.compile、Eager Operators等核心模块。

FeaturedArticle#PyTorch#AI芯片#开源生态#Cambricon#深度学习英文
Red Hat AI 图标

How AI inference works, clearly explained

Red Hat AI2212 字 (约 9 分钟)
85

AI推理依赖模型权重、推理服务器和GPU协同工作,KV缓存优化可降低延迟和成本。

入选理由:推理服务器(如vLLM)是实现生产级GPU利用率的关键组件

FeaturedArticle#AI推理#LLM#KV缓存#优化#Red Hat英文
PyTorch Blog 图标

Core PyTorch Sessions at PyTorch Conference North America 2026

PyTorch Blog2375 字 (约 10 分钟)
85

PyTorch 2026年北美会议展示编译器优化、跨仓库CI Relay和AI代理在发布工程中的应用,加速器后端兼容性验证时间缩短至分钟级。

入选理由:Cross-Repo CI Relay使Ascend NPU/RISC-V后端兼容性检测从天级缩短至分钟级

FeaturedArticle#PyTorch#AI#发布工程#CI/CD#分布式计算英文
Machine Learning Mastery 图标

Using a Transformer Model: From Training to Inference

Machine Learning Mastery2974 字 (约 12 分钟)
85

Transformer模型推理需通过自回归生成和键值缓存优化性能,PyTorch实现细节揭示训练与推理的核心差异。

入选理由:自回归生成需逐个生成token,依赖前序所有输出

FeaturedArticle#Transformer#PyTorch#推理优化#机器学习英文
PyTorch Blog 图标

PyTorch 2.13 Release Blog

PyTorch Blog2425 字 (约 10 分钟)
85

PyTorch 2.13发布,引入FlexAttention加速、CuTeDSL后端、内存优化等,显著提升多平台性能与分布式训练效率。

入选理由:FlexAttention在Apple Silicon上实现最高12倍加速,提升稀疏模式性能。

FeaturedArticle#PyTorch#深度学习#性能优化#分布式训练英文
Towards Free Normalization: Fusing Normalization into GEMM and Attention Kernels

PyTorch通过融合归一化操作到GEMM和注意力内核,实现高达35%的性能提升,减少内存IO开销。

入选理由:Lazy Pre-Norm和Multi-CTA Norm Fusion技术可隐藏90%的归一化延迟

FeaturedArticle#PyTorch#深度学习优化#归一化#GEMM#注意力机制英文
Triton Plugin Extensions: Enabling TLX and Custom Compiler Passes Out of the Box

PyTorch 3.7引入Triton Plugin Extensions,支持动态加载自定义编译器传递,无需分叉Triton,性能匹配厂商库。

入选理由:Triton Plugin Extensions允许动态加载自定义编译器传递,无需分叉或重新编译。

FeaturedArticle#PyTorch#Triton#编译器优化#GPU内核英文
Driving the Future of Open Source AI: An Update from PyTorch Foundation Projects

PyTorch基金会宣布成立多项目基金会,PyTorch 2.13发布显著优化性能,vLLM推出Model Runner V2并公布2026路线图。

入选理由:PyTorch 2.13在Apple Silicon上实现FlexAttention性能提升至SDPA的12倍

FeaturedArticle#PyTorch#开源AI#模型优化#DeepSpeed#vLLM英文
Apple Launches Core AI for Apple-Silicon Optimized On-Device Generative AI

Apple 推出 Core AI 框架,支持在 Apple Silicon 上运行大型语言模型和生成式 AI,提升设备端 AI 性能。

入选理由:Core AI 支持从 3B 参数视觉模型到 70B 参数大语言模型的部署。

FeaturedArticle#Core AI#Apple#生成式 AI#框架英文
Google Developers Blog 图标

Unlocking the Power of the TPU Stack: Introducing our new Developer Hub

Google Developers Blog733 字 (约 3 分钟)
85

谷歌推出TPU开发者中心,提供TPU硬件、软件栈、优化策略等全面资源,助力开发者提升模型性能。

入选理由:TPU开发者中心涵盖从预训练到推理的全流程资源。

FeaturedArticle#TPU#AI#Google#开发工具英文
KDnuggets 图标

The Roadmap to Becoming an LLM Engineer in 2026

KDnuggets2350 字 (约 10 分钟)
85

成为2026年LLM工程师需掌握五大技能领域,包括基础、提示与工具调用、检索、微调与对齐、服务与运维。

入选理由:掌握LLM工程师需掌握的五大技能领域:基础、提示与工具调用、检索、微调与对齐、服务与运维。

FeaturedArticle#LLM#AI#机器学习#Python#Hugging Face英文
Best Python AI Frameworks in 2026

Best Python AI Frameworks in 2026

The JetBrains Blog2785 字 (约 12 分钟)
85

2026 年最佳 Python AI 框架包括 TensorFlow、PyTorch、scikit-learn 等,适用于不同 AI 项目需求。

入选理由:PyTorch 和 TensorFlow 适用于深度学习任务,如图像和文本处理。

FeaturedArticle#Python#AI#框架#深度学习#机器学习英文
Hugging Face Blog 图标

Profiling in PyTorch (Part 2): From nn.Linear to a Fused MLP

Hugging Face Blog3813 字 (约 16 分钟)
85

PyTorch 中 nn.Linear 的性能分析显示,其内部的矩阵转置操作显著影响计算效率,通过融合 MLP 可以减少开销。

入选理由:nn.Linear 的矩阵转置操作会增加计算开销。

FeaturedArticle#PyTorch#性能优化#深度学习#GPU英文

与「PyTorch」经常一起出现的 AI 术语。

💡 想追踪「PyTorch」的长期趋势?去 实体雷达 · PyTorch 查看详细分析和跨材料问答。

AI may generate inaccurate information. Please verify important content.