T
traeai
Sign in

概念

什么是 GRPO?

也叫:Gradient-based Policy Optimization

均匀分配token advantage的基线方法

为什么现在值得关注?

最近变化

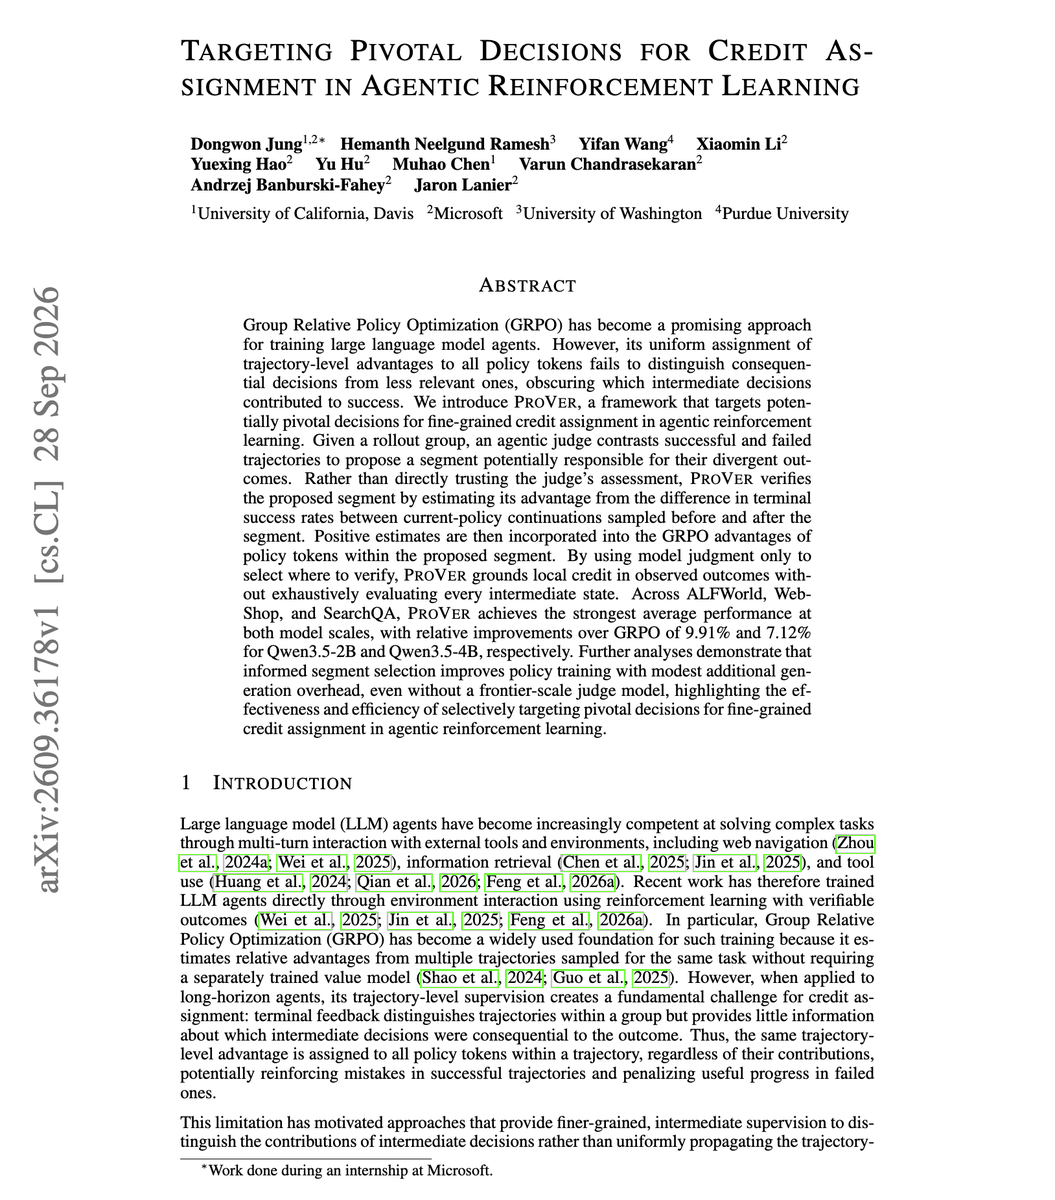
2026-10-02 · ProVer在Qwen3.5-2B上实现9.91%性能提升,4B模型提升7.12%

GRPO 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。

📰 GRPO 最新动态

已收录 12 篇与「GRPO」相关的 AI 资讯和分析。

从高拟真到真可用,LongCat-Video-Avatar 1.5 正式开源

From High Fidelity to Real Usability: LongCat-Video-Avatar 1.5 is Now Open-Sourced

美团技术团队2226 字 (约 9 分钟)
92

The open-sourced version of LongCat-Video-Avatar 1.5 significantly improves lip-sync accuracy, physical realism, and long-video stability for commercial-grade digital human video generation.

入选理由:采用 Whisper-large 编码器,提升唇形同步与动作稳定性。

FeaturedArticle#Digital Human#Video Generation#AI Model#Open Source Project#Meituan中文
https://t.co/nw0GoHamCI

DeepSeek's $10 Trillion Grand Strategy [Translation]

宝玉(@dotey)5655 字 (约 23 分钟)
92

DeepSeek builds a low-cost, high-efficiency model system through multiple foundational innovations to drive China's $10 trillion AI hardware ecosystem and achieve its own $1 trillion valuation.

入选理由:DeepSeek V4 Pro在100万上下文中仅需5.48GB HBM显存,远低于竞品的60-89GB。

FeaturedTweet#DeepSeek#AI Model#MoE#KV Cache Optimization#Hardware Ecosystem中文
Google Developers Blog 图标

Autonomous LLM post-training with Tunix on TPUs

Google Developers Blog854 字 (约 4 分钟)
85

Google利用Tunix和Cloud TPUs实现LLM微调的自主研究循环,显著提升效率。

入选理由:AI代理可自动优化LoRA参数和学习率调度,减少人工干预

FeaturedArticle#LLM微调#Tunix#Cloud TPU#自主研究循环英文
Hugging Face Blog 图标

Fine-tuning a 350M Model for Better Structured Outputs in 100 GRPO Steps

Hugging Face Blog2268 字 (约 10 分钟)
85

使用GRPO方法微调350M模型可在100步内提升IFStruct基准性能至29.7%。

入选理由:GRPO微调使350M模型在IFStruct基准上提升7.1个百分点(22.6%→29.7%)

FeaturedArticle#GRPO#微调#IFStruct#TRL库#Hugging Face英文
英伟达推出 AI 框架 Polar,让 Codex 跑分暴涨 594.74%

英伟达推出 AI 框架 Polar,让 Codex 跑分暴涨 594.74%

AI HOT 精选907 字 (约 4 分钟)
85

英伟达推出开源框架 Polar,显著提升 Codex 等智能体的性能和效率。

入选理由:Polar 框架让 Codex 在 SWE-Bench Verified 测试中的 pass@1 分数提升了 594.74%。

FeaturedArticle#英伟达#Polar#AI 框架#Codex#强化学习中文
SFT别急着接RL!你的多模态大模型可能一直在“带伤训练”

SFT may introduce distribution bias during the training of multimodal large models, leading to performance degradation in the RL phase. PRISM addresses this issue through a three-stage pipeline.

入选理由:SFT可能导致模型性能下降,如Qwen3-VL-8B SFT后准确率下降5.2%

FeaturedArticle#Multimodal#Large Model#PRISM中文

与「GRPO」经常一起出现的 AI 术语。

💡 想追踪「GRPO」的长期趋势?去 实体雷达 · GRPO 查看详细分析和跨材料问答。

AI may generate inaccurate information. Please verify important content.