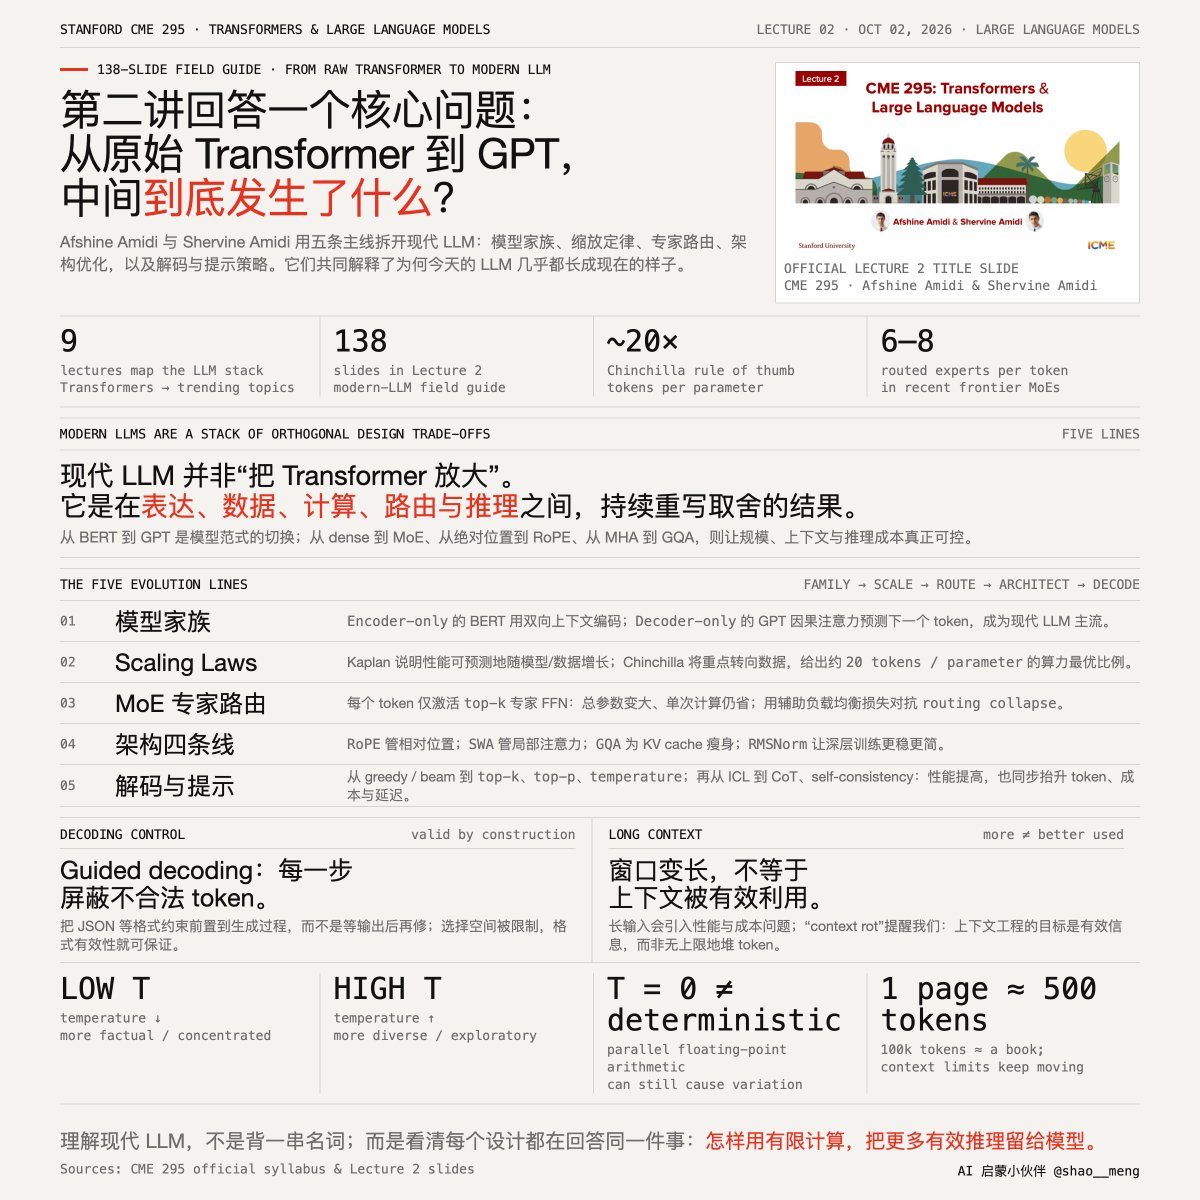
斯坦福大学 2026 秋季新课 CME 295: Transformers & Large Language Models 已开课(第二讲公开) @stanfordnlp 这门课程由双胞胎兄弟 @a...
斯坦福LLM课程系统解析Transformer演进与大模型优化技术,覆盖从架构到训练的完整知识体系。
入选理由:现代LLM几乎全部采用Decoder-only架构(如GPT、Qwen)
模型
也叫:FA
优化注意力计算的高效推理框架
最近变化
2026-10-05 · 现代LLM几乎全部采用Decoder-only架构(如GPT、Qwen)
Flash Attention 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
已收录 4 篇与「Flash Attention」相关的 AI 资讯和分析。
斯坦福LLM课程系统解析Transformer演进与大模型优化技术,覆盖从架构到训练的完整知识体系。
入选理由:现代LLM几乎全部采用Decoder-only架构(如GPT、Qwen)
Helion通过高级DSL和自动调优,使TPU内核开发更高效,性能达838 TFLOPs。
入选理由:Helion生成的TPU内核在flash attention任务中达到838 TFLOPs,接近79%的MFU。
SubQ 是首个基于完全次二次稀疏注意力架构的大型语言模型,其计算成本降低 1000 倍,上下文窗口达 1200 万 token。
入选理由:SubQ 的上下文窗口达到 1200 万 token,是 Opus 的 52 倍。
Y Combinator与Together AI合作建立GPU集群,为初创公司提供更便捷的计算资源,但技术细节和工程实践指导不足。
入选理由:YC与Together AI合作建立首个专用GPU集群,服务8000+客户
与「Flash Attention」经常一起出现的 AI 术语。
💡 想追踪「Flash Attention」的长期趋势?去 实体雷达 · Flash Attention 查看详细分析和跨材料问答。