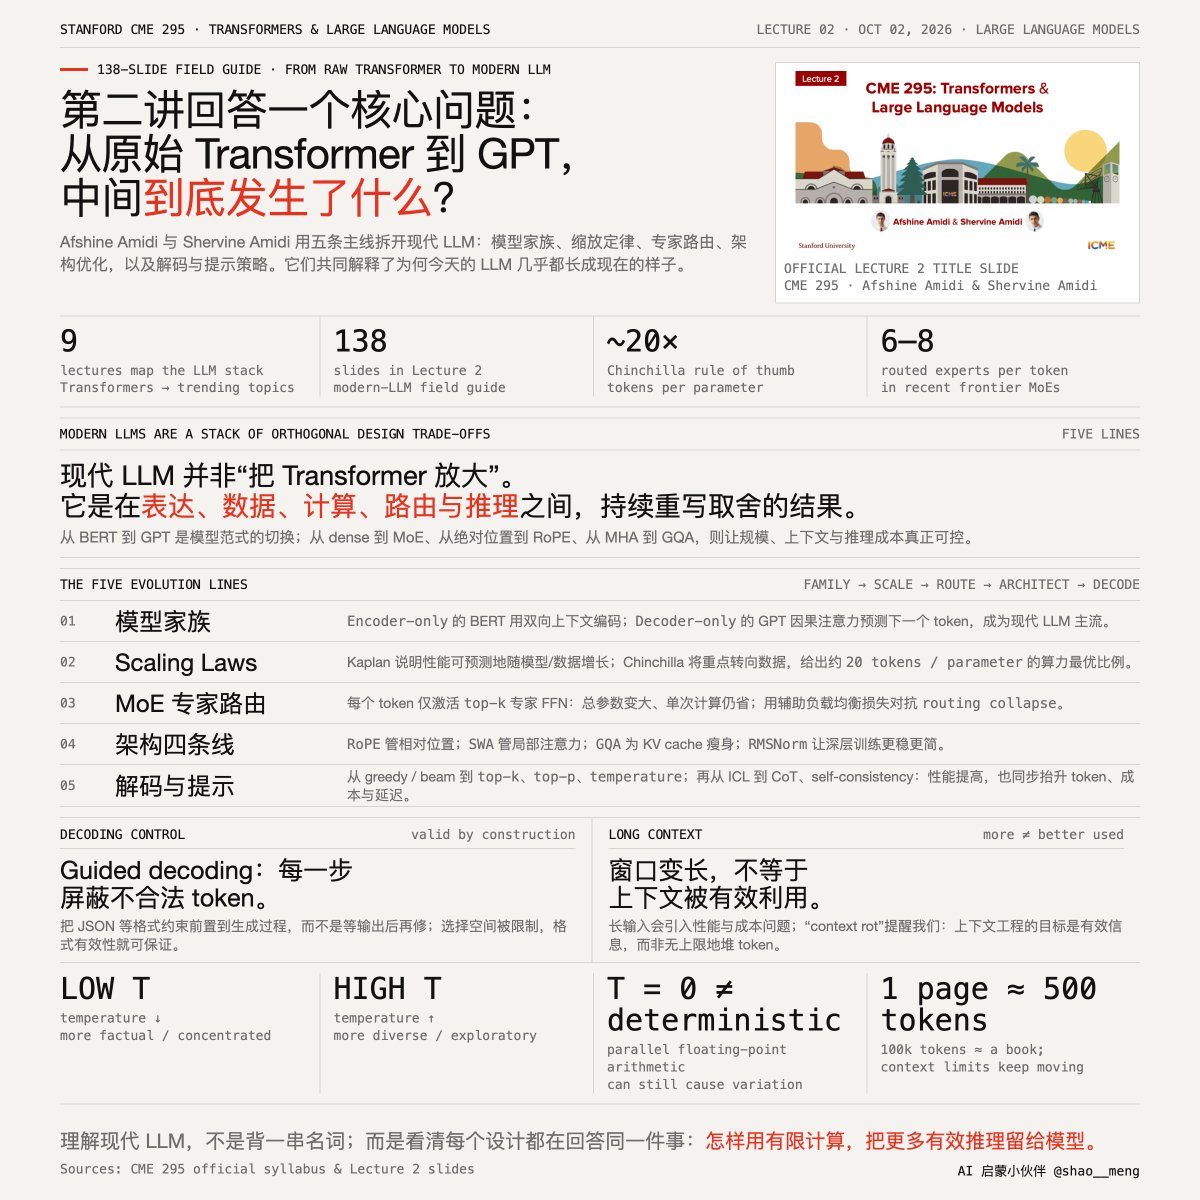
斯坦福大学 2026 秋季新课 CME 295: Transformers & Large Language Models 已开课(第二讲公开) @stanfordnlp 这门课程由双胞胎兄弟 @a...
斯坦福LLM课程系统解析Transformer演进与大模型优化技术,覆盖从架构到训练的完整知识体系。
入选理由:现代LLM几乎全部采用Decoder-only架构(如GPT、Qwen)
模型
别名:FA
优化注意力计算的高效推理框架
已跟踪 4 条高相关材料
最近变化
2026-10-05 · 现代LLM几乎全部采用Decoder-only架构(如GPT、Qwen)
为什么值得关注
Flash Attention 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
斯坦福大学 2026 秋季新课 CME 295: Transformers & Large Language Models 已开课(第二讲公开) @stanfordnlp 这门课程由双胞胎兄弟 @a...
meng shao(@shao__meng) · 8.5 分
斯坦福LLM课程系统解析Transformer演进与大模型优化技术,覆盖从架构到训练的完整知识体系。
Helion on TPU: Towards Hardware Heterogeneous Kernel Authoring
PyTorch Blog · 8.5 分
Helion通过高级DSL和自动调优,使TPU内核开发更高效,性能达838 TFLOPs。
The First Real LLM Breakthrough Is Here... SubQ (1000x Less Compute)
TheAIGRID · 8.5 分
SubQ 是首个基于完全次二次稀疏注意力架构的大型语言模型,其计算成本降低 1000 倍,上下文窗口达 1200 万 token。
已收录 4 条与 Flash Attention 相关的内容,按评分排序。
斯坦福LLM课程系统解析Transformer演进与大模型优化技术,覆盖从架构到训练的完整知识体系。
入选理由:现代LLM几乎全部采用Decoder-only架构(如GPT、Qwen)
Helion通过高级DSL和自动调优,使TPU内核开发更高效,性能达838 TFLOPs。
入选理由:Helion生成的TPU内核在flash attention任务中达到838 TFLOPs,接近79%的MFU。
SubQ 是首个基于完全次二次稀疏注意力架构的大型语言模型,其计算成本降低 1000 倍,上下文窗口达 1200 万 token。
入选理由:SubQ 的上下文窗口达到 1200 万 token,是 Opus 的 52 倍。
Y Combinator与Together AI合作建立GPU集群,为初创公司提供更便捷的计算资源,但技术细节和工程实践指导不足。
入选理由:YC与Together AI合作建立首个专用GPU集群,服务8000+客户