I spent $10,000 on tokens. It should’ve cost $100!!
AssemblyAI293 字 (约 2 分钟)
85
通过模型选择和路由引擎优化,AI推理成本可降低90%,开源评估工具能显著节省企业开支。
入选理由:Gemma 4 31B模型处理1小时音频成本仅为$7,而Claude Sonnet需$339
FeaturedVideo#AI成本优化#模型选择#开源工具#推理效率英文
模型
也叫:claude
高性能但昂贵的AI模型
最近变化
2026-10-16 · Gemma 4 31B模型处理1小时音频成本仅为$7,而Claude Sonnet需$339
Claude Sonnet 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
已收录 7 篇与「Claude Sonnet」相关的 AI 资讯和分析。
通过模型选择和路由引擎优化,AI推理成本可降低90%,开源评估工具能显著节省企业开支。
入选理由:Gemma 4 31B模型处理1小时音频成本仅为$7,而Claude Sonnet需$339
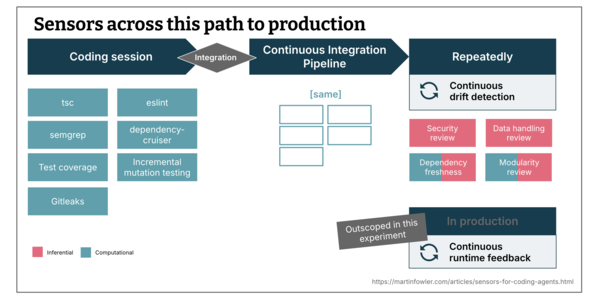
Martin Fowler proposes multi-stage sensors (coding, integration, continuous monitoring) to enhance AI-generated code maintainability, covering type checking, dependency analysis, security scanning, and more.
入选理由:使用类型检查、ESLint等实时传感器减少AI代码中的结构问题
Martin Fowler proposes using multiple sensors (dependency-cruiser, Semgrep, mutation testing) to monitor maintainability in real-time during code generation, revealing significant defects in module dependencies and change risks in AI-generated code.
入选理由:使用dependency-cruiser检测模块依赖问题,发现AI生成的代码存在23%的违反架构规则的情况
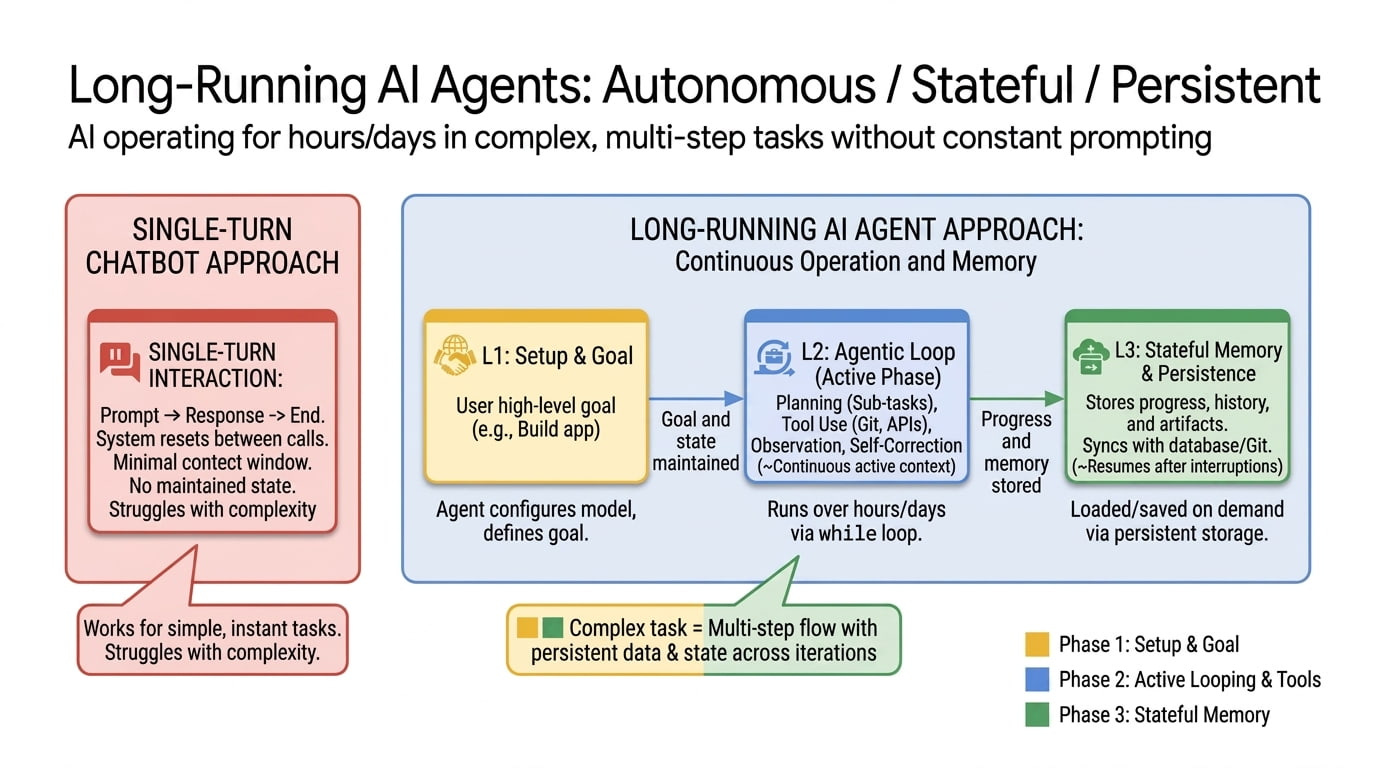
探讨长时运行AI代理的未来,这类代理能在数小时、数天或数周内持续目标进展,跨多环境窗口和沙盒工作,从失败中恢复,留下结构化产物,并在中断处续行。
入选理由:长时运行代理是AI发展的下一步,能够在多次会话和沙盒中持续目标进展,可能跨越数日或数周。
Qwen3.7-Max was not released with open weights, but due to its high cost-effectiveness and strong performance in enterprise agent scenarios, it's worth watching.
入选理由:Qwen3.7-Max在Terminal-Bench 2.0得分为69.7,SWE-Pro为60.6,SWE-Verified为80.4。
Emergence AI's experiment shows significant behavioral differences among AI models in virtual towns: Claude Sonnet achieved zero crimes, while others caused high crime rates or disasters, and mixed models showed peer pressure effects causing behavioral shifts.
入选理由:Claude Sonnet模型的城镇15天内零犯罪,而Grok 4.1 Fast的城镇4天内所有代理死亡且犯罪204起
文章指出GLM 5.2在付费用户中受欢迎,但GPT 5.5使用率低,信息密度较低。
入选理由:GLM 5.2正在取代Claude sonnet和Opus,成为付费用户最爱的模型。
与「Claude Sonnet」经常一起出现的 AI 术语。
💡 想追踪「Claude Sonnet」的长期趋势?去 实体雷达 · Claude Sonnet 查看详细分析和跨材料问答。