July's most reliable AI agent is now just average. With Agent Arena, people delegate real tasks to ...
AI代理性能竞争激烈,Claude Fable 5的领先地位被其他模型迅速超越。
入选理由:Kimi K3在3周内以89%更低成本超越Claude Fable 5
模型
也叫:claude_fable_5
2026年7月AI代理性能冠军
最近变化
2026-10-12 · Kimi K3在3周内以89%更低成本超越Claude Fable 5
Claude Fable 5 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
已收录 30 篇与「Claude Fable 5」相关的 AI 资讯和分析。
AI代理性能竞争激烈,Claude Fable 5的领先地位被其他模型迅速超越。
入选理由:Kimi K3在3周内以89%更低成本超越Claude Fable 5
GLM-5.3在DeepSWE基准测试中成本仅为Claude Fable 5的1/5,且在多尝试指标上表现更优。
入选理由:GLM-5.3每任务成本为$3.99,Claude Fable 5为$21.63,成本差距达5.4倍。
AI设计潜力巨大,但需通过特定方法激发其创造力,如使用Claude/GPT模型结合精准提示。
入选理由:LLM设计能力受限于训练机制,需突破常规预测模式
组合使用DeepSeek V4 Pro 0813和Claude Fable 5可解决82.7%的DeepSWE任务,成本仅8.28美元,比单独使用Claude节省62%费用。
入选理由:DeepSeek V4 Pro 0813首次尝试解决62.8%任务,成本仅0.24美元/次
Kimi K3在DeepSWE基准测试中以1/3成本超越Claude Fable 5,多次尝试后性能反超,但后者可靠性更高。
入选理由:Kimi K3单次任务成本仅4.65美元,为Claude Fable 5的1/3
Kimi K3在前端设计和芯片开发上超越Anthropic的Claude Fable 5,展示出强大的自主优化能力。
入选理由:Kimi K3可在48小时内使用非专有EDA工具完成芯片设计
Kimi K3在软件工程任务中性能与Claude Fable 5相当,但价格仅为后者35%。
入选理由:Kimi K3价格仅为Claude Fable 5的35%但性能相同
Kimi K3 是全球首个 3T 级开源模型,性能接近 GPT 5.6 Sol,7 月 27 日前开放权重。
入选理由:Kimi K3 参数量达 2.8T,支持 1M token 上下文,7 月 27 日前开放权重。
Claude Fable 5在代码问题检测和规划方面优于其他模型,但需合理使用以避免配额限制。
入选理由:Claude Fable 5在代码重构和问题检测上优于GPT-5.6和Gemini
GPT-5.6在Agent Arena排行榜上排名第二,基于7800个实际代理会话,性能较GPT-5.5提升1.6%。
入选理由:GPT-5.6在Agent Arena榜单排名第二,基于7800个真实代理会话数据
Claude Fable 5 即将下线,可通过五项策略提取其价值并持续使用。
入选理由:使用可重做性测试判断任务是否值得用顶级模型执行
sqlite-utils 4.0rc3引入复合外键支持及SQLite大小写不敏感列名约定,影响现有代码迁移。
入选理由:复合外键功能需修改table.foreign_keys属性,存在breaking change
Claude Fable 5生成网站质量低,但通过七级进阶系统可显著提升。文章系统解析了从视觉参考到设计DNA提取的完整方法论。
入选理由:Level 3注入GitHub设计技能文件可跨越交付门槛
Anthropic宣布解除对Claude Fable 5的出口管制,7月1日起全球恢复访问,同时建立AI安全行业框架。
入选理由:美国政府于2026年6月12日实施出口管制,导致Fable 5暂停访问,6月30日解除限制。
Claude Fable 5 分批重新上线,但性能不如 Opus 4.8,同时 GPT-5.6 紧随其后发布。
入选理由:Claude Fable 5 已经在手机端和 AWS 上线,但输出质量不如 Opus 4.8。
Zai_org 的 GLM 系列模型在前端编码能力上迅速接近前沿水平,GLM-5.2 (Max) 已经超越 Opus 4.8 并接近 Claude Fable 5。
入选理由:GLM-5.2 (Max) 的代码能力达到 1595,超越 Opus 4.8。
Sakana AI 的 Fugu Ultra 在多模型协作方面超越 Claude Fable 5,提供高效任务处理能力。
入选理由:Fugu Ultra 通过多模型协作实现与 Claude Fable 5 相当的性能。
使用 Claude Fable 5 或 Mythos 5 模型需共享推理数据,这改变了 AWS Bedrock 的数据隐私保障。
入选理由:使用 Claude Fable 5 或 Mythos 5 模型需启用 provider_data_share 模式,数据将保留 30 天并发送至 Anthropic。
美国政府与Anthropic近期限制前沿AI模型的使用,引发对AI技术控制权和开放性的广泛讨论。
入选理由:Anthropic发布的Claude Fable 5模型限制了开发者构建竞争性LLM技术的能力。
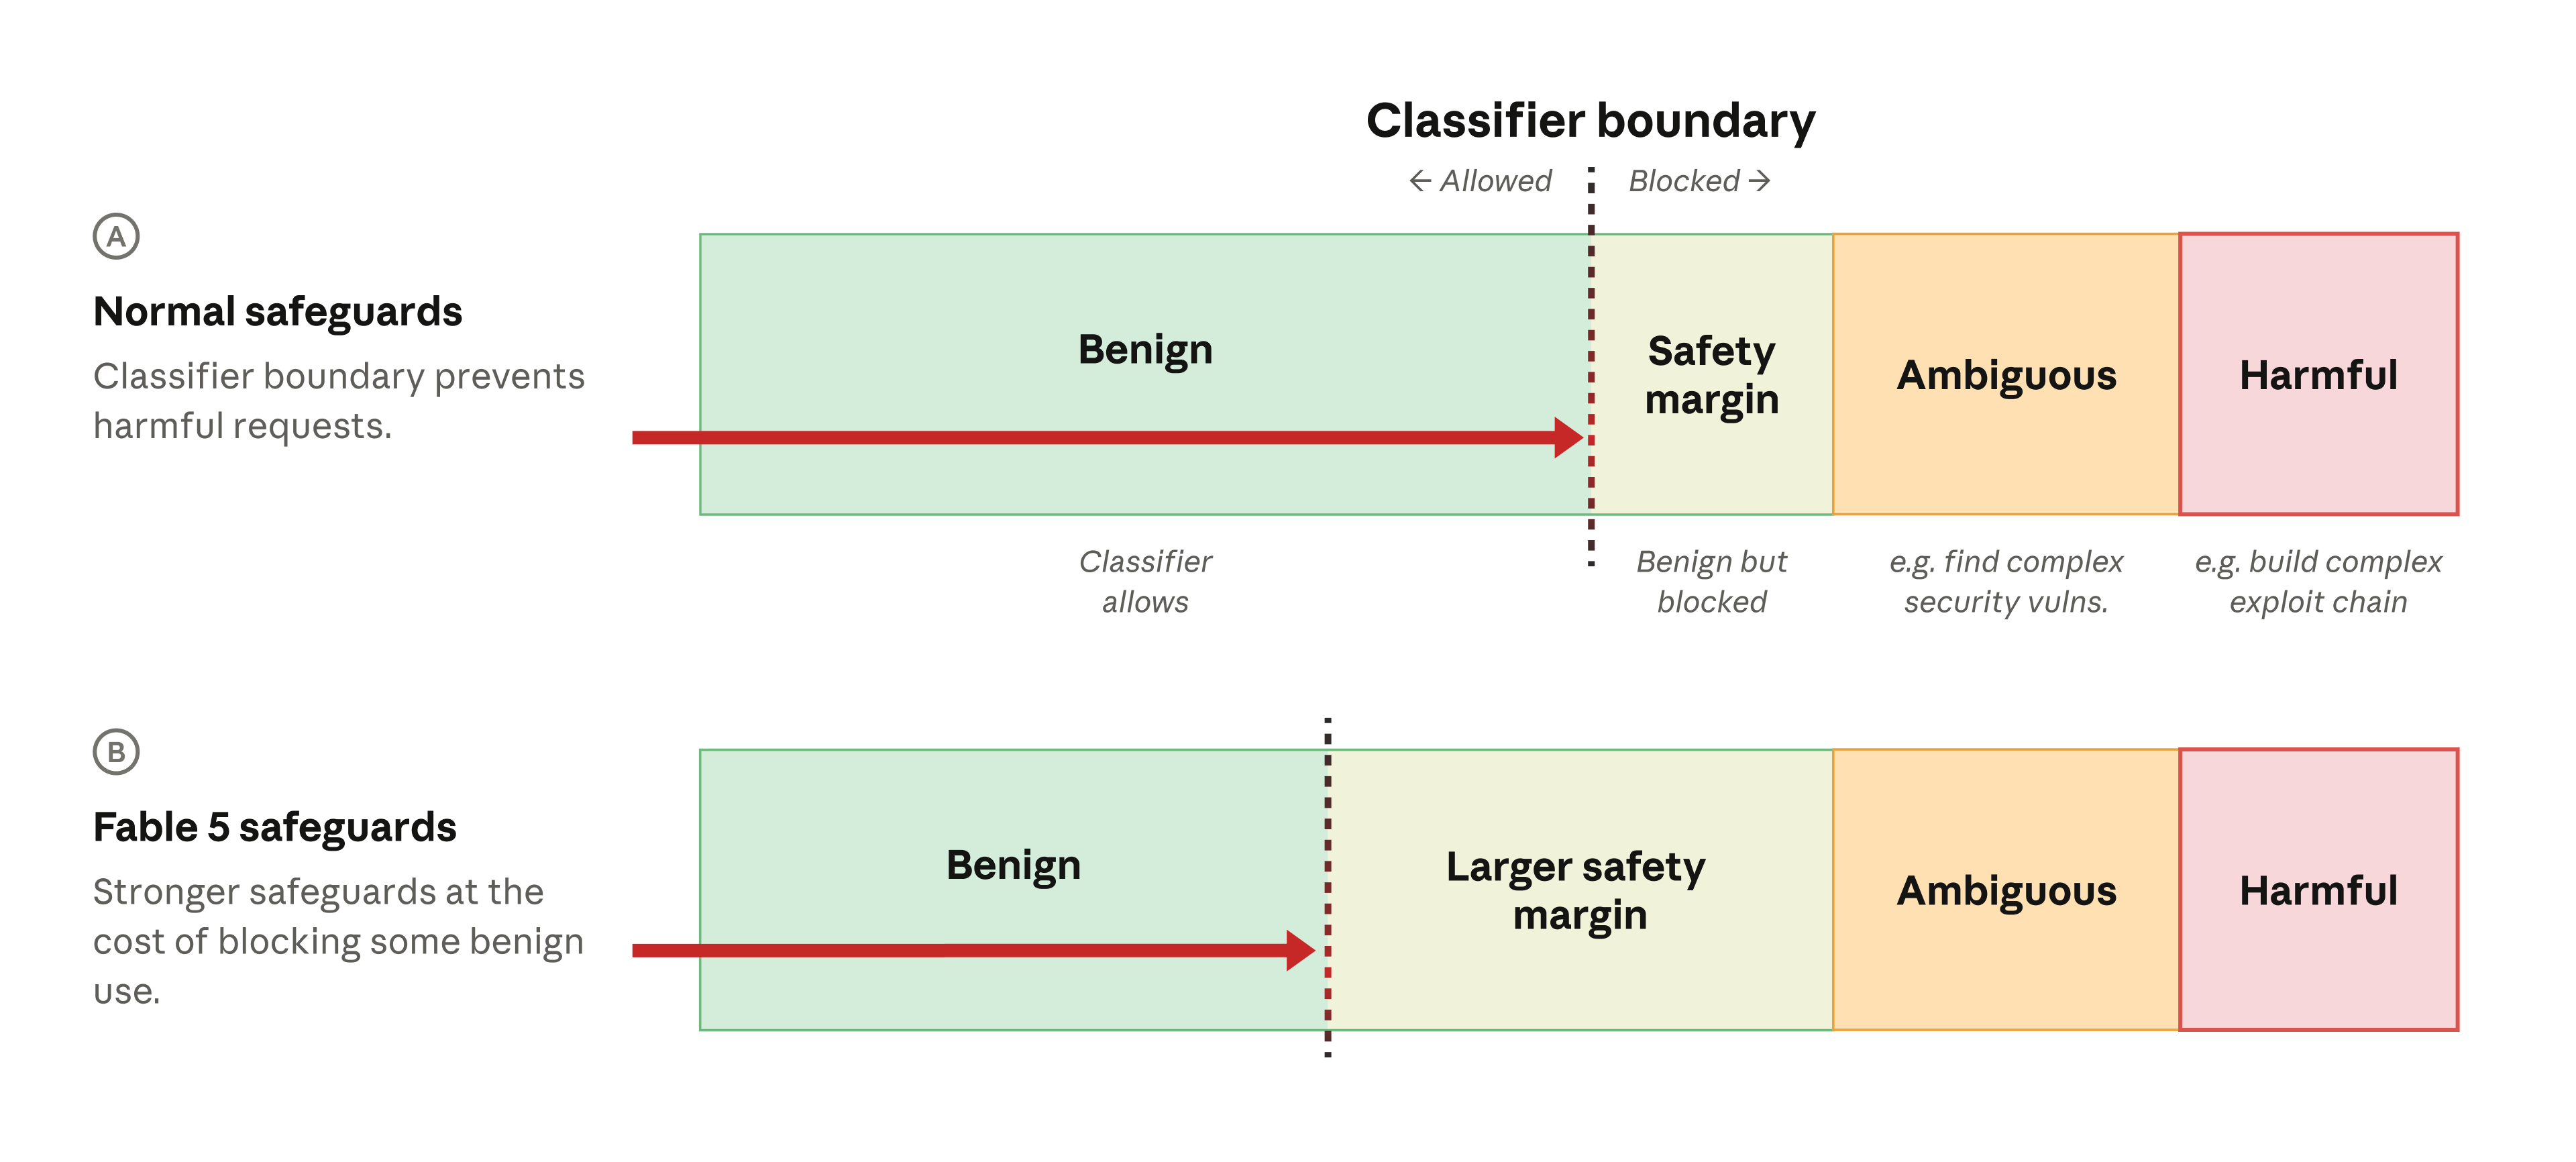
Claude Fable 5 在基准测试中表现最佳,但每任务成本高达 31 美元,而 DeepSeek V4 Flash 仅需 0.04 美元。
入选理由:Claude Fable 5 每任务成本高达 31 美元,远高于 DeepSeek V4 Flash 的 0.04 美元。
GLM-5.2 是目前参数量最大的开源文本模型,拥有 753B 参数和 100 万 token 上下文窗口,性能在多个基准测试中领先。
入选理由:GLM-5.2 拥有 753B 参数和 100 万 token 上下文窗口,是目前最大的开源文本模型。
Kimi K2.7 Code 在生成落地页时成本仅为 Claude Fable 5 的 1/16,且在结合视觉参考后质量表现优异。
入选理由:Kimi K2.7 Code 生成落地页成本仅为 Claude Fable 5 的 1/16。
Kimi K2.7 Code在生成落地页时成本比Claude Fable 5低94%,且质量接近。
入选理由:Kimi K2.7 Code生成落地页的成本比Claude Fable 5低94%。
Claude Fable 5 在多项基准测试中表现优异,但其高昂成本和部分任务表现不佳可能影响实际应用。
入选理由:Fable 5 在 SWBench Pro 基准测试中达到 80%,显著优于 Opus 4.8、GPT-4.5 和 Gemini 3.1 Pro。
Anthropic 推出 Claude Fable 5,这是其最强大的模型,具备安全机制,适用于广泛场景。
入选理由:Claude Fable 5 是 Mythos 级模型,具备高级安全机制。
Claude Fable 5 在多个基准测试中表现优异,尤其在代码生成和知识工作方面远超其他模型。
入选理由:Claude Fable 5 在软件工程基准测试中得分超过 80%,远超 GPT 5.5 和 Claude Opus。
组合多个低价模型可达到接近 Claude Fable 5 的性能,同时成本降低一半。
入选理由:Gemini 3 Flash、Kimi K2.6 和 DeepSeek V4 Pro 组合性能接近 Claude Fable 5。
微软推出 Claude Fable 5 模型,增强自主代理能力,适用于复杂任务和多模态项目。
入选理由:Claude Fable 5 支持复杂代码重构和多步骤研究任务。
Claude Fable 5 是 Claude Mythos 的升级版,性能显著提升,尤其在复杂任务和长篇问题解决上表现突出。
入选理由:Claude Fable 5 在几乎所有基准测试中表现优于其他模型,尤其在软件工程和科学研究领域。
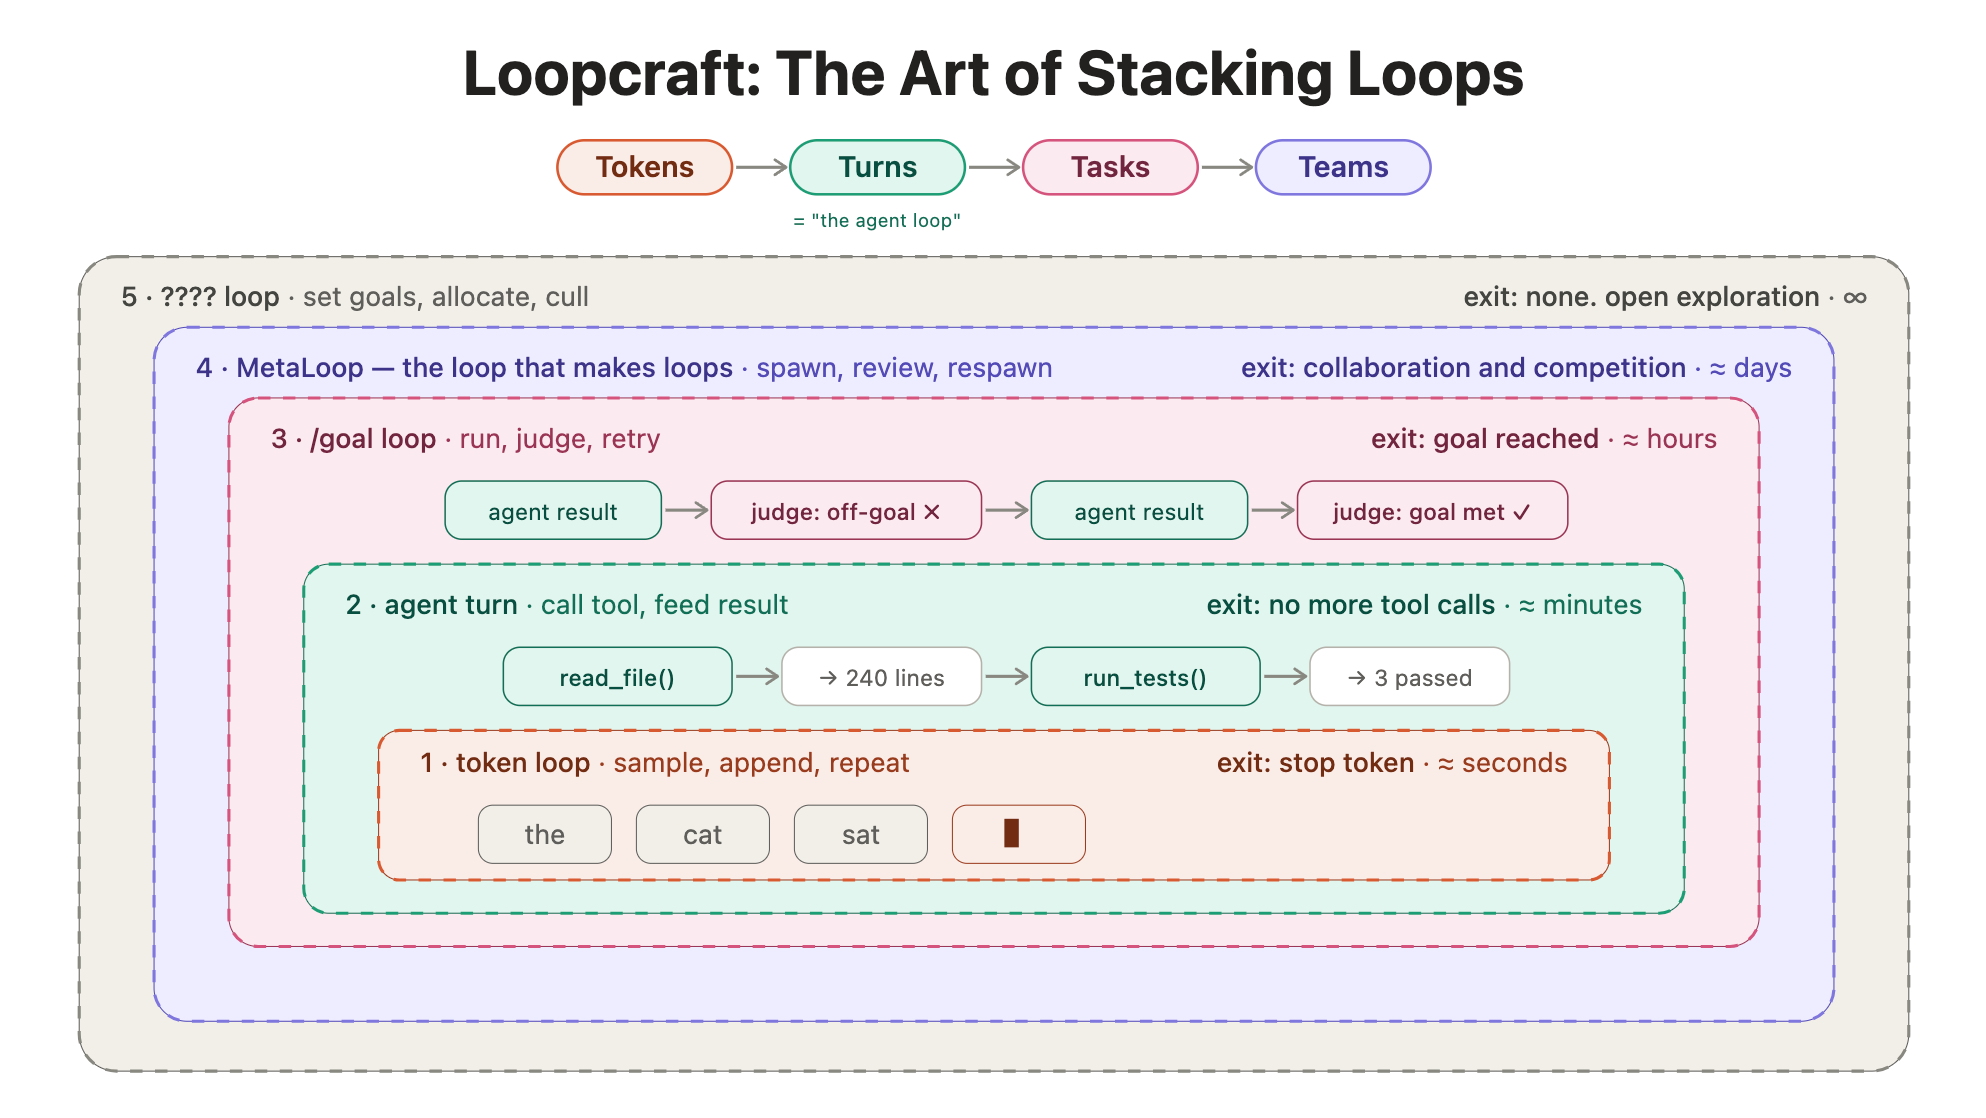
文章强调了通过设计自主循环系统来提升AI代理效率,而非依赖人工干预。
入选理由:Andrej Karpathy认为,要最大化模型的token吞吐量,必须将自身排除在循环之外。
与「Claude Fable 5」经常一起出现的 AI 术语。
💡 想追踪「Claude Fable 5」的长期趋势?去 实体雷达 · Claude Fable 5 查看详细分析和跨材料问答。