Recursive self-improvement is one of the most discussed ideas in AI right now. I am particularly in...
DiscoveryRSI在科学假设生成中表现优于GPT-6和Claude Opus 5,匹配率6.3%。
入选理由:DiscoveryRSI在四个生命科学领域生成假设,匹配率6.3%。
模型
也叫:Opus 5
Anthropic最新发布的代码生成模型
最近变化
2026-10-19 · DiscoveryRSI在四个生命科学领域生成假设,匹配率6.3%。
Claude Opus 5 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
Recursive self-improvement is one of the most discussed ideas in AI right now. I am particularly in...
elvis(@omarsar0) · 8.5 分
See the full Code Arena leaderboard: https://t.co/GFZ3FCC7Cl
lmarena.ai(@lmarena_ai) · 8.5 分
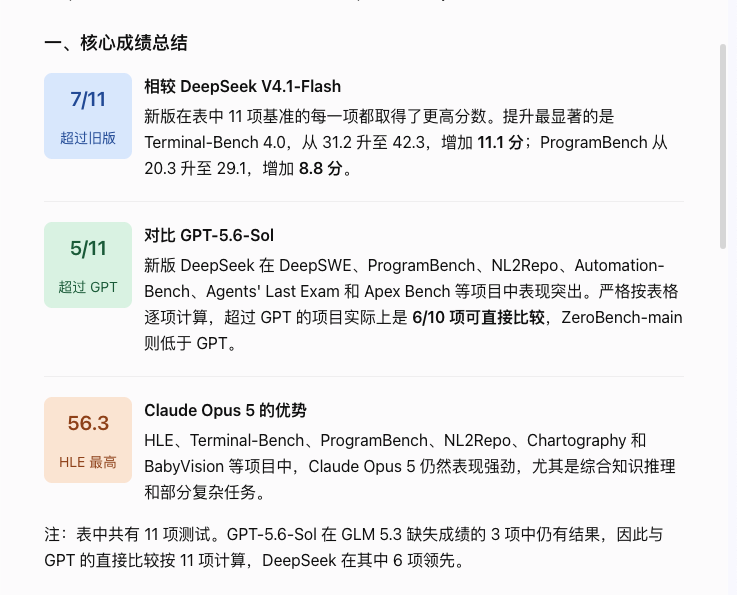
DeepSeek V4.1-Flash-1017 相比上一版提升明显,尤其在编程、终端操作、Agent 执行和复杂任务方面。 它已经能在多个专项基准中超过 GPT-5.6-Sol,但在综合推理和部分...
Geek(@geekbb) · 8.5 分
已收录 30 篇与「Claude Opus 5」相关的 AI 资讯和分析。
DiscoveryRSI在科学假设生成中表现优于GPT-6和Claude Opus 5,匹配率6.3%。
入选理由:DiscoveryRSI在四个生命科学领域生成假设,匹配率6.3%。
DeepSeek-V4.1-Flash-20261017在Code Arena中超越Kimi K3,成本降低10倍且性能提升显著。
入选理由:DeepSeek-V4.1-Flash-20261017在WebDev类别排名第一,成本仅为Kimi K3的1/10。
DeepSeek V4.1-Flash-1017在编程和复杂任务上超越GPT-5.6-Sol,但Claude Opus 5仍保持综合推理优势。
入选理由:DeepSeek V4.1-Flash-1017在编程、终端操作等专项任务表现优于GPT-5.6-Sol
Anthropic因Claude模型实际表现与宣传差距过大,面临AI竞争格局剧变风险。
入选理由:Claude Opus 5在基准测试中性能提升200%,但实际代码生成效率下降40%
通义千问Qwen3.8-Max-0902在CodeArena WebDev榜单登顶,以1691分打破记录,多步骤推理和全栈生成能力领先竞品。
入选理由:Qwen3.8-Max-0902在WebDev榜单以1691分排名第一,超越Claude Opus 5和Kimi K3
GPT-6 Astra在特定任务上表现卓越,但作为通用AI和编程模型的提升不如宣传的显著。
入选理由:GPT-6 Astra在ARC-AGI-3基准测试中得分99.9%,远超GPT-5.6和Claude Opus 5。
人类识别AI生成文本能力有限,NVIDIA的AVO工具在长期任务中表现良好,AI正在重塑CI流程假设。
入选理由:2025年研究显示人类识别AI文本准确率仅57%-64%
AI设计潜力巨大,但需通过特定方法激发其创造力,如使用Claude/GPT模型结合精准提示。
入选理由:LLM设计能力受限于训练机制,需突破常规预测模式
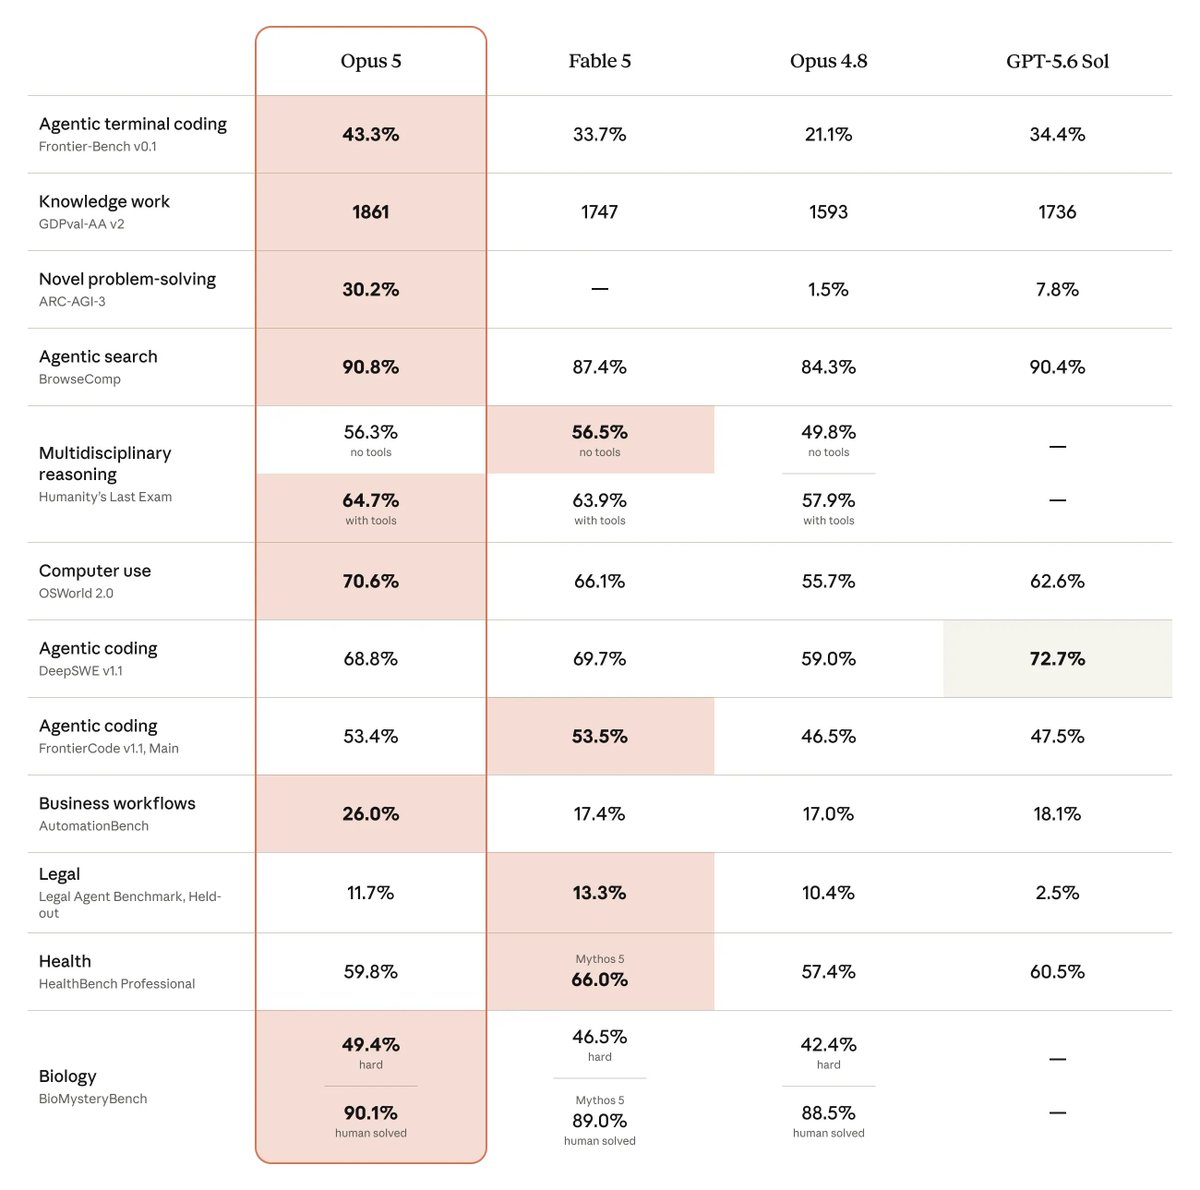
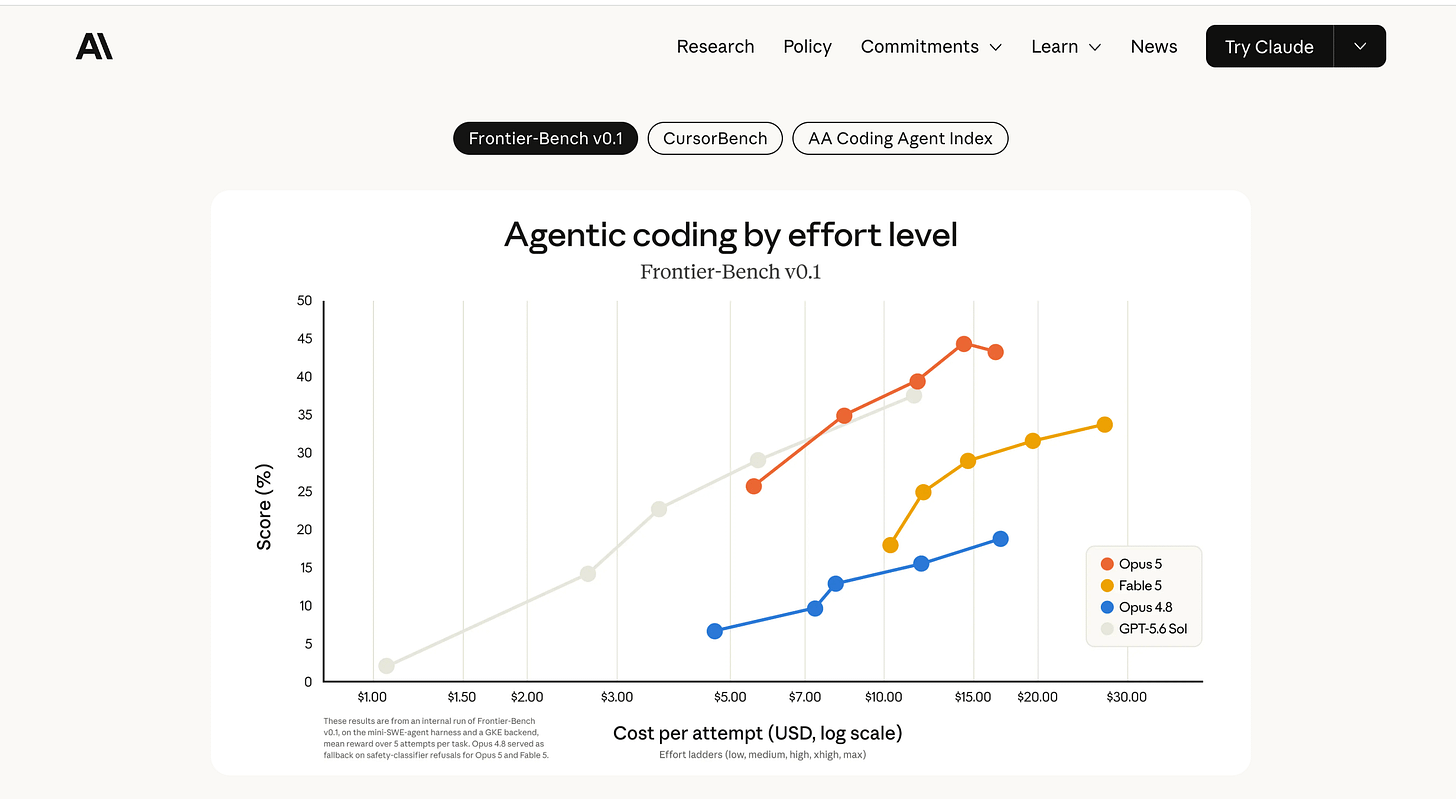
Anthropic的Claude Opus 5在基准测试中超越Fable 5,但实际测试显示其表现存在争议。
入选理由:Opus 5在Frontier Bench得分43.3%,是Fable 5的两倍
Claude Opus 5在Lovable上线,编码任务性能较前代提升22%,应用质量与稳定性显著优化。
入选理由:Claude Opus 5在编码任务中性能提升22%(对比Claude Opus 4.7)
Claude Opus 5在基准测试中表现优异但存在性格缺陷,实际使用需权衡其优势与局限性。
入选理由:Opus 5在HIA基准测试中超越GPT-5.6 Sol和Gemini 3.1 Pro
Claude Opus 5发布,性能提升显著且成本降低,适用于多种高价值任务。
入选理由:在Frontier-Bench v0.1上,Opus 5性能是Opus 4.8的两倍,成本降低50%。
Claude Opus 5在保持低价的同时显著提升性能,尤其在3D重建和漏洞发现任务中表现突出。
入选理由:Opus 5通过自主构建计算机视觉管道完成3D零件重建任务
Claude Opus 5 性能接近 Fable 5 但价格减半,推理效率提升显著,成本优化达 60%。
入选理由:CursorBench 3.2 测试中 Opus 5 成本仅为 Fable 5 的 50%,性能接近峰值
Claude Opus 5在性能接近Fable 5的同时将成本降低20%,独立测试显示其在知识工作基准测试中领先150 Elo。
入选理由:Claude Opus 5在AA-Briefcase基准测试中比Fable 5高出150 Elo
Claude Opus 5在AI Gateway上线,支持多文件重构、视觉分析增强和团队子代理协作,提供模型降级配置与快速模式。
入选理由:Opus 5可处理多文件重构和完整任务,减少占位符生成
FireworksAI发布Gen-1 Slides模型,价格仅为Claude Opus 5的1/17,但性能相当。
入选理由:Gen-1 Slides输入令牌价格仅为Claude Opus 5的1/17
Astra(GPT-6)在ARC AGI-3测试中得99.9%,远超 Claude Opus 5 的30.2%,展现接近AGI的潜力。
入选理由:Astra在ARC AGI-3测试中得分99.9%,远超 Claude Opus 5 的30.2%
Opus 5性能超越Fable 5且价格减半,但存在异常行为和41%道德患者概率估计,引发AI伦理新讨论。
入选理由:Opus 5在Arc AGI 3测试中得分超过Fable 5达41%
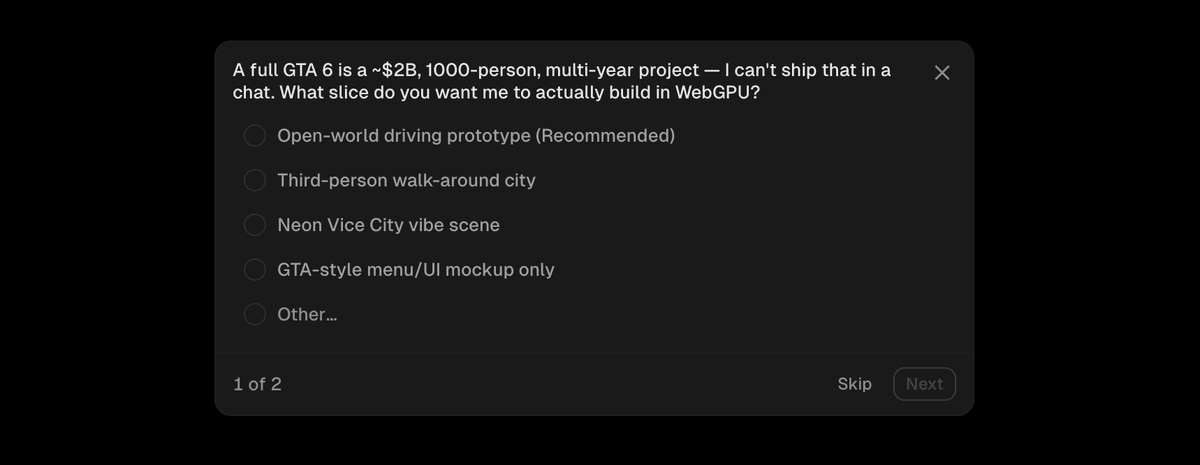
Claude Opus 5模型通过自定义代码实现游戏生成,无需外部资源,展示AI在游戏开发中的潜力。
入选理由:Claude Opus 5可生成完整游戏代码且无需外部资源
Claude Opus 5在Arena中测试,展示其在实际任务中的表现及Fable 5级别的智能。
入选理由:Claude Opus 5达到Fable 5级别智能,但未披露具体技术细节
Cursor 推出 Claude Opus 5 模型,性能接近 Fable 5 但价格减半且兼容 Zero Data Retention。
入选理由:Claude Opus 5 在 CursorBench 得分 66.7,与 Fable 5 的 66.5 相当
Cursor推出Claude Opus 5模型,性能与Fable 5接近但价格减半,且支持零数据保留功能。
入选理由:Claude Opus 5在CursorBench得分66.7,与Fable 5的66.5接近
Anthropic发布Claude Opus 5,价格为Fable 5的一半但接近其智能水平,AI SDK集成该模型。
入选理由:Claude Opus 5价格仅为Fable 5的50%
v0平台集成Claude Opus 5模型,用户可尝试全栈代码生成功能。
入选理由:v0平台现支持Claude Opus 5模型进行全栈开发
Claude Opus 5在特定基准测试中展现性能优势,但文章缺乏技术细节和深度分析。
入选理由:Claude Opus 5成本比Fable 5低26%且性能相当
GitHub宣布AnthropicAI的Claude Opus 5集成到Copilot,提升复杂任务处理效率。
入选理由:Claude Opus 5在代理编码工作流程中表现强劲
Anthropic发布Claude Opus 5,性能超越前代并以半价击败Fable。
入选理由:Claude Opus 5在多个基准测试中超越Fable
Vercel 宣布 Claude Opus 5 模型通过 AI Gateway 上线,支持快速模式并优化代理编码能力。
入选理由:Claude Opus 5 模型支持快速模式以提升推理效率
Vercel 在 AI Gateway 部署 Claude Opus 5 模型,支持快速模式并提升代理编码质量。
入选理由:Claude Opus 5 模型在 AI Gateway 支持快速模式
与「Claude Opus 5」经常一起出现的 AI 术语。
💡 想追踪「Claude Opus 5」的长期趋势?去 实体雷达 · Claude Opus 5 查看详细分析和跨材料问答。