T
traeai
Sign in

产品

vLLM

别名:高效推理库

高效推理引擎

已跟踪 30 条高相关材料

TraeAI 观察

相关材料

已收录 30 条与 vLLM 相关的内容,按评分排序。

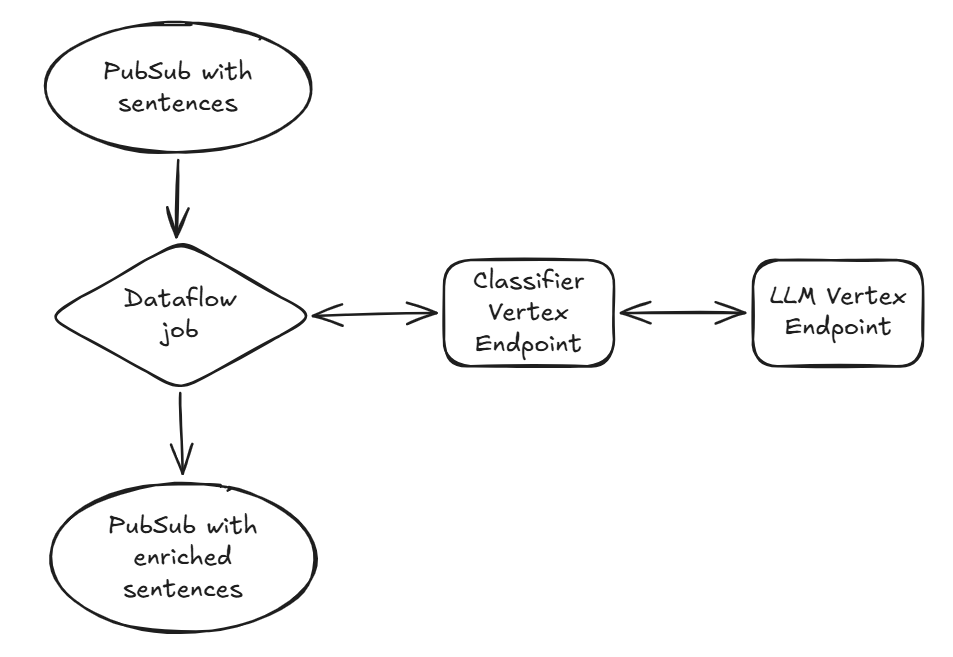
How Trustpilot built a real-time architecture for data enrichment using Gemma

How Trustpilot built a real-time architecture for data enrichment using Gemma

Google Cloud Blog992 字 (约 4 分钟)
92

Trustpilot built a real-time data enrichment pipeline using fine-tuned Gemma models to process millions of reviews under strict latency and cost constraints, achieving near-teacher-model accuracy with full control.

入选理由:采用 google/gemma-2-9b 基础模型,通过共识标注生成高质量训练集,微调后准确率仅比教师模型低几个百分点。

FeaturedArticle#Gemma#Dataflow#LLM#Real-time Architecture#Fine-tuning英文
英伟达重新思考AI TCO:为何每Token成本才是唯一重要的指标

NVIDIA advocates for cost per token as the core economic metric for AI infrastructure, replacing traditional measures like compute cost or FLOPS per dollar, emphasizing full-stack optimization to reduce inference costs and enhance business value.

入选理由:每Token成本是衡量AI基础设施经济效益的核心指标,直接反映实际产出效率。

FeaturedArticle#NVIDIA#AI TCO#Inference Optimization#Cost Per Token中文
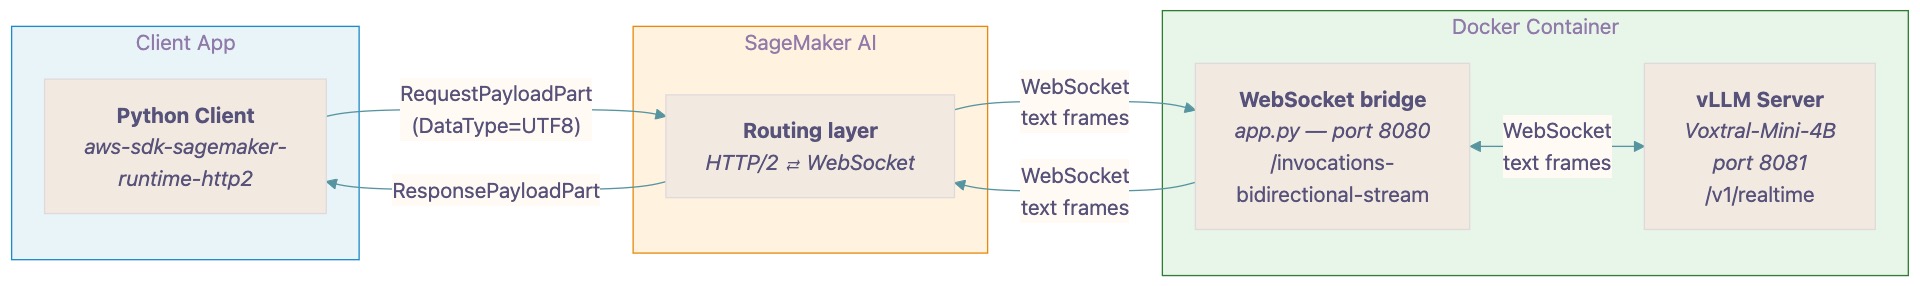
Build real-time voice applications with Amazon SageMaker AI and vLLM

Build Real-Time Voice Applications with Amazon SageMaker AI and vLLM

AWS Machine Learning Blog2911 字 (约 12 分钟)
87

AWS combines SageMaker AI with vLLM to enable bidirectional streaming speech-to-text inference, supporting real-time voice assistants, live captions, and more with significantly reduced latency.

入选理由:SageMaker AI提供原生HTTP/2双向流式传输(端口8443),自动处理HTTP/2事件流与WebSocket协议转换

FeaturedArticle#AWS#SageMaker#vLLM#Voice AI#Streaming Inference英文
Latent Space 图标

[AINews] High Taste Testers Ep. 1

Latent Space5984 字 (约 24 分钟)
85

Meta发布816B参数Muse Spark Open模型,Reflection Beam 1.0开源,含性能、成本及生态对比分析。

入选理由:Muse Spark Open在AA智能指数达39分,超NVIDIA模型13分

FeaturedArticle#AI模型#开源#Meta#性能对比英文
PyTorch Blog 图标

Muse Spark Is Now an Open-Weights Model

PyTorch Blog855 字 (约 4 分钟)
85

Meta发布816B参数开源模型Muse Spark Open,支持多模态和代理任务,集成Helion内核提升性能。

入选理由:Muse Spark Open拥有816B总参数和1M上下文窗口,专为代码生成优化。

FeaturedArticle#PyTorch#开源#AI模型#多模态英文
KDnuggets 图标

5 Fun Projects for LLM Inference Engineering

KDnuggets1382 字 (约 6 分钟)
85

本文推荐了5个LLM推理工程实践项目,涵盖KV缓存、量化、注意力优化等关键技术,适合工程师通过动手学习提升系统性能。

入选理由:构建Mini-vLLM项目可掌握KV缓存和连续批处理机制

FeaturedArticle#LLM#推理工程#Python#CUDA#量化英文
Which is The Best Qwen3.8-27B?

Which is The Best Qwen3.8-27B?

Sam Witteveen4890 字 (约 20 分钟)
85

Qwen3.8-27B模型通过减少思考令牌将推理时间从90秒缩短至18秒,不同优化方法在效率与准确性间取得平衡。

入选理由:Thinking Cap模型通过减少令牌使用将推理时间从90秒缩短至18秒

FeaturedVideo#Qwen3.8-27B#模型优化#推理效率#AI英文
How Shopify built a continual learning loop with PyTorch and vLLM

How Shopify built a continual learning loop with PyTorch and vLLM

PyTorch Blog2165 字 (约 9 分钟)
85

Shopify通过PyTorch和vLLM构建持续学习循环,将生产失败转化为模型权重,提升质量并降低96%服务成本。

入选理由:使用PyTorch和vLLM构建持续学习循环可降低96%服务成本

FeaturedArticle#PyTorch#vLLM#持续学习#机器学习#Shopify英文
Hardware-Agnostic Models in vLLM

Hardware-Agnostic Models in vLLM

PyTorch Blog2004 字 (约 9 分钟)
85

vLLM引入硬件无关层,在NVIDIA H100上实现接近原生性能,吞吐量差异仅3.4%。

入选理由:HW agnostic层在NVIDIA H100上实现3.4%吞吐量差异(几何平均值)

FeaturedArticle#vLLM#PyTorch#GPU优化#模型兼容性英文
Cambricon Joins the PyTorch Foundation as a Platinum Member

Cambricon Joins the PyTorch Foundation as a Platinum Member

PyTorch Blog967 字 (约 4 分钟)
85

Cambricon成为PyTorch基金会铂金会员,致力于推动AI芯片与PyTorch生态的深度整合。

入选理由:Cambricon在PyTorch中贡献了torch.compile、Eager Operators等核心模块。

FeaturedArticle#PyTorch#AI芯片#开源生态#Cambricon#深度学习英文
Databricks 图标

Achieving Extreme Efficiency through Specialized GPU Kernel Generation

Databricks2181 字 (约 9 分钟)
85

Databricks通过专用GPU内核生成实现极端效率,Proteus系统生成的Qwen 3.5 122B内核比vLLM快1.8–5.2倍。

入选理由:Proteus系统生成的Qwen 3.5 122B内核性能比vLLM提升1.8–5.2倍

FeaturedArticle#GPU优化#Proteus#Databricks#AI推理英文
Red Hat AI 图标

How AI inference works, clearly explained

Red Hat AI2212 字 (约 9 分钟)
85

AI推理依赖模型权重、推理服务器和GPU协同工作,KV缓存优化可降低延迟和成本。

入选理由:推理服务器(如vLLM)是实现生产级GPU利用率的关键组件

FeaturedArticle#AI推理#LLM#KV缓存#优化#Red Hat英文
PyTorch Blog 图标

vLLM Sessions at PyTorch Conference North America 2026

PyTorch Blog2985 字 (约 12 分钟)
85

PyTorch 2026北美会议聚焦vLLM在KV缓存优化、硬件适配和生产服务中的技术突破,包含多个开源工具和架构方案。

入选理由:vLLM通过KV Push技术使首token生成时间降低30%

FeaturedArticle#PyTorch#vLLM#KV缓存#LLM推理#开源工具英文
EP223: Ollama vs vLLM vs SGLang

EP223: Ollama vs vLLM vs SGLang

ByteByteGo Newsletter1200 字 (约 5 分钟)
85

Ollama、vLLM、SGLang三大模型引擎各具优势:Ollama适合本地开发,vLLM擅长高并发服务,SGLang优化多轮对话,Claude水印技术通过概率筛选实现内容溯源。

入选理由:Ollama适用于本地开发,采用FIFO队列和GGUF压缩模型

FeaturedArticle#模型推理#AI引擎#大模型#系统设计英文
How Open Source Became AI's Backbone | Inferact with a16z

How Open Source Became AI's Backbone | Inferact with a16z

a16z11384 字 (约 46 分钟)
85

开源推理引擎vLLM通过10倍性能优化和跨芯片兼容性,正在重塑AI基础设施,可能缩小与闭源模型的差距。

入选理由:vLLM支持Nvidia/AMD/Google最新芯片,实现跨平台部署

FeaturedVideo#vLLM#开源AI#推理引擎#a16z中英混合
Together AI Blog 图标

ThunderAgent通过优化KV缓存管理,实现单节点吞吐量提升2倍,集群加速2.4倍,解决代理推理中的缓存抖动问题。

入选理由:单节点吞吐量提升2.5倍,P50延迟降低10倍

FeaturedArticle#ThunderAgent#合成数据生成#LLM推理优化#KV缓存管理英文
148. 对游凯超3小时访谈:开源Infra、和模型Co-design 、“如果vLLM失败,我们会后悔一辈子”

开源项目vLLM的商业化与模型基础设施协同设计为AI领域提供了新思路,揭示了开源社区向企业转型的挑战与技术融合路径。

入选理由:vLLM从论文到开源社区耗时3年,社区维护者放弃个人利益坚持开源精神。

FeaturedPodcast#开源#AI Infra#模型协同设计#创业公司#vLLM中文
Google Developers Blog 图标

Run Ray on TPU, Part 2: Ray AI libraries

Google Developers Blog1659 字 (约 7 分钟)
85

在TPU上部署Ray AI库需通过topology字段确保多主机模型正确分配资源,避免因跨slice通信失败导致部署停滞。

入选理由:设置topology字段可防止多主机模型跨slice部署,避免集体通信失败

FeaturedArticle#TPU#Ray#GKE#AI库#vLLM英文
Driving the Future of Open Source AI: An Update from PyTorch Foundation Projects

PyTorch基金会宣布成立多项目基金会,PyTorch 2.13发布显著优化性能,vLLM推出Model Runner V2并公布2026路线图。

入选理由:PyTorch 2.13在Apple Silicon上实现FlexAttention性能提升至SDPA的12倍

FeaturedArticle#PyTorch#开源AI#模型优化#DeepSpeed#vLLM英文
Open Models are ready for agents. Their APIs are not.

Open Models are ready for agents. Their APIs are not.

Mozilla AI Blog969 字 (约 4 分钟)
85

开源模型已具备代理应用能力,但API兼容性不足成为生产环境瓶颈,Mozilla提出开源网关Otari解决该问题。

入选理由:开源模型推理能力已满足代理产品需求,但API兼容性仅支持基础聊天功能

FeaturedArticle#AI代理#开源模型#API兼容性#Otari英文
KDnuggets 图标

5 Agentic Workflows to Automate Your Data Science Pipeline

KDnuggets5486 字 (约 22 分钟)
85

自动化数据科学流程的5种代理工作流可节省45%时间,Databricks已集成相关功能,核心依赖ReAct循环与LLM工具。

入选理由:数据科学家45%时间消耗在数据清洗,代理可自动化处理

FeaturedArticle#AI#数据科学#自动化#MLOps#Python英文
Hugging Face Blog 图标

Run a vLLM Server on HF Jobs in One Command

Hugging Face Blog1704 字 (约 7 分钟)
85

Hugging Face 提供了一种快速部署 OpenAI 兼容 LLM 的方法,仅需一条命令即可完成。

入选理由:使用 hf jobs run 命令可在 Hugging Face 上一键部署 LLM 服务。

FeaturedArticle#Hugging Face#vLLM#LLM#部署英文
Query Your Codebase with DeepSeek V4 and vLLM

Query Your Codebase with DeepSeek V4 and vLLM

NVIDIA Developer539 字 (约 3 分钟)
85

DeepSeek V4 Flash结合vLLM实现大规模代码库分析,支持长上下文和多模式推理。

入选理由:DeepSeek V4 Flash支持百万级token上下文窗口,适用于大规模代码库分析。

FeaturedVideo#DeepSeek#vLLM#AI#代码分析英文
Scaling Ray Serve LLM on GKE: Performance without losing the developer experience

Scaling Ray Serve LLM on GKE: Performance without losing the developer experience

Google Cloud Blog675 字 (约 3 分钟)
85

Google 与 Anyscale 合作优化 Ray Serve LLM 在 GKE 上的性能,实现吞吐量提升 5 倍、延迟降低 8 倍。

入选理由:通过 HAProxy 集成,减少代理开销并提升吞吐量。

FeaturedArticle#Ray Serve#GKE#LLM#性能优化#Kubernetes英文
The Infrastructure Behind Making Local LLM Agents Actually Useful

The Infrastructure Behind Making Local LLM Agents Actually Useful

Towards Data Science4379 字 (约 18 分钟)
85

Local LLM agents require infrastructure to overcome slow inference and context overflow, solved via vLLM optimization and structured world state — reducing per-call latency from 15s to under 2s and enabling reproducible scientific workflows.

入选理由:使用vLLM优化推理性能,单次调用耗时从15秒降至2秒内

FeaturedArticle#LLM#Agent#Inference#HPC#Open Source英文

跨材料问答 · vLLM

回答基于:vLLM 相关 30 条材料
    0 / 500

    AI may generate inaccurate information. Please verify important content.