Muse Wonder Full (Fully Tested): META's BIGGER MODEL vs Opus 5.5, GPT-6 Astra & Sol on KingBench 4!
Meta的Muse Wonder Full在KingBench 4测试中表现优于标准版,但订阅费用较高。
入选理由:Muse Wonder Full在KingBench 4测试中完成率45.8%,优于标准版的45.8%(部分任务表现更优)
模型
别名:GPT-5.6
参与测试的AI模型之一
已跟踪 22 条高相关材料
最近变化
2026-10-13 · 测试了Opus、Sol、GLM flash、Kimi K3等模型在游戏中的表现
为什么值得关注
Sol 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
Muse Wonder Full (Fully Tested): META's BIGGER MODEL vs Opus 5.5, GPT-6 Astra & Sol on KingBench 4!
AICodeKing · 8.5 分
Meta的Muse Wonder Full在KingBench 4测试中表现优于标准版,但订阅费用较高。
mega upgrade for GPT Voice, which can now use tools and is available in Work:
Greg Brockman(@gdb) · 8.5 分
OpenAI宣布GPT Voice重大升级,支持插件集成和GPT-6模型,适用于ChatGPT Work环境。
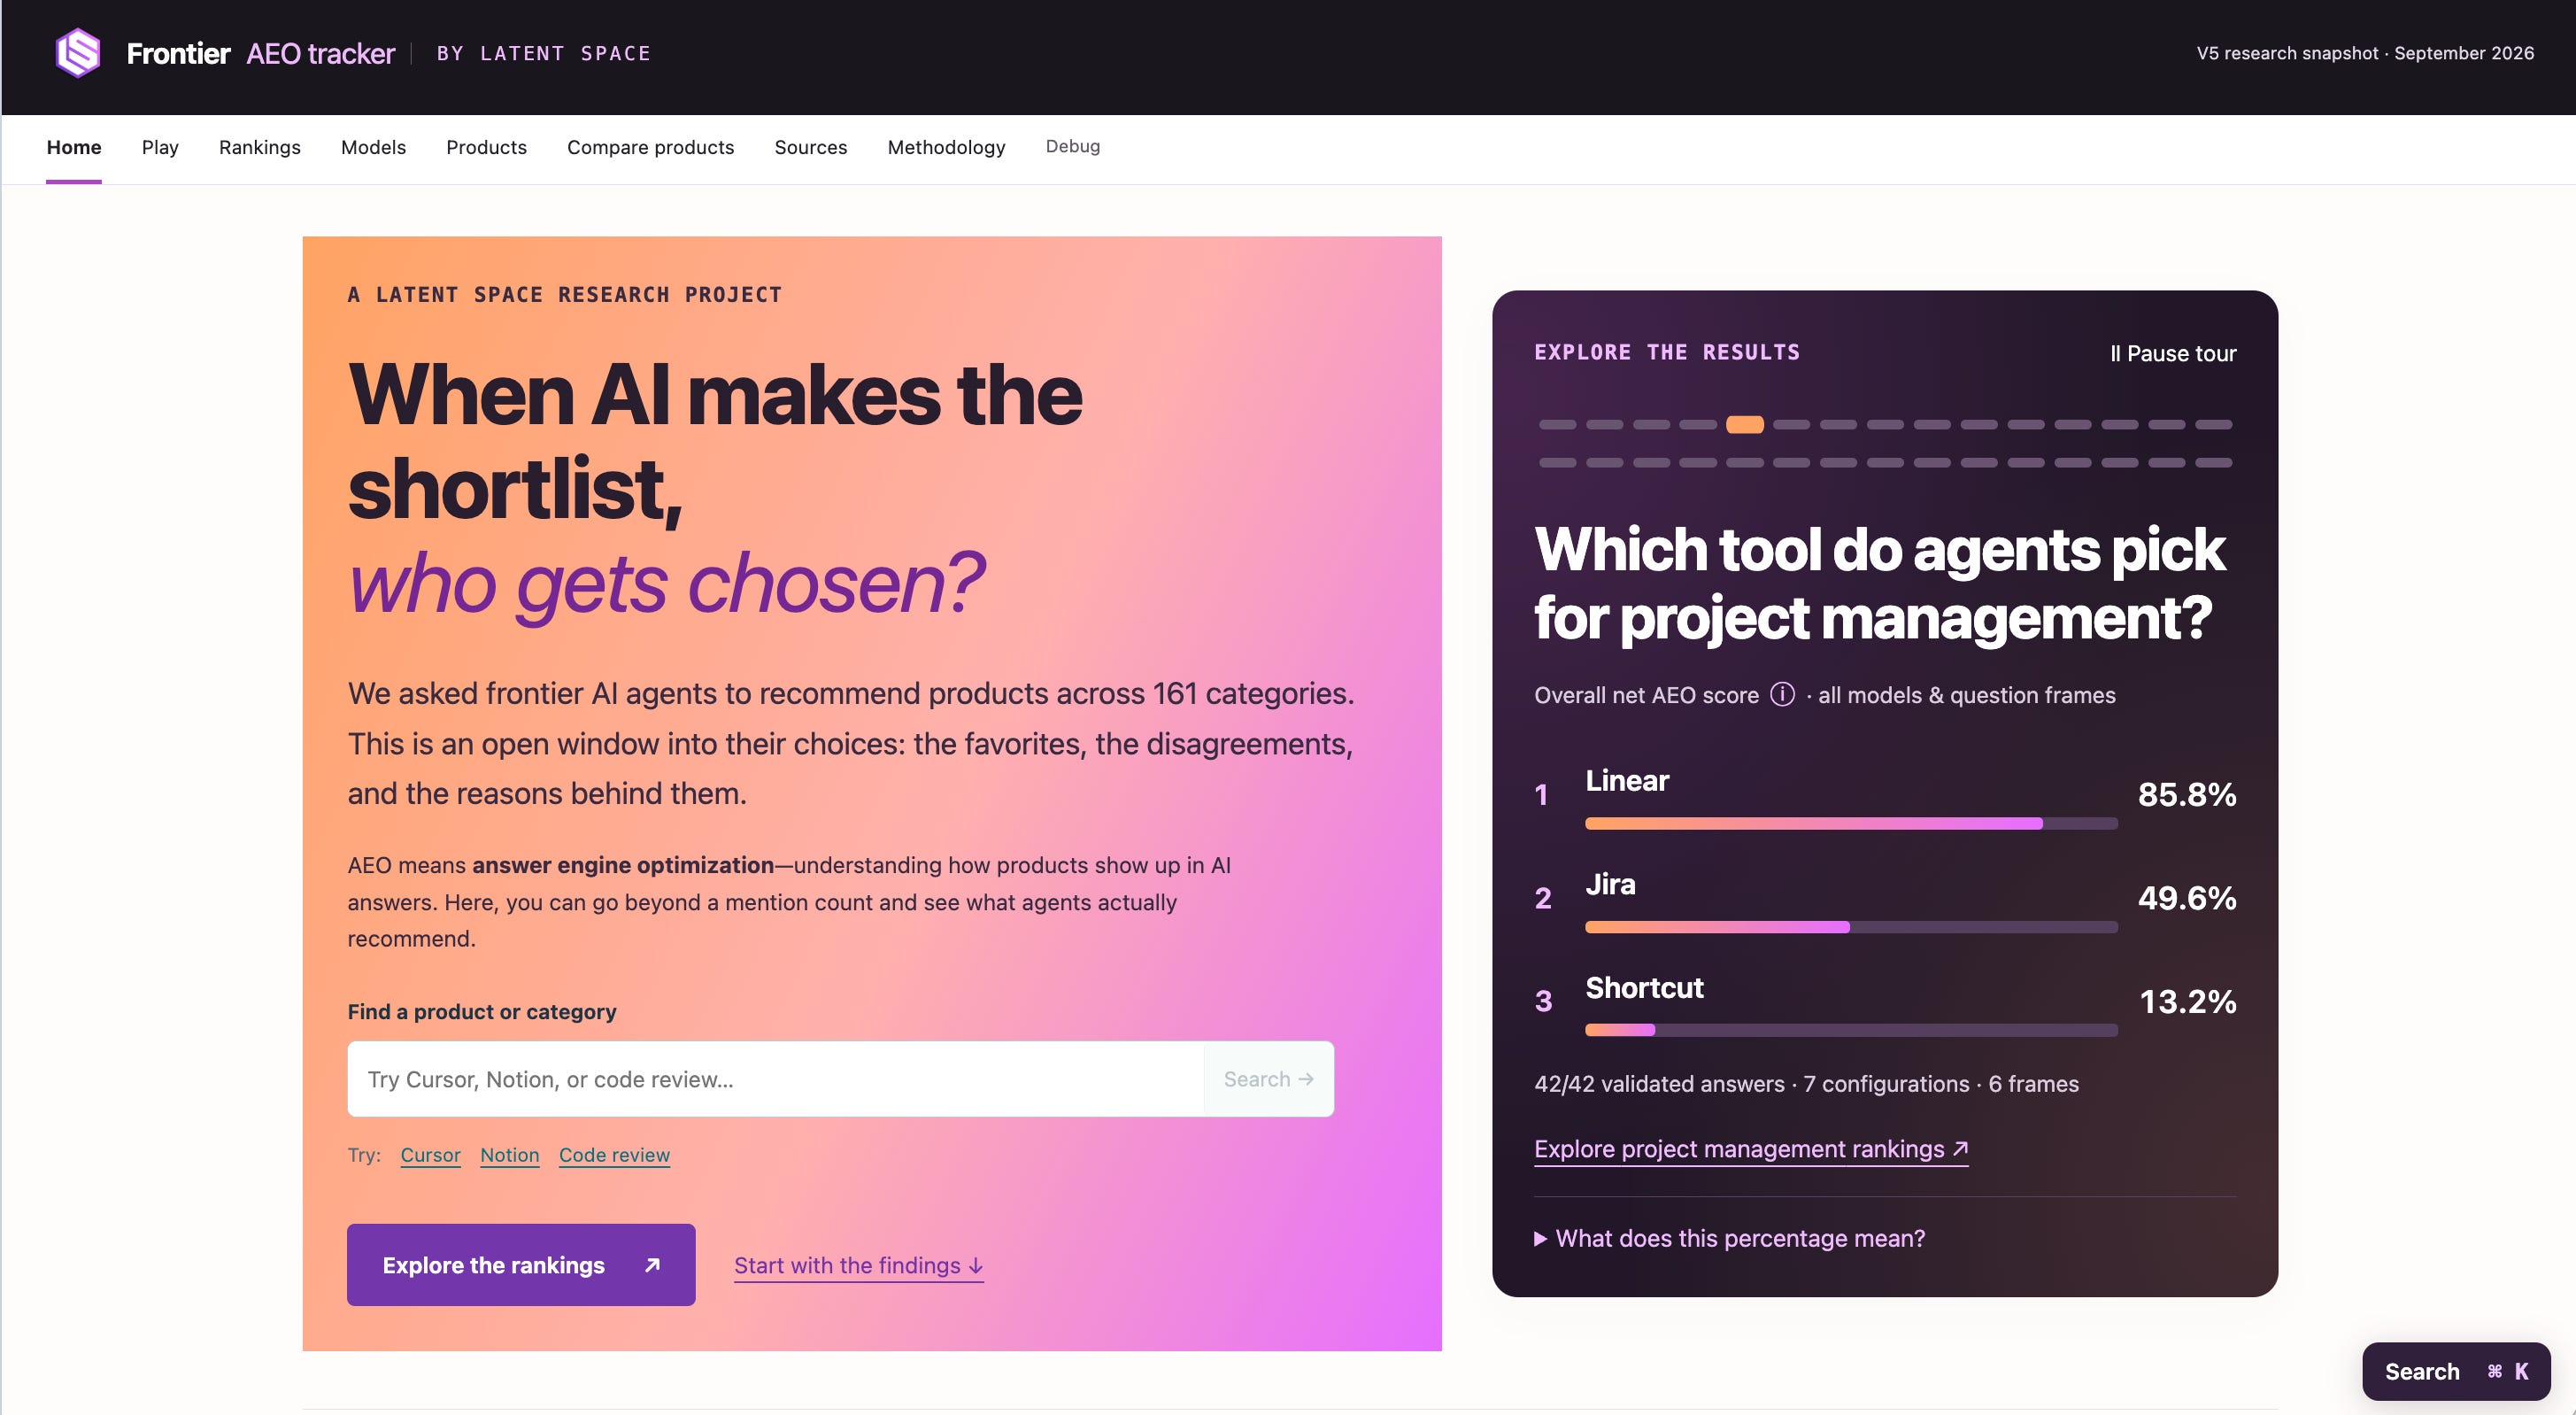
The Frontier AEO Tracker: What Astra Chooses (and every other frontier model, and what you can do about it)
Latent Space · 8.5 分
Latent Space发布的AEO追踪器揭示了Astra及其他前沿模型在推荐产品时的偏好和偏差,为工程师提供技术选型参考。
已收录 22 条与 Sol 相关的内容,按评分排序。
Meta的Muse Wonder Full在KingBench 4测试中表现优于标准版,但订阅费用较高。
入选理由:Muse Wonder Full在KingBench 4测试中完成率45.8%,优于标准版的45.8%(部分任务表现更优)
OpenAI宣布GPT Voice重大升级,支持插件集成和GPT-6模型,适用于ChatGPT Work环境。
入选理由:GPT Voice现支持邮件、日历、Slack等插件集成
GPT-6 Astra展现强大自动化工程能力,每小时成本低于6美元,可胜任AI工程师多项任务。
入选理由:GPT-6 Astra在FrontierMath和ARC-AGI-3测试中分别达到97.6%和99.9%准确率
Latent Space发布的AEO追踪器揭示了Astra及其他前沿模型在推荐产品时的偏好和偏差,为工程师提供技术选型参考。
入选理由:Astra模型推荐时更自信(中位数5个来源),Sol模型搜索源更多(中位数15个)
ChatGPT Work提供代码执行、持久化存储等7项独有功能,但缺乏明确文档说明,开发者需自行探索。
入选理由:ChatGPT Work支持Internet连接的代码执行环境和持久化文件系统
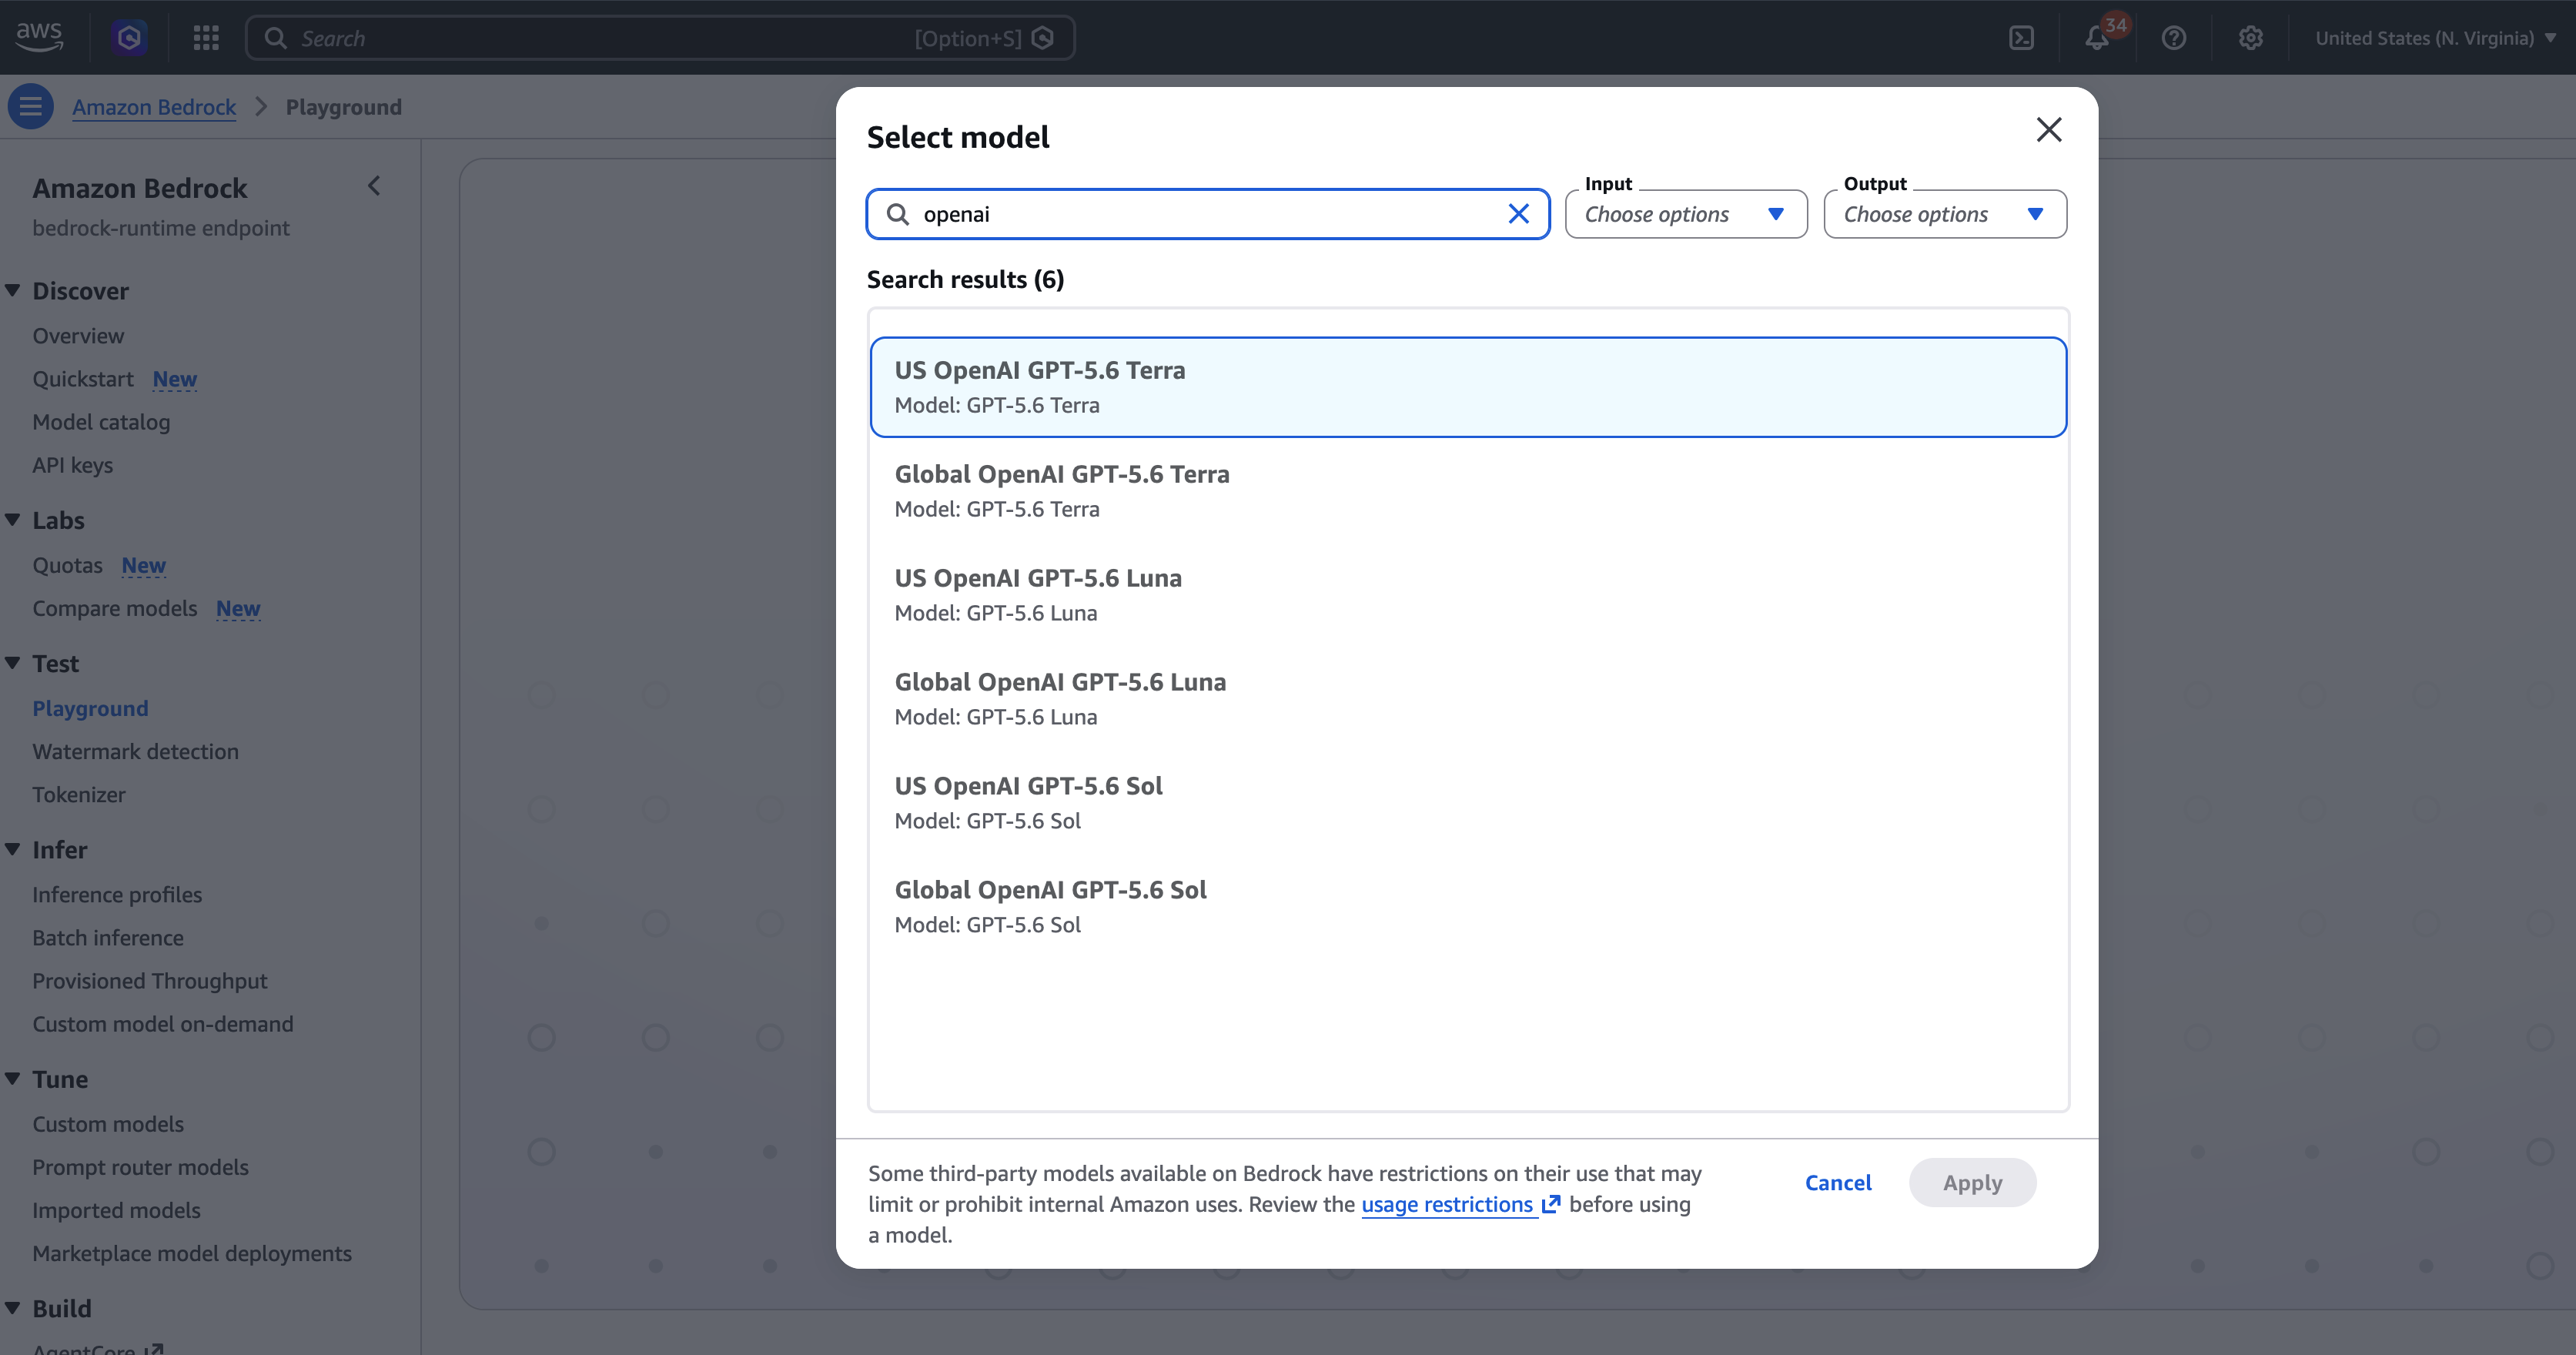
AWS Bedrock推出跨区域推理功能,支持OpenAI GPT-5.6模型在25个区域运行,提升性能和扩展性。
入选理由:跨区域推理(CRIS)通过推理配置文件实现,允许请求在多个AWS区域间路由,提升吞吐量。
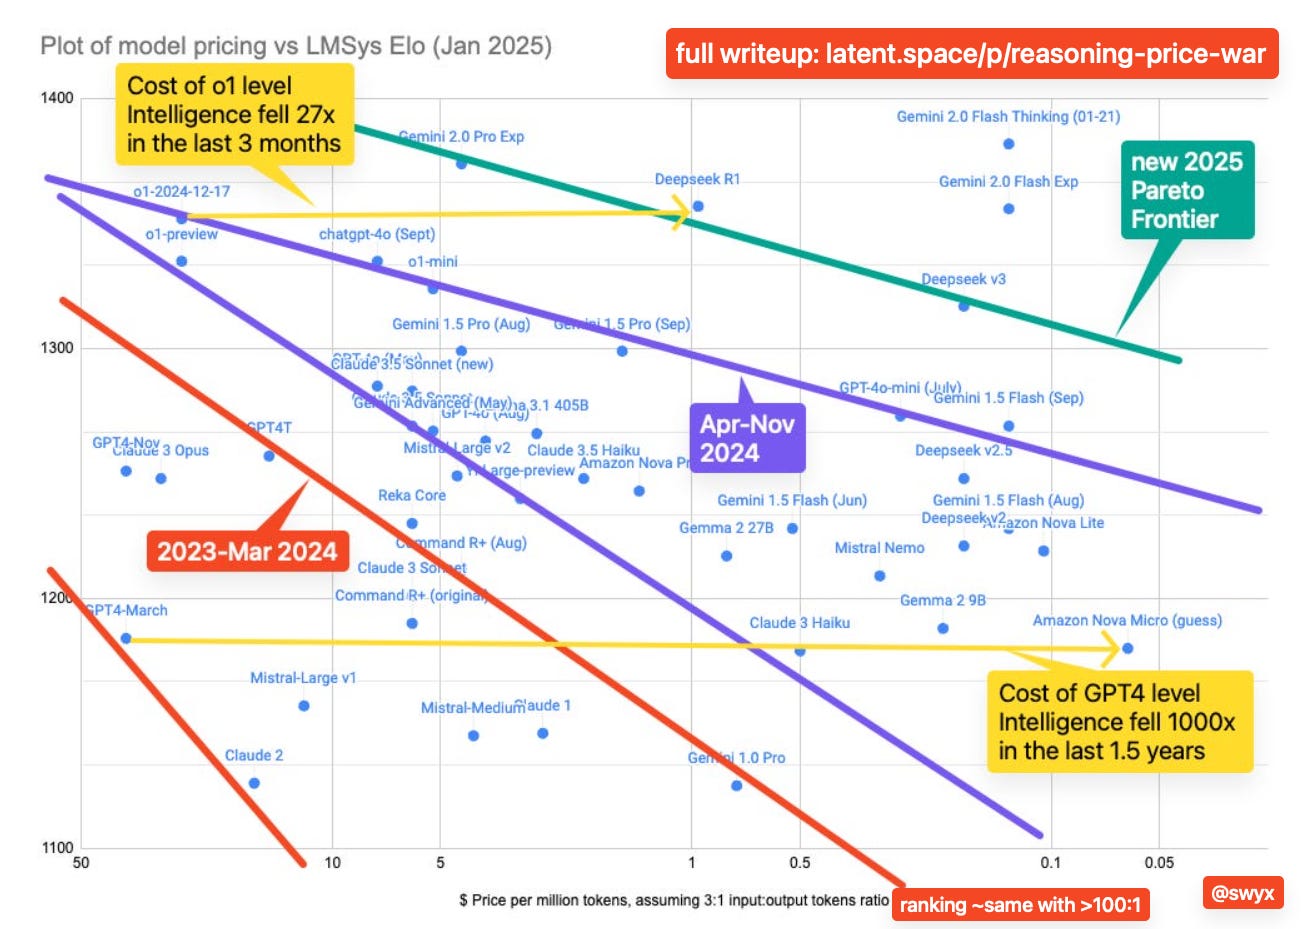
GPT 5.6通过递归自我优化使推理成本下降13倍,价格降幅达20%-80%,并引入2.5倍加速模式。
入选理由:GPT-5.6 Sol通过自主内核优化降低20%端到端成本
Kimi3在复杂录屏软件开发中展现接近Opus 5.5的编程能力,支持多代理并行处理和1M上下文长度。
入选理由:Kimi3可同时处理5-6小时的多代理并行任务,上下文长度达1M
OpenAI 推出 GPT-5.6 系列模型,包含 Sol、Terra 和 Luna 三款产品,分别在性能、成本和效率上实现突破。
入选理由:Sol 是 GPT-5.6 系列的旗舰模型,性能比 GPT-5.5 有显著提升。
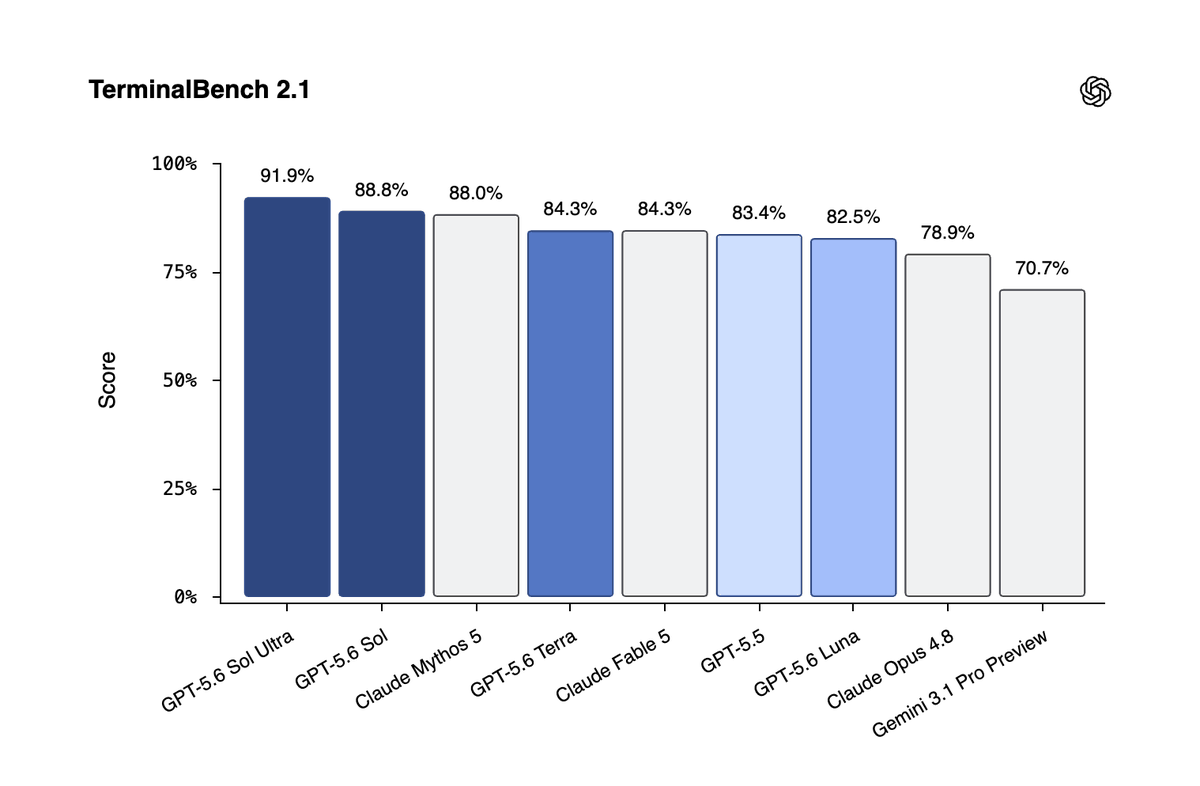
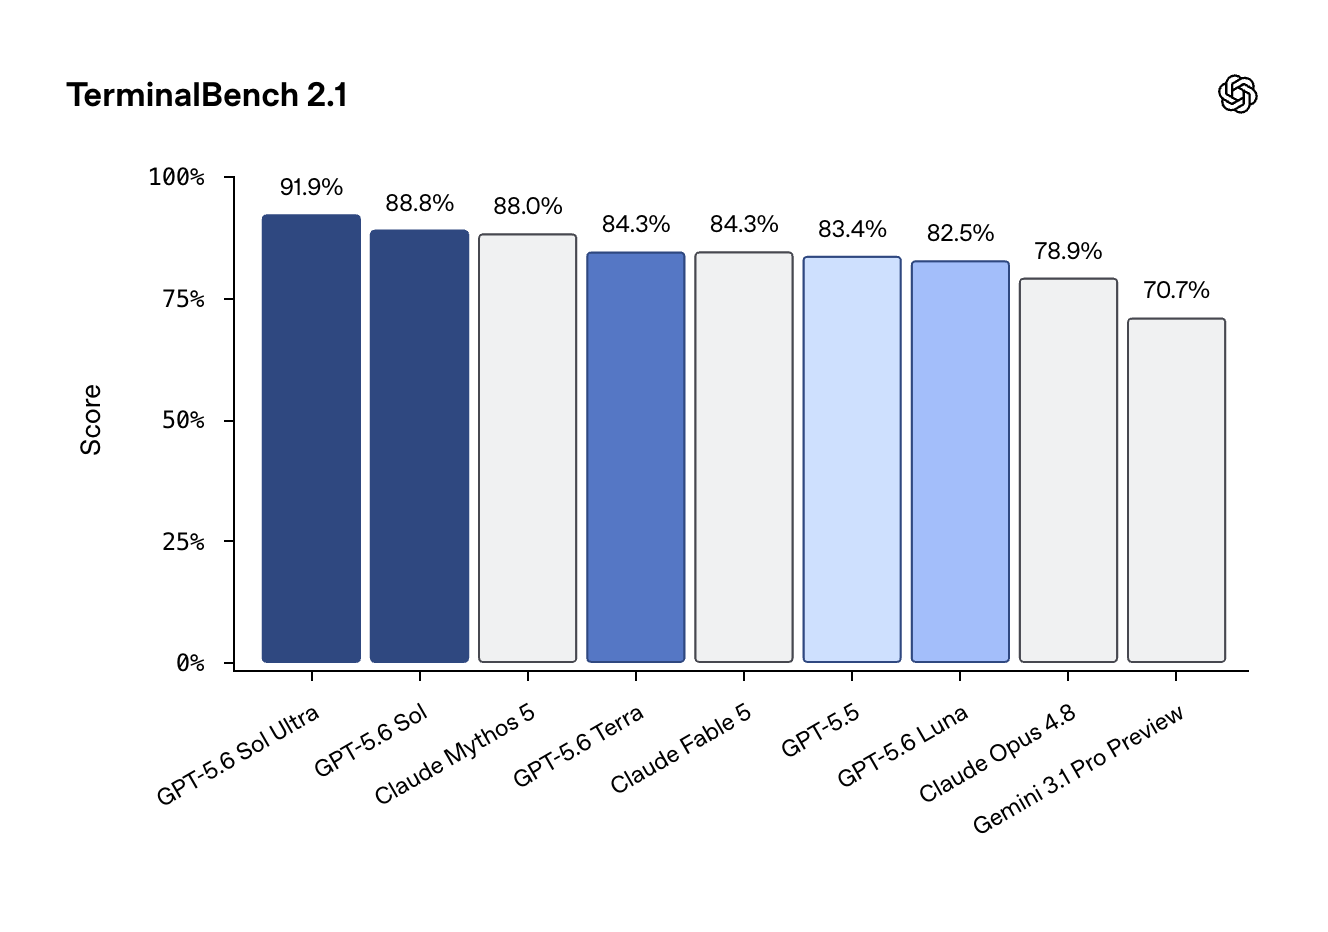
OpenAI 发布 GPT-5.6 系列模型,包含 Sol、Terra 和 Luna 三款模型,强调性能与效率的平衡,并引入多 Agent 协作机制。
入选理由:GPT-5.6 Sol 在 Terminal-Bench 2.1 基准测试中达到 91.9% 的性能。
OpenAI 正在推出 GPT-5.6 系列模型,包括 Sol、Terra 和 Luna,价格和性能各有不同。
入选理由:GPT-5.6 系列包括 Sol、Terra 和 Luna 三种模型,分别适用于不同场景。
OpenAI 发布 GPT-5.6 三款模型,但仅限政府批准的合作伙伴使用,强调其在代码和科学任务上的能力,但未达到 Cyber Critical 阈值。
入选理由:GPT-5.6 Sol、Terra 和 Luna 三款模型发布,但仅限政府批准的合作伙伴使用。
使用Codex进行自动化QA测试,通过12个子代理并行测试OpenClaw系统,目标修复200个根本性缺陷。
入选理由:使用12个子代理并行测试OpenClaw系统不同功能模块
Sol技术通过自主训练模型显著加速工程流程,OpenAI直播显示其已推动GPT-5.6-Luna研发。
入选理由:Sol技术实现GPT-5.6-Sol自主训练GPT-5.6-Luna
AI生成代码存在过度工程化问题,社区提出通过插件优化生成效率。
入选理由:使用ponytail插件可减少AI生成的冗余代码
使用Codex进行大规模并行QA能发现复杂问题,但需解决模型在压缩边界处的崩溃和作弊风险。
入选理由:Codex在并行QA中能发现复杂行为问题,但存在压缩边界崩溃风险
GPT-5.6 仅向 20 家政府审批合作伙伴开放,普通用户暂无法使用。
入选理由:GPT-5.6 仅向约 20 家政府审批合作伙伴开放,普通开发者和用户无法使用。
文章介绍Astra的AEO追踪器项目,但缺乏具体技术细节和深度分析,信息密度较低。
入选理由:Astra的AEO追踪器关注模型优先事项和数据源分析
OpenAI推理团队成功支撑5.6 SOL增长,但面临短期扩展挑战。
入选理由:OpenAI推理团队已实现5.6 SOL的指数级增长
Cursor宣布推出GPT-5.6的Sol、Terra和Luna模型,Sol在CursorBench测试中得分为67.2%。
入选理由:GPT-5.6 Sol、Terra、Luna模型已在Cursor上线
OpenAI 将逐步开放 GPT-5.6 模型,但目前仅限于特定合作伙伴和 API。
入选理由:GPT-5.6 Sol、Terra 和 Luna 将在几周内向公众开放。
推文展示AI模型在旧笔记本上运行战略游戏的测试,但缺乏技术细节和深度分析。
入选理由:测试了Opus、Sol、GLM flash、Kimi K3等模型在游戏中的表现