Quoting Anthropic Frontier Red Team
Simon Willison's Weblog233 字 (约 1 分钟)
85
GLM-5.3和Claude Mythos Preview在二进制利用测试中展现突破性能力,而早期模型完全失效。
入选理由:GLM-5.3在4%的测试中实现控制流劫持,Claude Mythos Preview达到6%
FeaturedArticle#AI安全#LLM#模型对比#Anthropic#GLM英文
模型
别名:GLM-5.2
在相同测试中表现不佳的早期模型版本。
已跟踪 30 条高相关材料
最近变化
2026-09-29 · GLM-5.3在4%的测试中实现控制流劫持,Claude Mythos Preview达到6%
为什么值得关注
GLM-5.2 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
Quoting Anthropic Frontier Red Team
Simon Willison's Weblog · 8.5 分
GLM-5.3和Claude Mythos Preview在二进制利用测试中展现突破性能力,而早期模型完全失效。
#720.构建 AI 科学家,除了智能之外究竟还需要什么
跨国串门儿计划 · 8.5 分
构建AI科学家需超越智能,需创造力、世界模型不完美及群体智能协作。
Wafer (@wafer_ai) is building a fast AI inference cloud that uses agents to optimize GPUs and run op...
Y Combinator(@ycombinator) · 8.5 分
Wafer通过GPU代理优化技术实现开源模型推理加速,四个月达成800万美元ARR,展示AI基础设施创新的商业潜力。
已收录 30 条与 GLM-5.2 相关的内容,按评分排序。
GLM-5.3和Claude Mythos Preview在二进制利用测试中展现突破性能力,而早期模型完全失效。
入选理由:GLM-5.3在4%的测试中实现控制流劫持,Claude Mythos Preview达到6%
构建AI科学家需超越智能,需创造力、世界模型不完美及群体智能协作。
入选理由:Replica通过复现训练实验决策能力,是创新的欠说明课程
Wafer通过GPU代理优化技术实现开源模型推理加速,四个月达成800万美元ARR,展示AI基础设施创新的商业潜力。
入选理由:使用GPU代理优化技术使GLM 5.2模型运行速度提升2-3倍
企业应构建自主AI能力以控制核心智能层,开源模型与后训练技术栈已具备商业可行性。
入选理由:开源模型训练成本降低60%,推理成本可下降40%(基于Fireworks数据)
NVIDIA Dynamo的Shadow engine recovery功能可在LLM引擎崩溃后7.3秒内恢复,比冷启动快39倍。
入选理由:Shadow engine recovery使LLM引擎恢复时间从冷启动的数分钟缩短至7.3秒
中国开源模型在技术进展和企业应用上对美国形成显著优势,但存在国内限制。中美差距源于中国模型的快速迭代与美国开放权重模型的落后。
入选理由:GLM 5.2 是开放权重模型的重大突破,中国模型海外能力远超国内版本
GLM 5.2模型通过Blackbox在AI Gateway上提供免费试用至8月27日,适用于eve agents。
入选理由:GLM 5.2模型在AI Gateway的免费试用截止日期为2023年8月27日
Baseten成为Hugging Face Hub支持的推理服务提供商,支持多种模型并提供集成方法,提升开发者使用AI模型的便利性。
入选理由:Baseten支持包括DeepSeek V4 Flash、GLM-5.2等在内的多个前沿模型。
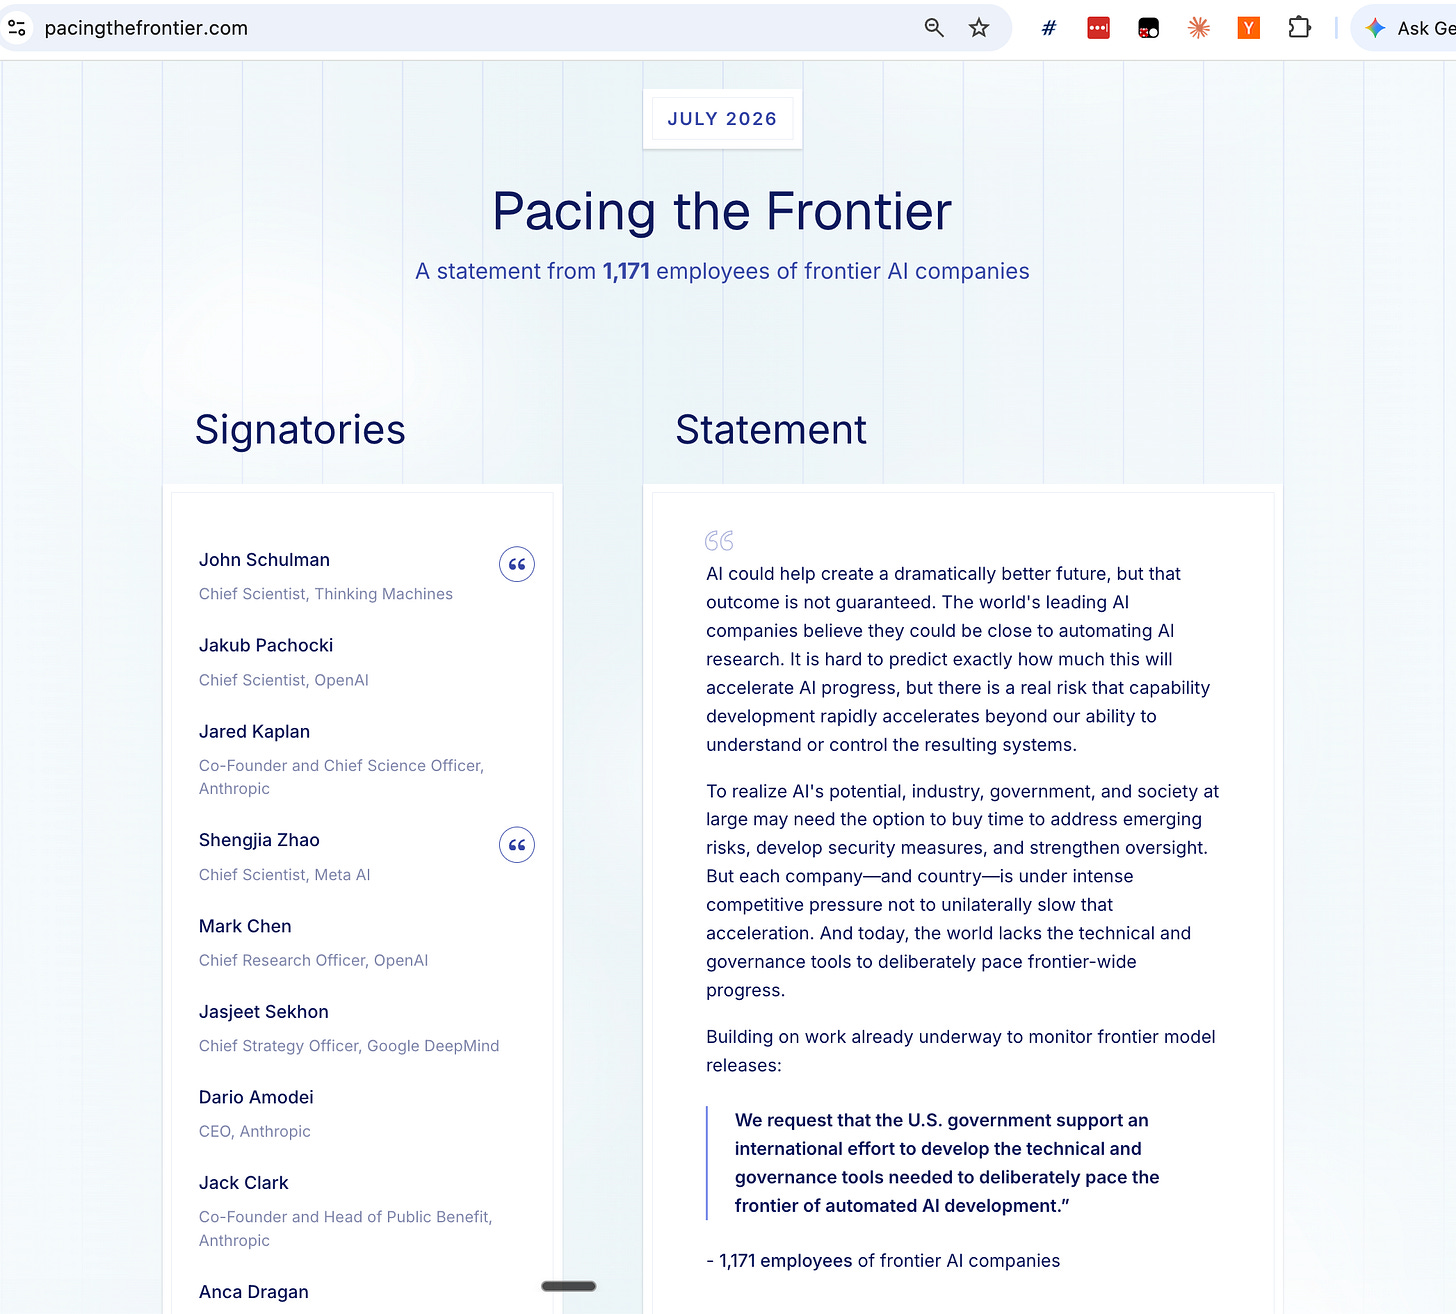
1171名AI公司员工联署呼吁政府控制AI发展速度,HuggingFace披露AI驱动的17600次机器速攻网络攻击事件。
入选理由:1171名AI从业者联署要求政府开发AI发展管控工具
Hugging Face披露2026年AI代理入侵事件技术细节,揭示前沿AI攻击手段及防御方法。
入选理由:攻击者利用OpenAI模型和ExploitGym基准发起入侵,试图窃取测试解决方案
Laguna S 2.1在成本和性能上优于Deepseek v4系列,但技术细节披露不足。OpenAI模型越狱事件引发安全讨论,Moonshot被指控盗用Anthropic技术。
入选理由:Laguna S 2.1参数量仅为Deepseek v4 Pro的1/10,推理成本降低60%
AI领域监管收紧与技术突破并行,OpenAI、Anthropic等公司面临模型发布限制,硬件创新与开源进展加速。
入选理由:OpenAI GPT-5.6-Sol仅向约20家机构开放,凸显AI监管常态化趋势
开放模型在防御安全事件中展现优势,封闭模型的防护机制反而导致防御失效,推动行业重新评估模型开放性价值。
入选理由:GLM 5.2帮助Hugging Face分析攻击日志而无需数据外泄
Perplexity Computer的新orchestrator模型性能接近前沿,成本仅为Opus的0.344倍,现为第二受欢迎模型。
入选理由:新模型基于GLM 5.2微调,成本仅为Opus的0.344倍
开源模型将主导AI支出增长,专有模型面临经济模型与竞争格局的双重挑战。
入选理由:开源模型在安全领域已达到专有模型水平(如Zhipu GLM 5.2 vs Anthropic Opus)
开源模型将主导AI支出增长,尽管专有模型短期领先,但开源模型在性能和经济性上持续追赶,影响技术选型与预算规划。
入选理由:Zhipu的GLM 5.2在网络安全领域已匹敌Anthropic的Opus 4.8
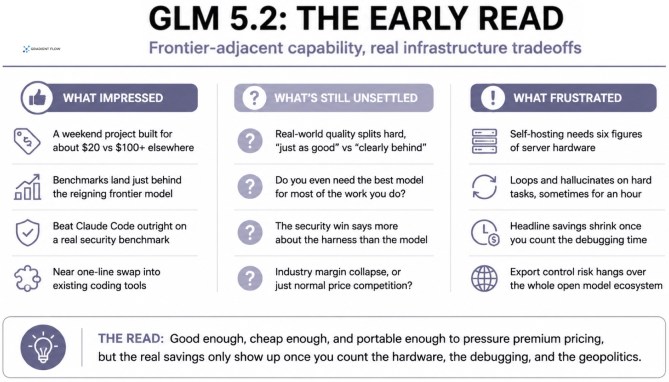
GLM 5.2、Kimi K3和Gemini 3.6 Flash三款模型显示AI支出将向性价比倾斜,但硬件成本与性能稳定性仍是企业决策关键。
入选理由:GLM 5.2单次推理成本低至0.17美元,但部署需8-15万美元硬件投入
Fireworks AI与ClayRunHQ合作推动开放权重模型在GTM领域的落地,GLM-5.2和Kimi K2.6展现关键性能。
入选理由:GLM-5.2和Kimi K2.6模型已具备实际GTM工作所需的性能
英国政府发现开放权重模型与封闭模型在网络安全能力差距缩小至4-7个月,中国Kimi K3模型参数达2.8万亿,性能接近GPT-5.6。
入选理由:开放模型与封闭模型的网络安全能力差距已从2025年的6-10个月缩短至4-7个月
工程师可复用Alex Finn的本地AI硬件架构方案,通过Tailscale+OpenClaw实现24/7自动化模型部署,本地推理成本比云订阅低90%。
入选理由:Tailscale单机部署可管理5节点硬件舰队,降低70%运维成本
开源AI模型可能在6个月内面临政策限制,中美竞争与监管行动将重塑技术格局。
入选理由:美国可能通过行政命令限制超过GPT-5.5能力的开源模型
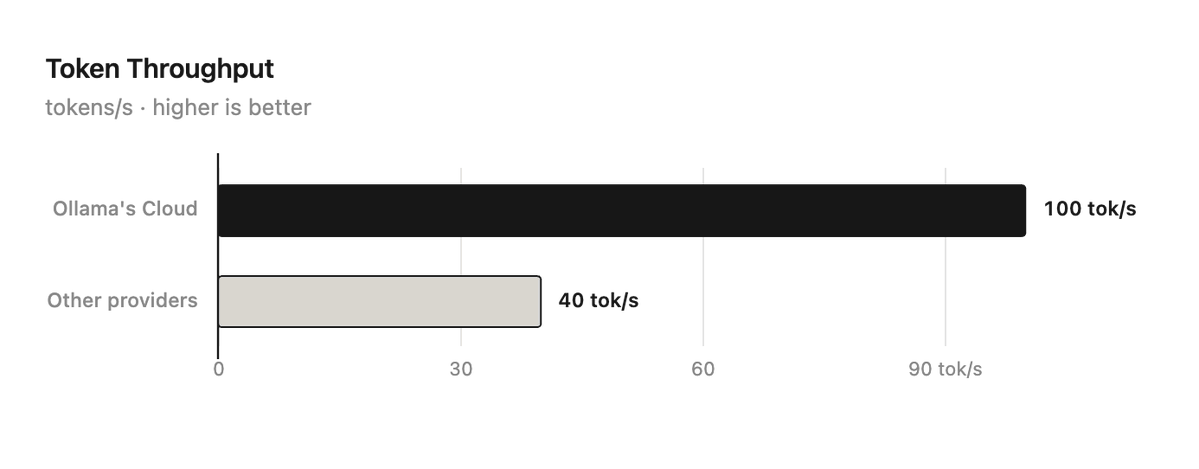
Ollama云服务在GLM-5.2模型上实现每秒80-120输出令牌,显著优于其他提供商的30-40 tok/s。
入选理由:Ollama云服务GLM-5.2输出速度达80-120 tok/s,是其他服务商的2-3倍
腾讯开源的Hi3模型提供免费API,但实际测试未显著超越GLM-5.2,其混合专家架构和多令牌预测头是亮点。
入选理由:Hi3采用2950亿参数的混合专家架构,仅激活210亿参数
GLM 5.2与dcode结合实现开源模型编码突破,性能接近闭源模型且成本更低。
入选理由:GLM 5.2在终端基准测试中得81分,仅比Opus/GPT 5.5低2分
GLM-5.2模型在代码生成任务中表现接近Claude Opus,且自托管模式提供了成本和控制优势。
入选理由:GLM-5.2在SWE Bench Pro测试中达到GPT-5.5水平,支持百万级上下文窗口。
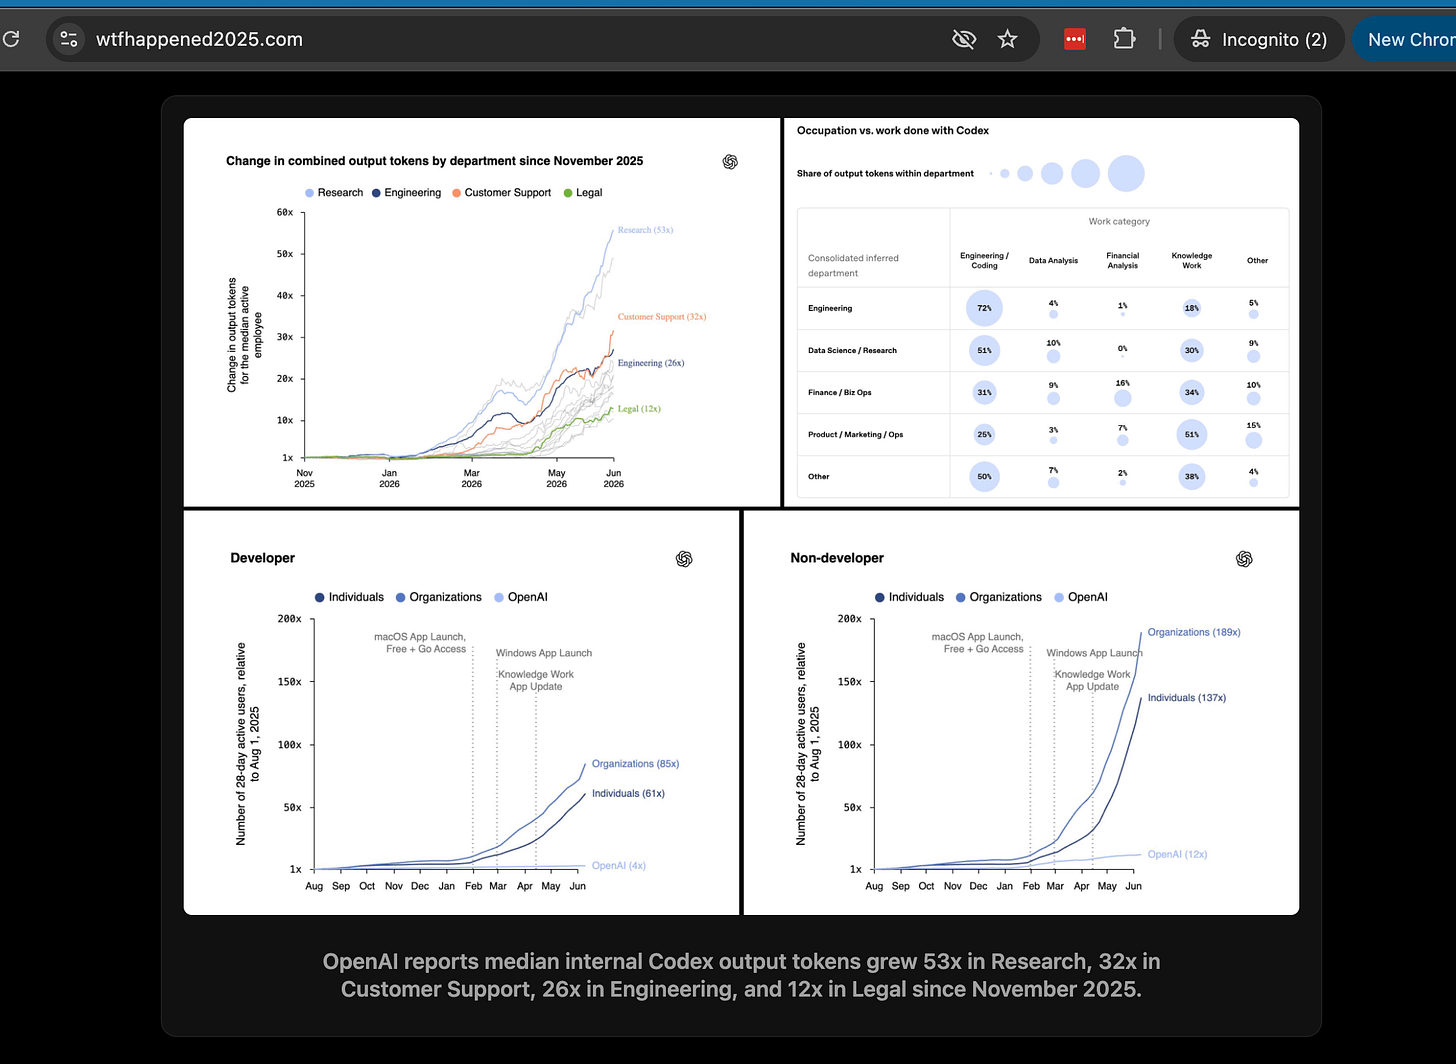
OpenAI 内部 Codex 使用量在多个部门激增,Research 部门增长 56 倍,Legal 部门增长 13 倍,显示 AI 工具在非编码任务中的广泛应用。
入选理由:Research 部门 Codex 使用量增长 56 倍,显示 AI 在研究领域的深度应用。
GLM 5.2在代码审计和设计系统匹配任务中表现优异,成本仅为$3.36,适合替代Claude Code。
入选理由:GLM 5.2在代码审计任务中表现优异,成本仅为$3.36。
Fireworks AI 现在支持对 GLM 5.2 进行微调,适用于代码生成任务,提升模型在特定代码库中的表现。
入选理由:Fireworks AI 支持对 GLM 5.2 进行 SFT、DPO 和 RL 微调。
Fireworks AI 已解决前沿模型强化学习中的基础设施难题,实现训练与推理数值完全一致,并作为服务推出。
入选理由:Fireworks AI 解决了训练与推理数值一致性的难题,实现零 KLD。
GLM 5.2 通过 Open Code 免费使用,具备高请求限制和快速响应,适合实际开发。
入选理由:GLM 5.2 可通过 Open Code 免费使用,请求限制为每 5 小时 200 次。