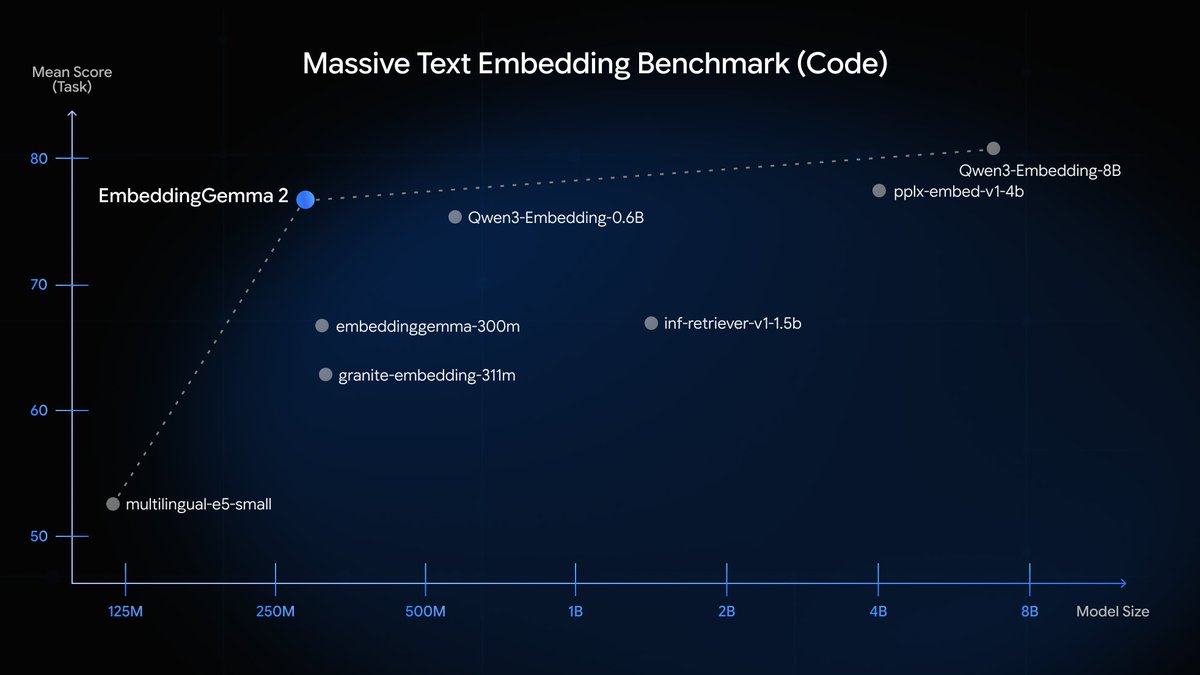
At 740M parameters, it’s competitive across benchmarks – even outperforming some specialist models m...
Google DeepMind发布7.4亿参数模型,性能超越部分两倍大小专用模型,支持多模态搜索和私有设备RAG。
入选理由:4亿参数模型在基准测试中超越部分两倍大小的专用模型
概念
别名:Apache License 2.0
允许商业使用的开源许可证
已跟踪 30 条高相关材料
最近变化
2026-10-06 · 4亿参数模型在基准测试中超越部分两倍大小的专用模型
为什么值得关注
Apache 2.0 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
At 740M parameters, it’s competitive across benchmarks – even outperforming some specialist models m...
Google DeepMind(@GoogleDeepMind) · 8.5 分
Google DeepMind发布7.4亿参数模型,性能超越部分两倍大小专用模型,支持多模态搜索和私有设备RAG。
Pizza Bot: Open-Source Inbox for Background AI Agents
InfoQ · 8.5 分
Pizza Bot是AWS开源的AI代理管理工具,通过邮箱式界面管理后台任务,支持本地数据存储和多模型提供商。
New Apache 2.0 model from @Aleph__Alpha. It's really good. If you like that, you're going to love ...
cohere(@cohere) · 8.5 分
Aleph Alpha发布78B参数的Apache 2.0模型Kolibri,支持1M tokens上下文,欧洲开发并开放权重。
已收录 30 条与 Apache 2.0 相关的内容,按评分排序。
Google DeepMind发布7.4亿参数模型,性能超越部分两倍大小专用模型,支持多模态搜索和私有设备RAG。
入选理由:4亿参数模型在基准测试中超越部分两倍大小的专用模型
Pizza Bot是AWS开源的AI代理管理工具,通过邮箱式界面管理后台任务,支持本地数据存储和多模型提供商。
入选理由:Pizza Bot采用客户端-服务器架构,支持多种模型提供商和MCP服务器。
Aleph Alpha发布78B参数的Apache 2.0模型Kolibri,支持1M tokens上下文,欧洲开发并开放权重。
入选理由:Kolibri模型参数量达78B,活跃参数3.46B
IBM发布3.85亿参数的Granite Time Series PatchTST-FM-r2模型,支持零样本预测且采用Apache 2.0/OpenMDW 1.0双许可,在GIFT-Eval基准测试中位列第二。
入选理由:模型参数约3.85亿,支持8192长度上下文和99分位数概率预测
开源模型许可证呈现两极分化趋势,西方厂商转向Apache 2.0,中国头部厂商设置商业使用门槛。
入选理由:Google和Meta已全面采用Apache 2.0许可证
Mistral AI发布Shieldstral,一个3B参数的开放权重内容安全模型,支持多模态审核并可在设备部署。
入选理由:Shieldstral是3B参数模型,基于Apache 2.0许可证开放
Cloudflare开源隐私代理CLI工具pvcli,简化Oblivious HTTP协议调试,支持Apache-2.0许可证。
入选理由:pvcli工具可执行完整Oblivious HTTP请求,涉及relay/gateway/origin三方协作
Impeccable是一个开源设计工具,可提升AI生成前端设计的质量,兼容多种AI编码工具。
入选理由:Impeccable通过41条设计规则提升AI生成界面质量,GitHub获得48,000星
Thinking Machines发布名为Inkling的开源模型,参数量达41B,支持多模态,可与GPT-5.6竞争。
入选理由:Inkling模型参数量达41B,支持文本/音频/图像多模态处理
xAI开源Grok Build代码库,回应数据隐私争议,强调用户数据删除与隐私保护。
入选理由:Grok Build代码库包含84.4万行Rust代码,仅3%为第三方依赖
Thinky发布975B参数多模态模型Inkling,支持文本/图像/音频,开放权重且兼容Huggingface等平台。
入选理由:Inkling拥有975B总参数(41B激活参数),训练数据达45万亿token
腾讯Hy3模型在OpenRouter LLM排行榜登顶,295B MoE参数量,Apache 2.0开源,提供免费API。
入选理由:Hy3模型参数量达295B MoE,性能媲美万亿级旗舰模型
腾讯开源的Hi3模型提供免费API,但实际测试未显著超越GLM-5.2,其混合专家架构和多令牌预测头是亮点。
入选理由:Hi3采用2950亿参数的混合专家架构,仅激活210亿参数
EasyOCR 仅能提取文本,无法解析文档结构,而 Docling 可提取文本、段落、图表等结构信息,更适合 RAG 系统。
入选理由:EasyOCR 仅能提取文本,无法解析文档结构。
PoolsideAI 现在默认开放模型权重,Laguna M.1 模型已发布,支持 256K 上下文长度。
入选理由:Laguna M.1 模型支持 256K 上下文长度,适用于长序列任务。
Gemma 4 26B MoE 在多代理编程任务中表现优异,结合 Ollama 和 Claude Code 可构建本地高效代理系统。
入选理由:Gemma 4 26B MoE 在 τ2-bench 上得分 79%,显著优于 Gemma 3 27B 的 6.6%。
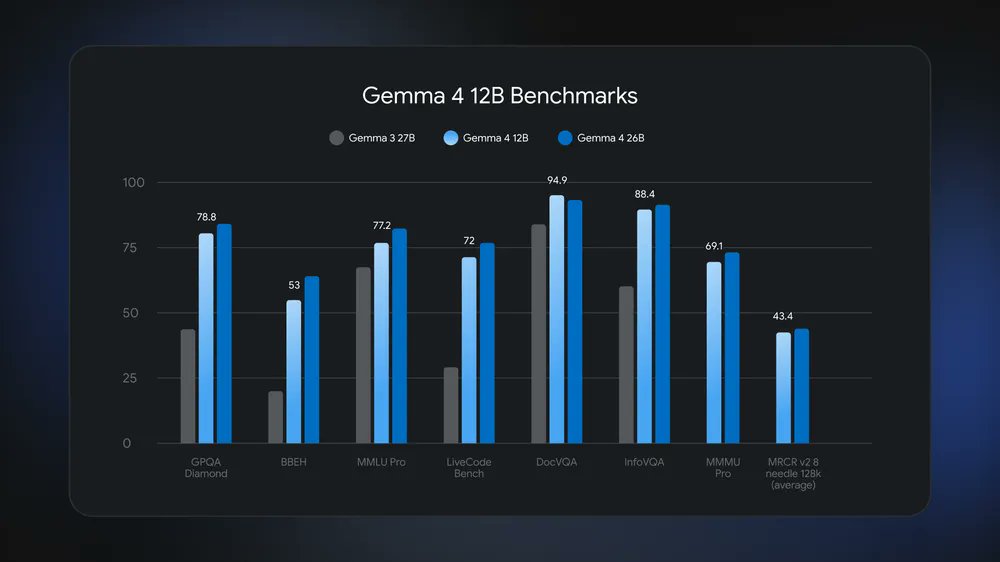
Gemma 4 12B 是 Google DeepMind 推出的首个无需编码器的多模态模型,可在 16GB 显存的笔记本电脑上运行。
入选理由:Gemma 4 12B 在 16GB 显存的笔记本电脑上即可运行。
谷歌推出DiffusionGemma模型,采用扩散机制实现文本生成速度提升4倍,支持本地运行。
入选理由:DiffusionGemma在H100上每秒生成1000+ tokens,比自回归模型快4倍。
Cohere 发布了一个参数量为 300 亿、活跃参数为 30 亿的高效模型,其在编码基准测试中得分达 33.4,且采用 Apache 2.0 开源协议。
入选理由:Cohere 发布了参数量为 300 亿的高效模型,活跃参数为 30 亿。
Step 3.7 Flash is a 196B MoE model designed from the ground up for inference efficiency, using MFA and AFD techniques to reduce KV-cache usage to ~22% of DeepSeek, supporting agent, coding, and multimodal workflows, open-sourced under Apache 2.0 and available on Fireworks.
入选理由:Step 3.7 Flash 是 196B MoE 模型,从设计之初就聚焦推理效率,而非事后优化。
Datadog releases Toto 2.0, achieving scaling laws in time series foundation models.
入选理由:Toto 2.0 参数范围覆盖 4M 到 2.5B,每个版本均超越前代性能。
Meta推出30B参数模型Muse Glimmer,支持本地运行且开放权重,性能优于同类模型。
入选理由:Muse Glimmer是Meta发布的30B参数模型,专为本地代理工作流优化。
腾讯Hy3模型以295B MoE参数和21B活跃参数实现低成本高效能,支持256K上下文窗口和Apache 2.0许可证。
入选理由:Hy3采用295B MoE结构但仅激活21B参数,降低推理成本
Google released Gemma 4 12B, a multimodal model runnable locally on laptops with 16GB VRAM under Apache 2.0 license. With over 150 million downloads, its encoder-free unified architecture balances edge efficiency and advanced reasoning for local AI development.
入选理由:Gemma 4 12B可在仅16GB VRAM的笔记本上本地运行,大幅降低多模态模型部署门槛。
Gemma 4 12B is the first mid-sized multimodal model with native audio input, featuring a unified encoder-free architecture that runs on 16GB VRAM, matches 26B benchmark performance, and uses Apache 2.0 license.
入选理由:Gemma 4 12B采用无编码器统一架构,直接将视觉与音频信号输入LLM,降低推理延迟。
Google released Gemma 4 12B, an open-weight multimodal model under Apache 2.0 that runs natively on laptops. Its encoder-free unified architecture balances edge efficiency with advanced reasoning for local AI development.
入选理由:Gemma 4 12B是120亿参数开源多模态模型,可在普通笔记本上直接运行推理。
欧洲主权模型依赖GLM和Qwen数据,Aleph Alpha发布78B参数开源模型Kolibri,支持Apache 2.0授权。
入选理由:欧洲主权模型使用GLM和Qwen生成的数据进行微调
腾讯HY开源Hy4模型,参数量达770B,支持1M上下文长度,采用Apache 2.0许可证。
入选理由:Hy4模型总参数量770B,单token激活参数49B
Cohere发布新视觉语言模型North Micro Vision,在文档理解和视觉问答任务中超越多个大模型,且开源可用。
入选理由:North Micro Vision在视觉理解基准测试中超越Gemma 4 E2B和Ministral 3 3B模型
Cohere发布开源视觉语言模型North Micro Vision,适用于文档理解,可免费部署。
入选理由:North Micro Vision是Cohere最小的视觉语言模型,专为文档理解设计