T
traeai
登录

产品

什么是 XNNPACK?

Google 的高性能神经网络推理加速库。

为什么现在值得关注?

最近变化

2026-10-19 · LiteRT Tensor API允许用C++直接编写计算图,无需为CPU/GPU/NPU重写代码

XNNPACK 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。

📰 XNNPACK 最新动态

已收录 2 篇与「XNNPACK」相关的 AI 资讯和分析。

Google Developers Blog 图标

Native Model Authoring for Edge with LiteRT Tensor API

Google Developers Blog2168 字 (约 9 分钟)
85

Google推出LiteRT Tensor API,解决边缘设备AI模型部署的跨平台兼容性与性能优化难题,支持C++原生编写与多硬件直接运行。

入选理由:LiteRT Tensor API允许用C++直接编写计算图,无需为CPU/GPU/NPU重写代码

精选文章#LiteRT Tensor API#边缘计算#AI模型部署#Google英文
Blazing fast on-device GenAI with LiteRT-LM

LiteRT-LM:设备端 GenAI 的极速体验

Google Developers Blog1574 字 (约 7 分钟)
75

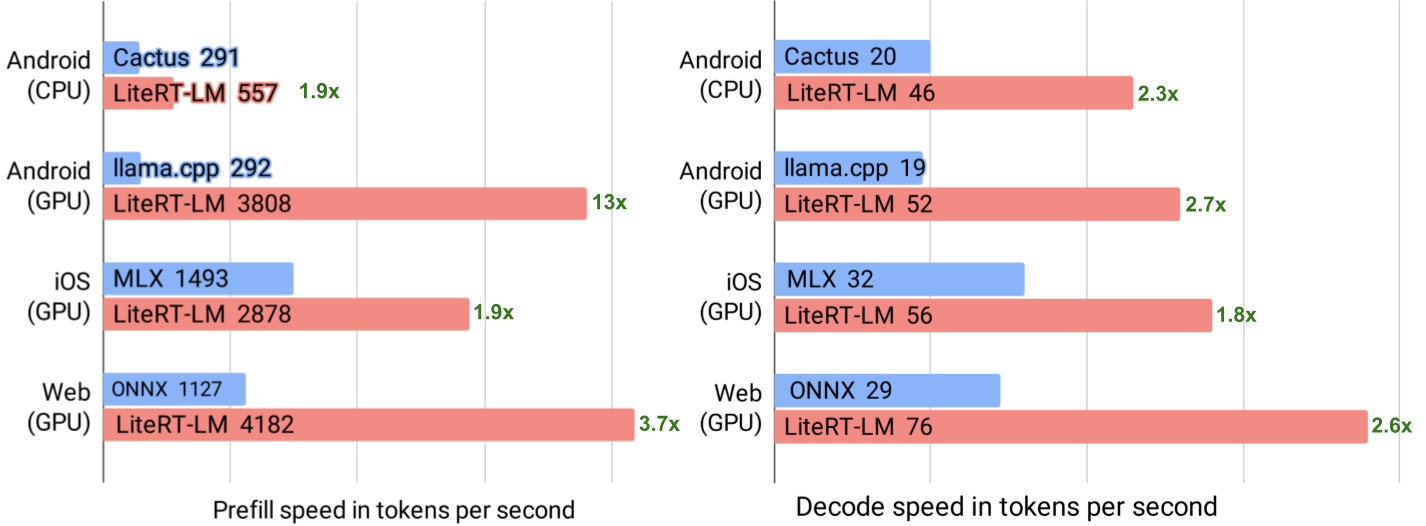
Google AI Edge 发布 LiteRT-LM 推理引擎,专为在边缘设备上高效运行 Gemma 4 模型设计,支持 Android、iOS、Web 多平台,GPU 推理可达 76 tokens/sec,结合 Multi-Token Prediction 技术实现 2.2 倍加速。

入选理由:LiteRT-LM 在 Android GPU (OpenCL) 上实现 52 tokens/sec 解码速度,iOS (Metal) 达 56 tokens/sec,WebGPU 在 MacBook Pro 上可达 76 tokens/sec

精选文章#Google AI Edge#LiteRT-LM#Gemma 4#边缘AI#端侧推理英文

与「XNNPACK」经常一起出现的 AI 术语。

💡 想追踪「XNNPACK」的长期趋势?去 实体雷达 · XNNPACK 查看详细分析和跨材料问答。

AI 可能会生成不准确的信息,请核实重要内容