Inside the Model Factory — Eiso Kant, Poolside AI
Latent Space27049 字 (约 109 分钟)
85
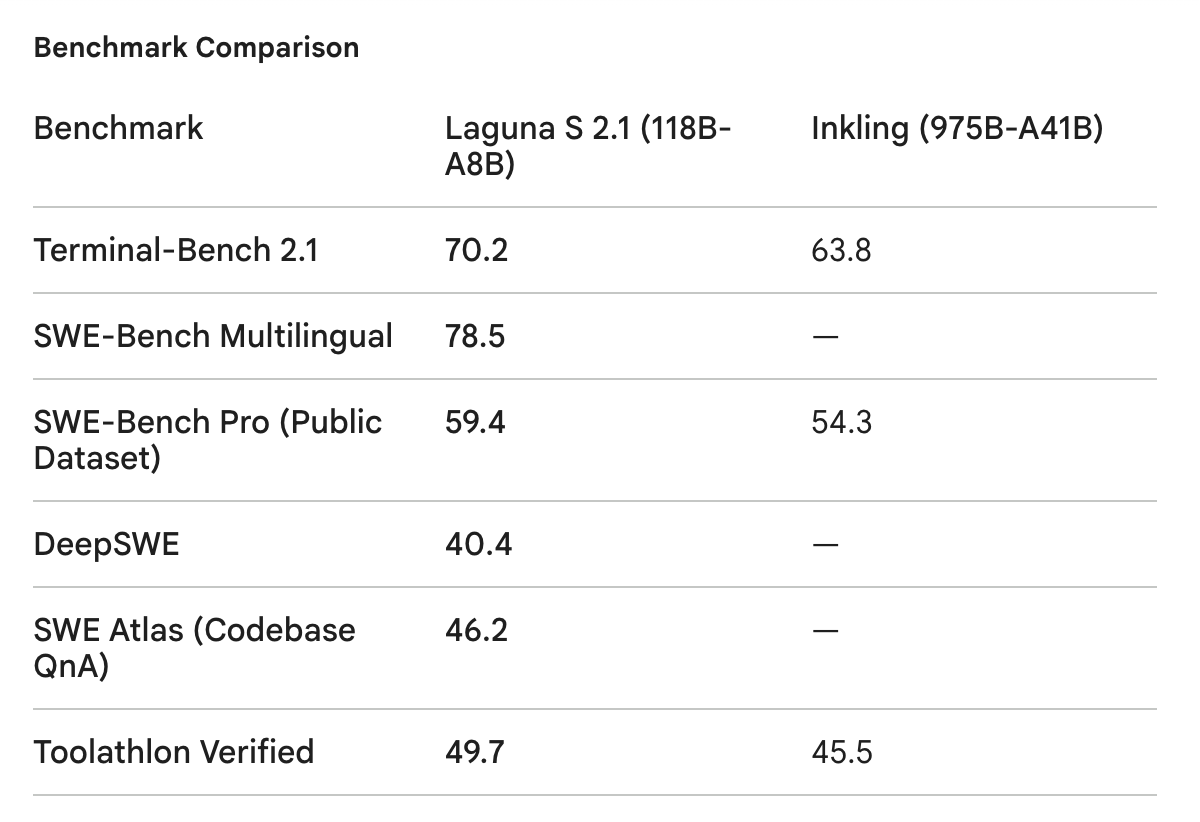
Poolside AI通过模型工厂技术实现高效训练,其Laguna S 2.1模型以118B参数规模超越竞品,揭示AGI研发路径与工程实践细节。
入选理由:模型工厂支持每月10,000–20,000次实验,实现8周内完成模型从预训练到发布的全流程
精选文章#AI模型#模型工厂#AGI#Poolside AI中英混合
概念
也叫:MoE
一种模型架构方法
最近变化
2026-10-09 · MoE架构可能在60GB内存硬件上实现比12 tokens/秒更快的交互速度
Mixture-of-Experts 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
已收录 6 篇与「Mixture-of-Experts」相关的 AI 资讯和分析。
Poolside AI通过模型工厂技术实现高效训练,其Laguna S 2.1模型以118B参数规模超越竞品,揭示AGI研发路径与工程实践细节。
入选理由:模型工厂支持每月10,000–20,000次实验,实现8周内完成模型从预训练到发布的全流程
Cohere 发布 North Mini Code,一个 30B 参数的 Mixture-of-Experts 模型,专为开发者设计,在多个代码生成基准测试中表现优异。
入选理由:North Mini Code 是 Cohere 首个专为开发者设计的模型,参数量为 30B,其中 3B 为活跃参数。
Nemotron 3 Ultra是NVIDIA推出的开源AI模型,基于SSM和Mixture of Experts混合架构,推理速度比现有最佳开源模型快5倍,运行成本降低30%。
入选理由:Nemotron 3 Ultra采用SSM与Mixture of Experts混合架构,推理速度比现有最佳开源模型快5倍。
异构智能是未来AI发展的关键范式,通过融合不同架构、规模和硬件的模型协同工作,提升复杂问题解决效率。
入选理由:当前AI发展正从同质化向异构化演进,如Mixture of Experts和多代理系统已初现端倪。
目前没有明确的最佳开源MoE LLM推荐,但MoE架构可能在60GB内存下提升编码速度。
入选理由:MoE架构可能在60GB内存硬件上实现比12 tokens/秒更快的交互速度
推文内容信息密度不足,未提供技术细节或工程实践指导。
入选理由:推文内容信息密度不足,未提供技术细节或工程实践指导
与「Mixture-of-Experts」经常一起出现的 AI 术语。
💡 想追踪「Mixture-of-Experts」的长期趋势?去 实体雷达 · Mixture-of-Experts 查看详细分析和跨材料问答。

