T
traeai
登录

概念

什么是 Kubernetes?

也叫:K8s

容器编排系统

为什么现在值得关注?

最近变化

2026-10-22 · ACE通过硬件隔离的microVM实现容器级性能与安全隔离

Kubernetes 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。

📰 Kubernetes 最新动态

已收录 30 篇与「Kubernetes」相关的 AI 资讯和分析。

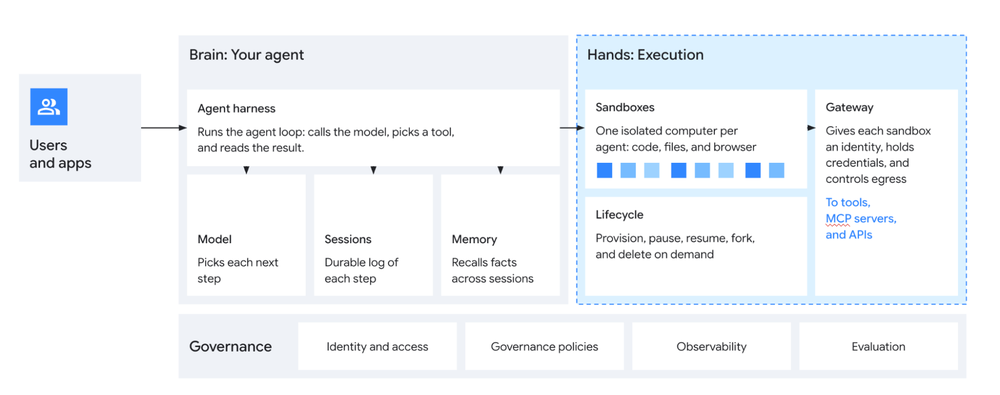
Inside Agent Compute Engine: Building the compute foundation for the agentic era

Google推出Agent Compute Engine,为每个AI代理提供硬件隔离的微虚拟机,解决agentic AI在大规模部署中的性能与安全挑战。

入选理由:ACE通过硬件隔离的microVM实现容器级性能与安全隔离

精选文章#Agent Compute Engine#AI Infrastructure#Google Cloud#agentic AI英文
Red Hat AI 图标

Crossing the threshold to dependable open source AI serving

Red Hat AI1380 字 (约 6 分钟)
85

开源AI服务已从实验阶段进入成熟基础设施,Red Hat的vLLM和llm-d项目解决了大规模集群中的模型服务挑战。

入选理由:vLLM项目已纳入PyTorch基金会并支持多硬件架构

精选文章#AI推理#开源#Kubernetes#分布式系统英文
Red Hat AI 图标

Red Hat AI 3.5通过优先级感知服务机制,在共享GPU上实现低延迟处理,95%的高优先级请求在0.5秒内响应。

入选理由:Red Hat AI 3.5的优先级队列机制使95%的高优先级请求在0.5秒内得到第一个token。

精选文章#Red Hat AI#GPU资源管理#优先级调度#Kubernetes英文
Scope workloads and share resilience policies with AWS Resilience Hub

Scope workloads and share resilience policies with AWS Resilience Hub

AWS Architecture Blog2987 字 (约 12 分钟)
85

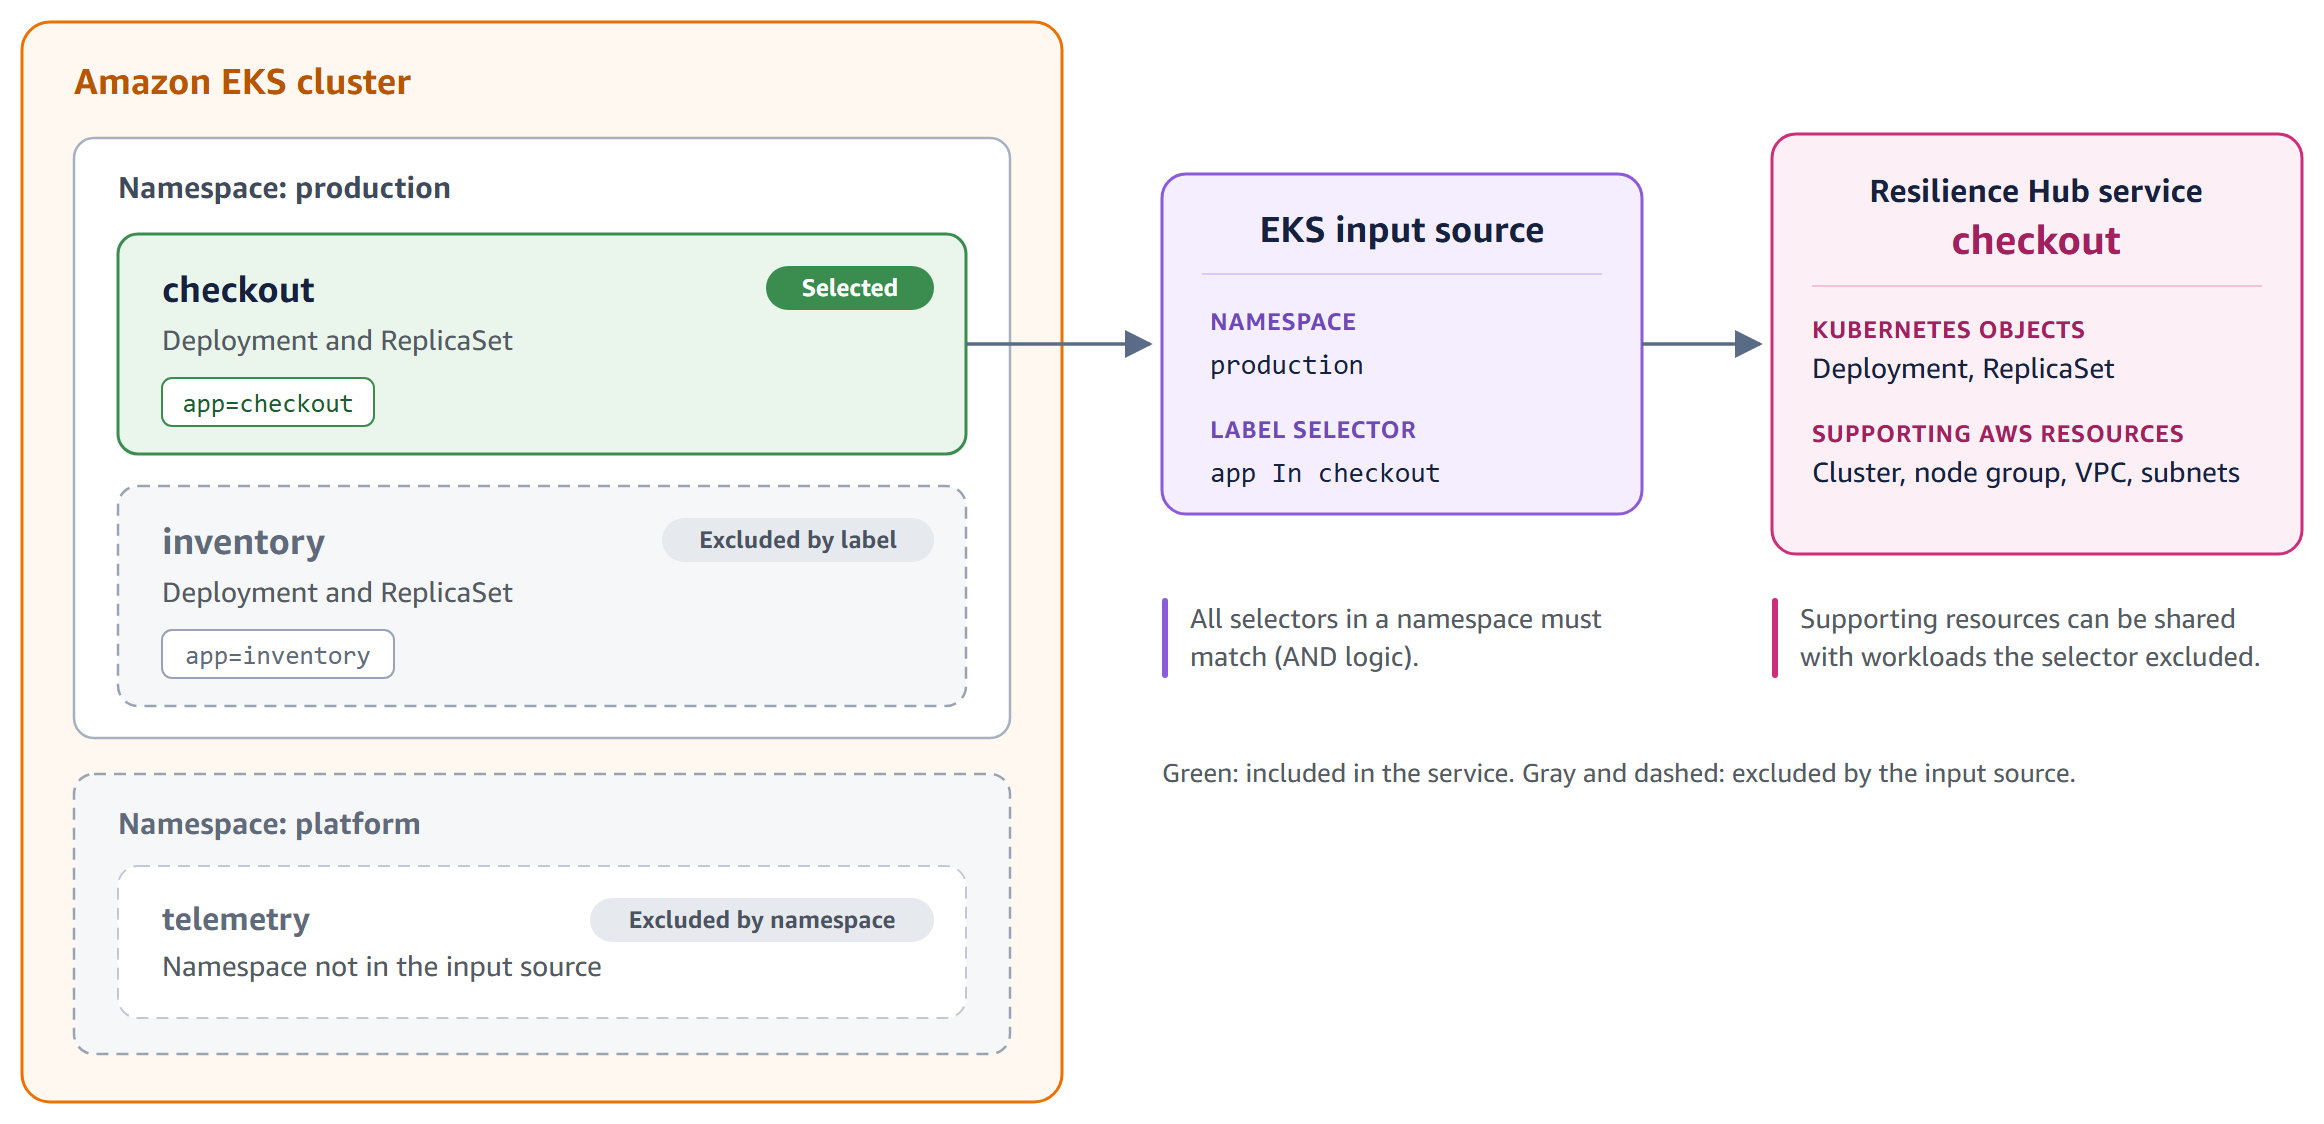
AWS Resilience Hub新增Kubernetes标签支持、AI依赖分析和跨账户策略共享功能,提升云环境韧性管理效率。

入选理由:使用Kubernetes标签精准定义服务资源边界

精选文章#AWS#云原生#韧性管理#Kubernetes#生成式AI英文
Production Patterns for Agents, Evals, and LLM Costs: QCon AI New York 2026

生产环境中的AI代理需平衡权限控制、评估机制与成本,InfoQ 2026年QCon会议揭示了授权模型、评估循环和提示压缩等实践方案。

入选理由:生产代理需结合长期服务账户与细粒度权限控制,避免过度授权或限制

精选文章#AI生产实践#LLM成本控制#授权模型#评估系统英文
PyTorch Blog 图标

A Ray-Focused Guide to PyTorch Conference North America

PyTorch Blog1573 字 (约 7 分钟)
85

Ray框架成为AI基础设施标准,与Kubernetes整合构建统一AI栈,LinkedIn展示三层PyTorch训练架构。

入选理由:Ray与Kubernetes协同进化是AI基础设施核心趋势

精选文章#PyTorch#Ray#Kubernetes#分布式计算#AI基础设施英文
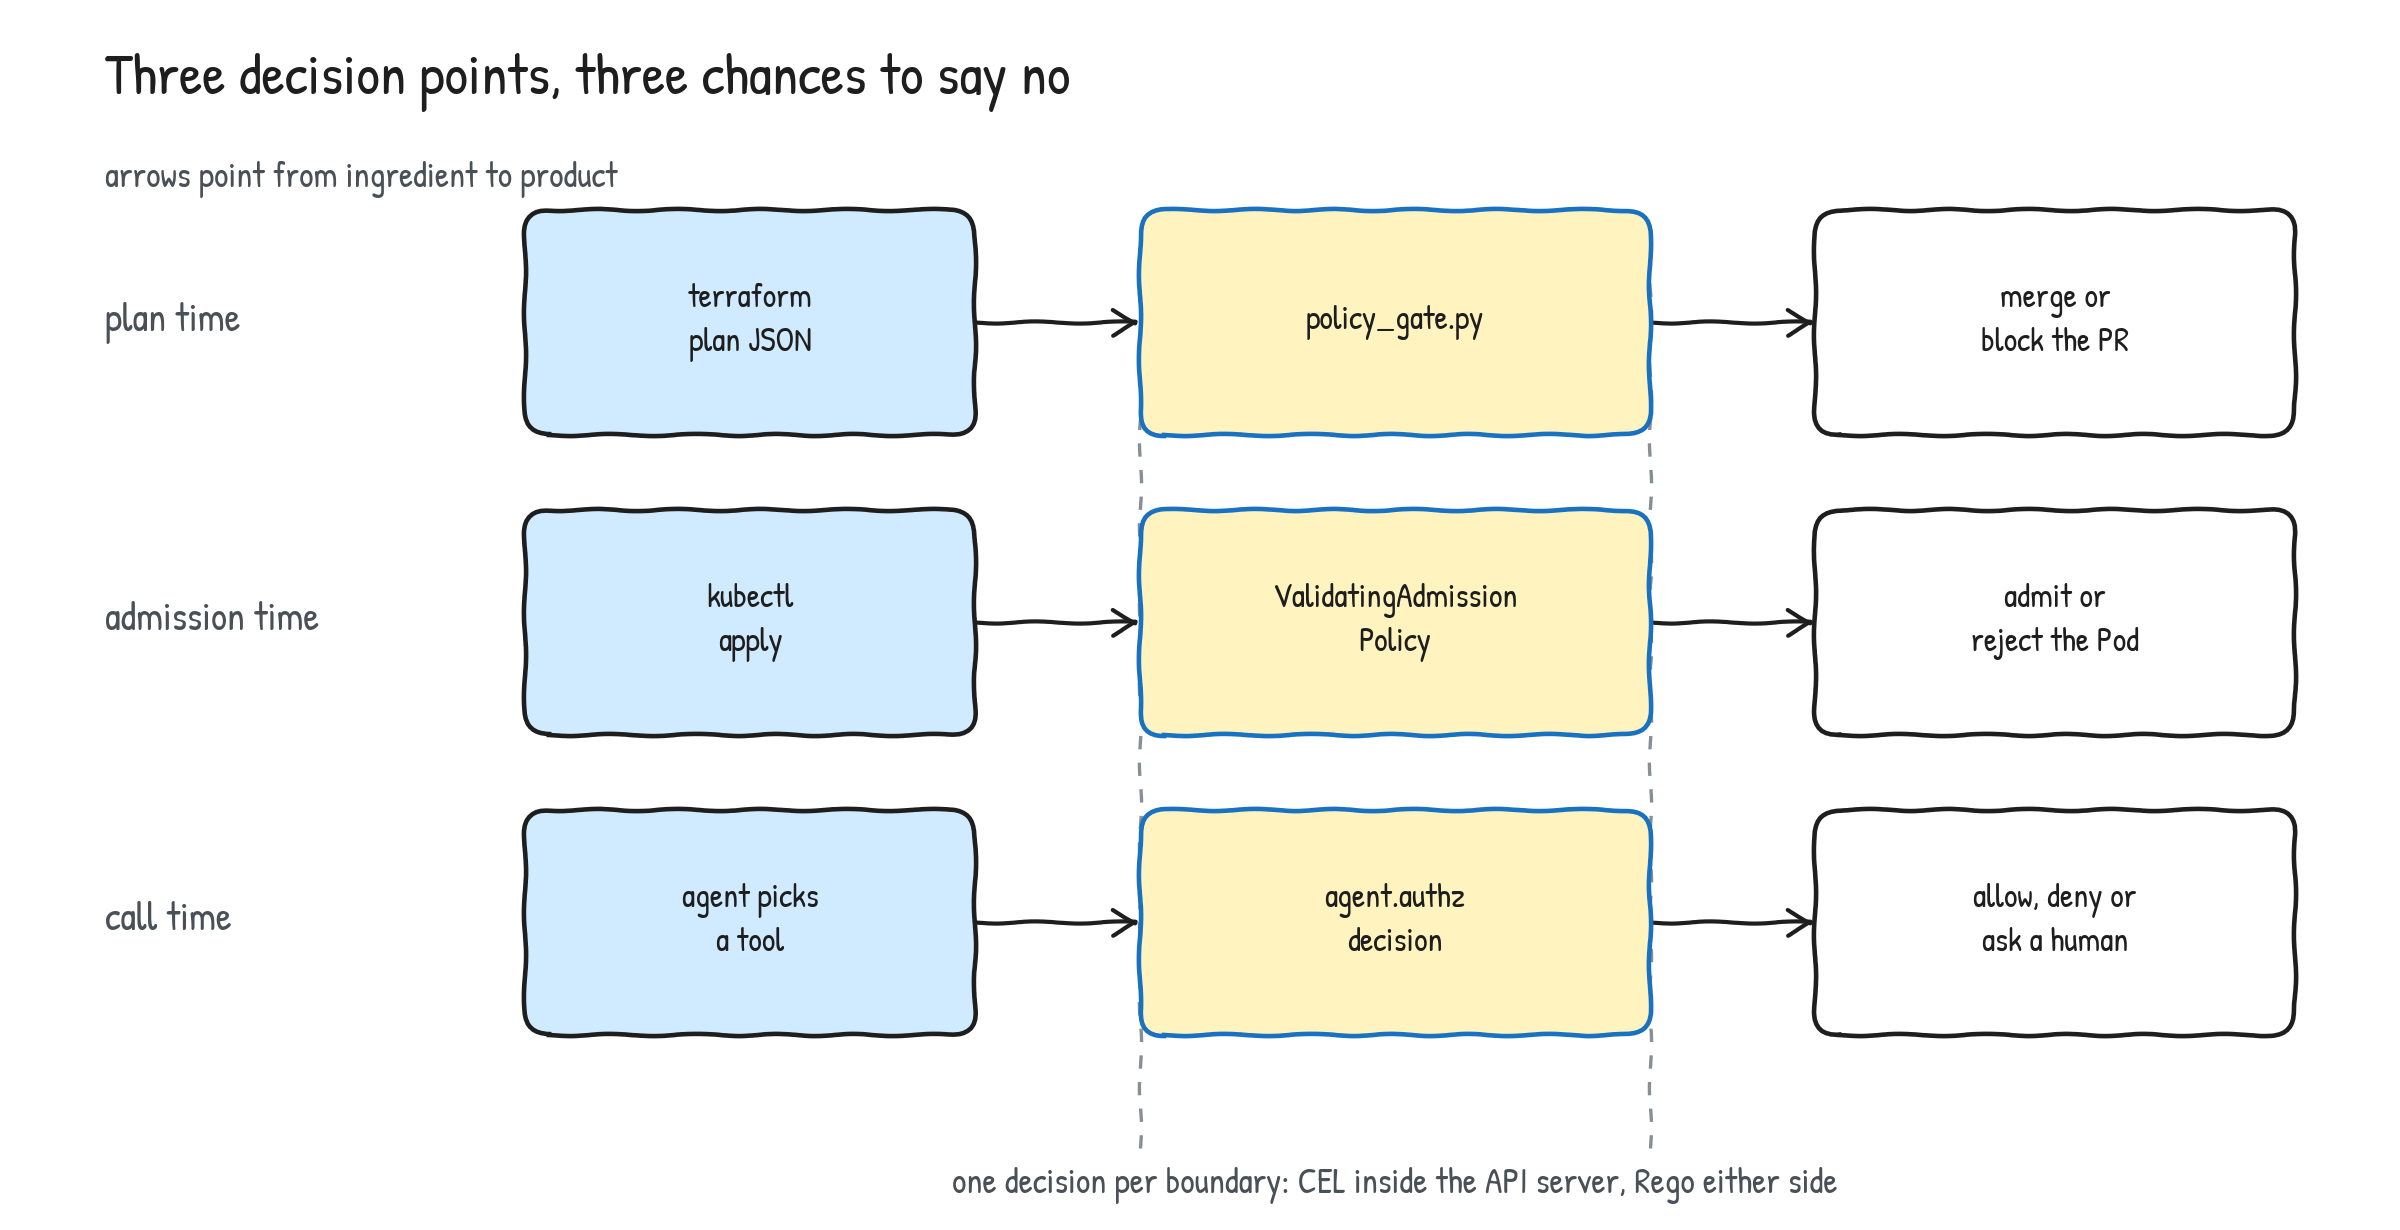
How to Govern AI-Generated Infrastructure with Policy as Code and OPA [Full Handbook]

AI生成的基础设施代码存在44%安全漏洞,需用Policy as Code和OPA实现自动化治理,包含Veracode等权威机构的实证数据。

入选理由:AI生成代码安全通过率仅56%,44%存在风险漏洞

精选文章#Policy as Code#OPA#AI生成代码#基础设施安全英文
Kubernetes Multi-Cluster Project Karmada Reaches CNCF Graduation

Karmada成为首个CNCF毕业的多集群Kubernetes项目,支持AI训练任务调度和跨云资源管理。

入选理由:Karmada v1.19版本实现AI训练任务的多组件调度增强

精选文章#Kubernetes#CNCF#多集群#Karmada#云原生英文
Together AI Blog 图标

Introducing preemptible compute: the same compute, half the price

Together AI Blog905 字 (约 4 分钟)
85

Together AI推出预占式计算,以一半价格提供相同GPU资源,适用于中断容忍型任务。

入选理由:预占式节点按50%按需价格计费且支持亚小时计费

精选文章#Kubernetes#GPU计算#成本优化#云服务英文
Red Hat AI 图标

Red Hat与Rafay联合发布的主权AI云参考架构,为电信运营商提供标准化、自助服务的GPU云解决方案,解决平台和商业化双重挑战。

入选理由:Red Hat平台解决多站点GPU环境标准化部署难题,降低70%运维复杂度

精选文章#AI云架构#Red Hat#Rafay#GPU云服务#主权云英文
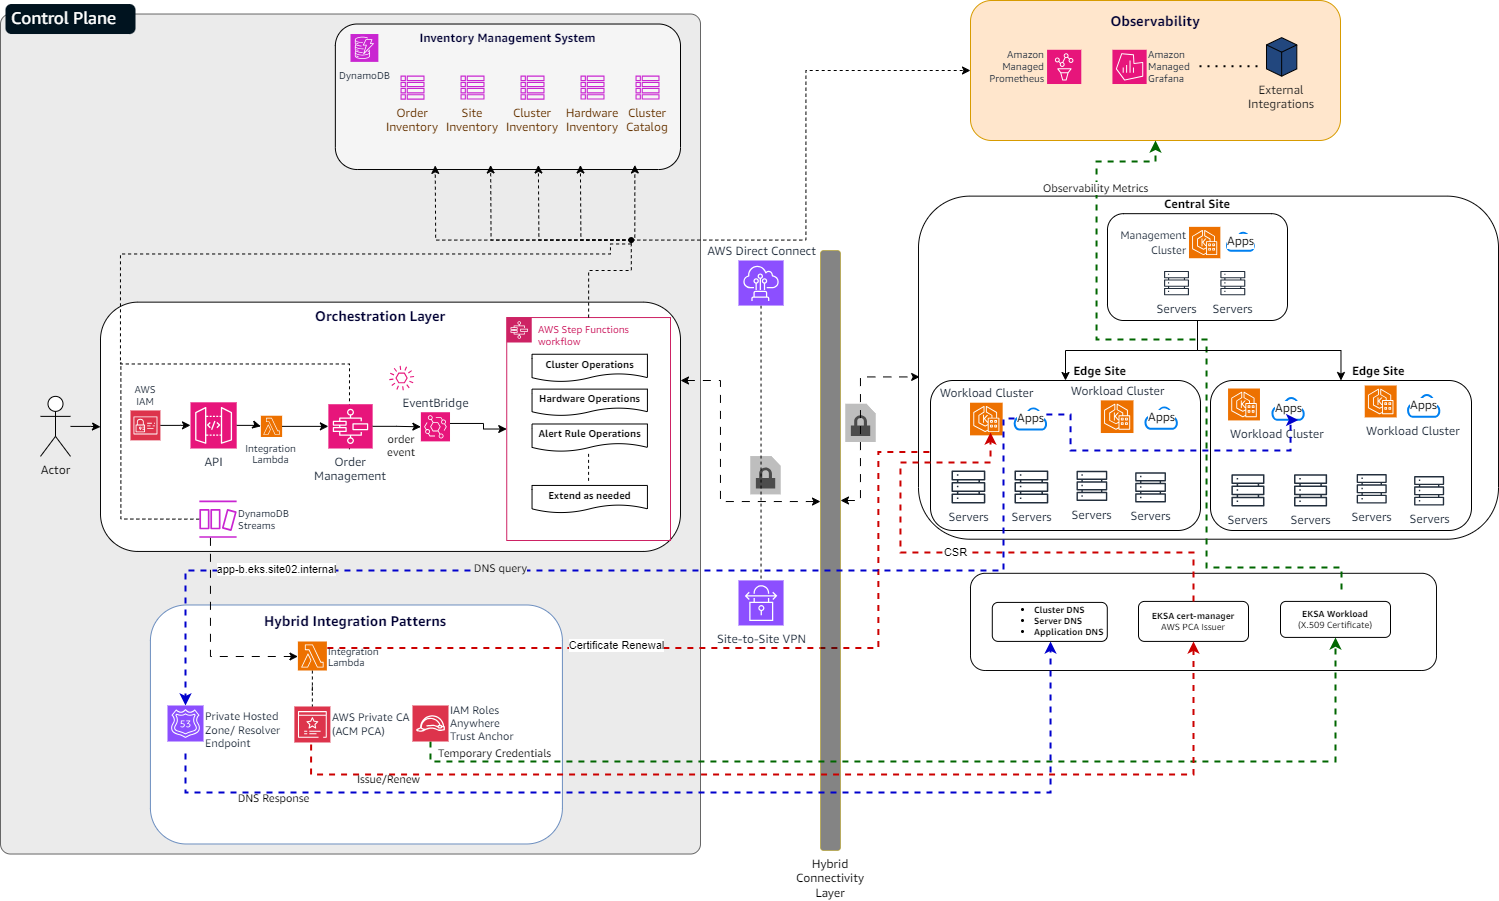
Hybrid cloud orchestration: Modernizing on-premises infrastructure management with AWS

Hybrid cloud orchestration: Modernizing on-premises infrastructure management with AWS

AWS Architecture Blog3019 字 (约 13 分钟)
85

AWS展示了如何利用无服务器技术构建混合云编排解决方案,实现大规模本地基础设施的集中管理。

入选理由:使用AWS Lambda+Step Functions+DynamoDB构建事件驱动的编排引擎

精选文章#Hybrid Cloud#AWS#Kubernetes#Serverless#Infrastructure Management英文
Grafana Labs 图标

Grafana Cloud推出监控质量报告,通过自动化评估服务的遥测数据完整性,提升全栈可观测性。

入选理由:使用Grafana Cloud的Knowledge Graph仪表板可实时评估服务监控质量得分

精选文章#Observability#Grafana#Monitoring#Kubernetes英文
Red Hat AI 图标

Beyond the model: Architecting production-grade enterprise AI systems

Red Hat AI2014 字 (约 9 分钟)
85

企业级AI系统需构建包含计算、存储、服务和集成的四层架构,自托管与托管模式各有权衡。

入选理由:企业AI系统依赖四层基础设施:计算、模型存储、服务层和系统集成

精选文章#AI架构#企业系统#模型部署#Kubernetes英文
Open Source Is Not a Virtue: It’s an Ownership Model

Open Source Is Not a Virtue: It’s an Ownership Model

Mozilla AI Blog1030 字 (约 5 分钟)
85

开源是防止供应商锁定的运营策略,强调基础设施代码所有权对架构主权的决定性作用,AI模型临时性与控制平面战略价值成为核心议题。

入选理由:开源本质是基础设施层的所有权控制策略,非单纯道德选择

精选文章#开源#架构设计#AI#所有权模型#供应商锁定英文
Amazon Science 图标

Developing provably correct Rust code with Verus

Amazon Science1889 字 (约 8 分钟)
85

Verus通过形式化验证确保Rust代码的正确性,提升软件安全性。该工具可验证Rust unsafe代码和并发逻辑,已被Amazon和Kubernetes等项目采用。

入选理由:Verus支持Rust unsafe代码块的数学验证,确保性能关键模块安全

精选文章#Rust#形式化验证#软件安全#Verus#自动化验证英文
Elastic Blog 图标

What's new in ECK 3.5

Elastic Blog2067 字 (约 9 分钟)
85

ECK 3.5 引入动态命名空间管理、暂停编排和全栈 mTLS,提升 Kubernetes 上 Elasticsearch 的灵活性和安全性。

入选理由:动态命名空间通过 Kubernetes 标签选择器实现零重启管理

精选文章#ECK#Kubernetes#Elasticsearch#mTLS#动态命名空间英文
How to Build Kubernetes Operators: A Handbook for Devs

How to Build Kubernetes Operators: A Handbook for Devs

freeCodeCamp.org6195 字 (约 25 分钟)
85

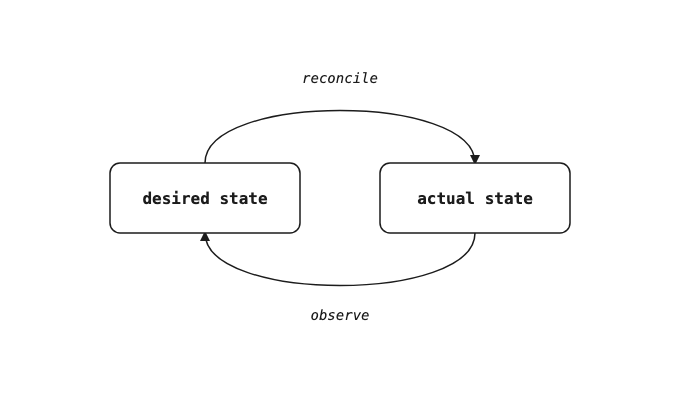
Kubernetes Operator通过声明式循环管理自定义资源,实现对非原生系统的自动化运维,构建过程需定义CRD并实现重同步逻辑。

入选理由:Operator通过持续对比期望状态与实际状态实现自动化运维

精选文章#Kubernetes#Operator#云原生#DevOps英文
Cloud Native Infrastructure Emerges as the Foundation for Trustworthy Agentic AI

云原生基础设施已成为可信代理AI的基石,Kubernetes等技术可支撑多代理系统的可观测性与弹性。

入选理由:Kubernetes提供自主AI系统所需的弹性与编排能力

精选文章#云原生#Kubernetes#AI架构#可观测性英文
KDnuggets 图标

The Roadmap to Becoming an AI Architect in 2026

KDnuggets2258 字 (约 10 分钟)
85

成为AI架构师需要掌握系统设计、技术选型、成本控制和治理能力,2026年对这类人才需求激增。

入选理由:AI架构师需具备技术广度而非深度,能评估LLM功能的可行性与成本。

精选文章#AI#架构设计#数据工程#MLOps#技术选型英文
Google OpenRL is an Experimental Self-hosted API for LLM Post-Training Fine-tuning

Google 推出 OpenRL,一个用于 LLM 微调的自托管 API,旨在简化强化学习流程并提升 GPU 利用率。

入选理由:OpenRL 允许在 Kubernetes 集群上运行多个 RL 任务,提升 GPU 利用率。

精选文章#Kubernetes#LLM#强化学习#AI#Google英文
Towards Data Science 图标

GPU Time-Slicing for Concurrent LLM Agents on Kubernetes

Towards Data Science4627 字 (约 19 分钟)
85

在 Kubernetes 上共享 GPU 会导致尾部延迟显著增加,尤其对低延迟任务影响更大,但调度器不会报告这些问题。

入选理由:共享 GPU 时,Kubernetes 会报告所有 Pod 为 Running,但尾部延迟可能增加 66%。

精选文章#Kubernetes#GPU#LLM#调度器#延迟优化英文
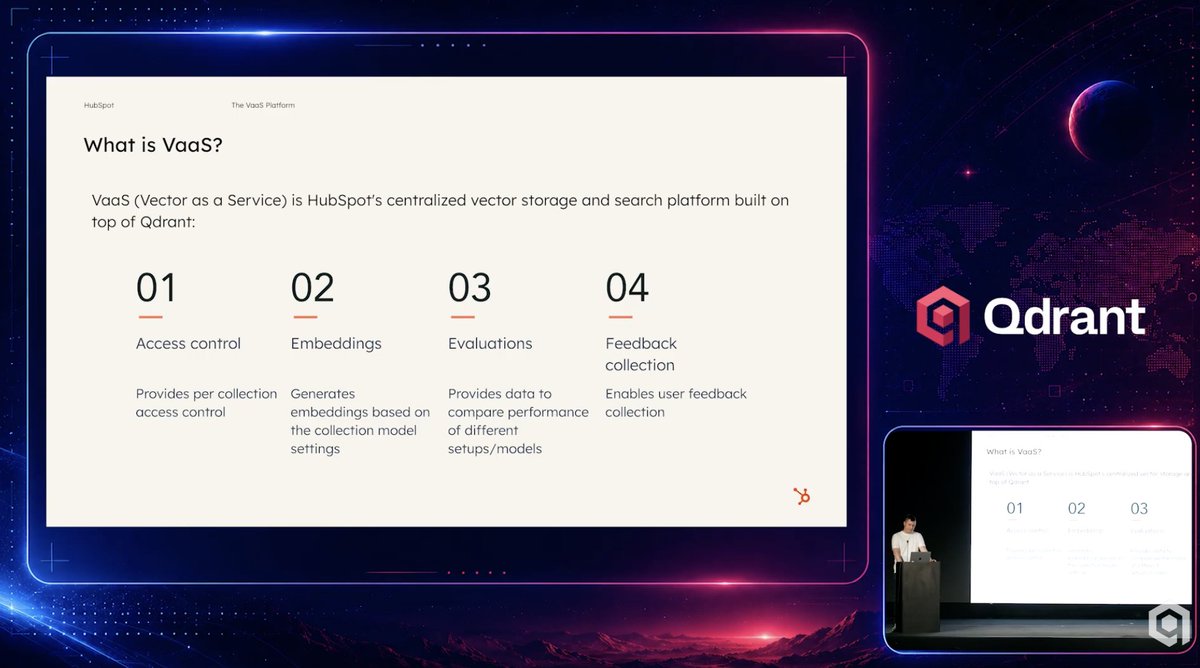
Building and Scaling a Platform with Project-as-a-Service

Building and Scaling a Platform with Project-as-a-Service

InfoQ1178 字 (约 5 分钟)
85

平台通过Project-as-a-Service实现自动化和标准化,提升团队效率与一致性。

入选理由:使用Project-as-a-Service可通过单个YAML文件快速创建环境。

精选文章#Kubernetes#DevOps#平台架构#自动化英文

与「Kubernetes」经常一起出现的 AI 术语。

💡 想追踪「Kubernetes」的长期趋势?去 实体雷达 · Kubernetes 查看详细分析和跨材料问答。

AI 可能会生成不准确的信息,请核实重要内容