前沿模型是强大的顾问
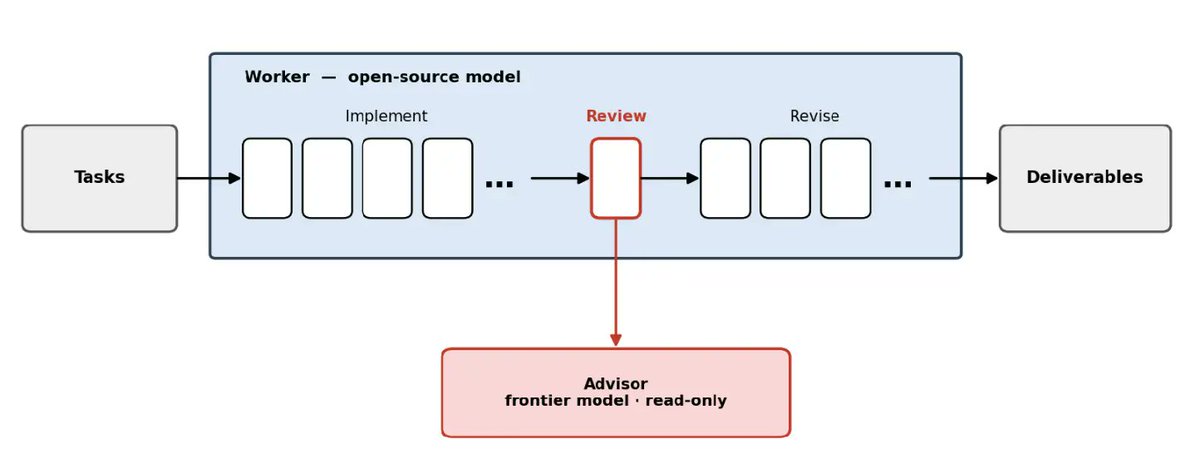
Fireworks AI 通过“harness + advisor”架构,在 Harvey 法务代理基准上以 Claude Opus 4.7 为稀疏顾问,将 GLM 5.1 工作者性能提升至 18/100 全对,成本仅为 Opus 的 39%。
入选理由:在 Harvey 法务代理基准上,GLM 5.1 + Claude Opus 4.7 稀疏顾问方案全对数达 18/100。
公司
也叫:Fireworks
提供AI模型服务的公司,发生2026年10月安全事件
最近变化
2026-10-10 · 2026年10月6日发现凭证泄露,10月9日完成API密钥轮换
Fireworks AI 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
Frontier models are powerful advisors. On @harvey's Legal Agent Benchmark, a GLM 5.1 worker using C...
Fireworks AI(@FireworksAI_HQ) · 8.7 分
https://t.co/oUF0pfafrU
Fireworks AI(@FireworksAI_HQ) · 8.5 分
Turns out you don't need a frontier lab budget to build a solid decision classifier. Our Head of A...
Fireworks AI(@FireworksAI_HQ) · 8.5 分
已收录 30 篇与「Fireworks AI」相关的 AI 资讯和分析。
Fireworks AI 通过“harness + advisor”架构,在 Harvey 法务代理基准上以 Claude Opus 4.7 为稀疏顾问,将 GLM 5.1 工作者性能提升至 18/100 全对,成本仅为 Opus 的 39%。
入选理由:在 Harvey 法务代理基准上,GLM 5.1 + Claude Opus 4.7 稀疏顾问方案全对数达 18/100。
Fireworks AI 2026 年 10 月安全事件影响部分客户账户,未涉及数据泄露,已采取措施并通知客户。
入选理由:2026年10月6日发现凭证泄露,10月9日完成API密钥轮换
无需高额预算即可训练出高性能决策分类器,Fireworks AI通过SFT和公开数据集实现,代码开源。
入选理由:使用SFT和公开数据集可训练9B参数Jev风格分类器
Fireworks AI发布SWE-2模型,在保持前沿性能的同时将成本降低70%。
入选理由:SWE-2模型在主流评估中达到前沿水平,成本降低70%
DeepSeek V4.1-Flash在DeepSWE基准测试中以1/15的成本实现与GPT-6 Astra相当的性能,输入token占比达174:1且缓存命中率高达99.6%。
入选理由:输入token数量是输出的174倍,占成本计算的60%。
FactoryAI通过微调Qwen模型,使Droid Shield在代码审查中比GPT-5.5多捕捉20%的真实秘密,同时降低成本和延迟。
入选理由:使用Training API微调Qwen模型可提升20%的敏感信息检测率
Fireworks AI通过微调Qwen模型帮助LangChain实现评估成本降低100倍,替代GPT-5.5等闭源模型。
入选理由:微调Qwen模型可替代GPT-5.5实现100倍成本降低
Fireworks AI 现已支持 DeepSeek V4 Flash 0731 模型的微调训练,提供 SFT/DPO/RL 三种训练方式,适用于编码代理和高并发场景,成本较传统方案降低 70%。
入选理由:DeepSeek V4 Flash 0731 可通过 Fireworks API 进行 SFT/DPO/RL 训练
模型成本评估应关注任务完成成本而非每token价格,2400次测试表明按任务难度路由可同时优化成本与覆盖范围。
入选理由:2400次基准测试覆盖10个模型,包括Kimi K3
Fireworks AI与ClayRunHQ合作推动开放权重模型在GTM领域的落地,GLM-5.2和Kimi K2.6展现关键性能。
入选理由:GLM-5.2和Kimi K2.6模型已具备实际GTM工作所需的性能
模型管理是SDLC扩展的真正瓶颈,Fireworks AI帮助FactoryAI实现模型管理效率提升。
入选理由:使用Fireworks AI可使开源模型增长达2-3倍
Fireworks AI 现在支持对 GLM 5.2 进行微调,适用于代码生成任务,提升模型在特定代码库中的表现。
入选理由:Fireworks AI 支持对 GLM 5.2 进行 SFT、DPO 和 RL 微调。
Fireworks AI 已解决前沿模型强化学习中的基础设施难题,实现训练与推理数值完全一致,并作为服务推出。
入选理由:Fireworks AI 解决了训练与推理数值一致性的难题,实现零 KLD。
结合前沿封闭模型与开源模型可显著提升性能并降低成本,Fireworks AI 的研究验证了这一结论。
入选理由:结合封闭模型与开源模型可提升性能并降低 40-67% 的成本。
GLM 5.2 在性能和效率上表现优异,接近甚至超越 GPT 5.5 和 Opus 4.8。
入选理由:GLM 5.2 在处理长上下文和复杂任务时表现出色。
Fireworks AI 已上线 GLM 5.2 模型,支持 1M-token 上下文,专注于代码生成,并在多个基准测试中表现优异。
入选理由:GLM 5.2 支持 1M-token 上下文,适用于复杂任务。
Fireworks AI 现在支持 Kimi 2.7 的完全可训练,提供低成本构建竞争模型的方案。
入选理由:Kimi 2.7 可通过 Fireworks AI 进行 SFT、DPO 和 RL 训练。
Fireworks AI 提出通过缩短推理长度降低上下文开销,提升生成效率并减少成本。
入选理由:缩短推理长度可减少后续上下文开销,提升生成速度。
Moonshot 推出 K2.7 Code 模型,推理 token 数减少 30%,同时在 Moonshot 编码基准中表现更优。
入选理由:K2.7 Code 模型推理 token 数比 K2.6 减少 30%。
Step 3.7 Flash 是一个专为推理优化设计的 196B MoE 模型,采用 MFA 和 AFD 技术,KV-cache 占用仅为 DeepSeek 的 22%,支持高效代理、编码和多模态任务,已开源并可在 Fireworks 平台使用。
入选理由:Step 3.7 Flash 是 196B MoE 模型,从设计之初就聚焦推理效率,而非事后优化。
开放权重模型在实际应用中表现出显著成本优势,RampLabs 使用 Kimi K2.6 和 DeepSeek V4 Pro 发现高危漏洞,成本降低 5 倍。
入选理由:RampLabs 使用 10K 代理测试后端,发现开放权重模型成本降低 5 倍。
Fireworks AI 提供了一种观点,即产品的成功在于其作为强化学习环境的独特性和适应性。
入选理由:产品的独特性是其最大的护城河。
Fireworks AI测试显示,基线模型在浏览器代理任务中重试率达20%,而Kimi K2.5、GLM-5、MiniMax M2.5的重试率接近零,执行差异直接影响生产系统的成本、延迟和可靠性。
入选理由:基线模型在5次调用中约1次输出畸形,导致多步骤工作流重试
Fireworks AI指出,模型微调现在只需CLI命令、10分钟GPU时间和几美分,且可完全拥有权重,预训练模型虽已足够使用,但需进一步优化。
入选理由:模型微调时间从数周团队协作缩短到10分钟GPU计算,成本仅需几美分
微调瓶颈不在算法本身,而在于集成复杂度、迭代周期长和模型类型选择不清。Fireworks AI 提供VPC内训练与高频实验支持。
入选理由:团队瓶颈不在训练算法,而在数据隔离、迭代速度和模型选择(SFT/RFT/DPO)
Fireworks AI 引入 Step 3.7 Flash:从推理效率出发设计的 198B 稀疏 MoE 视觉语言模型,集成 196B 语言与 1.8B 视觉编码器,实现实际代理任务最高 400 token/s 推理。
入选理由:从设计阶段即优化推理效率,非事后补强。
对开源模型进行路由与后训练能显著提升AI系统的准确性、速度和成本效益。Harvey与Fireworks AI的实测表明,采用GLM 5.1作为主Worker并选择性调用前沿模型的混合架构,在法律领域实现了质量与成本的双重优化,证明开源微调加智能路由是替代纯前沿模型的高性价比工程路径。
入选理由:Harvey实测显示混合法律Agent在质量和成本上均优于单一前沿模型。
微调专有数据是构建AI护城河的最高杠杆策略,提示词易被复制,而基于私有数据训练的模型难以被替代。OpenAI正逐步限制该路径,企业应尽快掌握SFT能力。
入选理由:使用专有数据进行SFT微调可建立竞争壁垒,防止提示工程被快速复制。
Fireworks AI推出DeepSeek V4 Flash原生视觉模型,价格与文本版本相同但性能更优。
入选理由:DeepSeek V4 Flash新增原生视觉功能,支持多模态处理
Fireworks AI团队使用GLM5.2 Fast模型在4天内完成原本预计1个月的工程任务,速度达400 tokens/秒,成本218美元。
入选理由:GLM5.2 Fast模型实现400 tokens/秒的处理速度,显著提升工程效率。
与「Fireworks AI」经常一起出现的 AI 术语。
💡 想追踪「Fireworks AI」的长期趋势?去 实体雷达 · Fireworks AI 查看详细分析和跨材料问答。