实测Gemini 4 Argon:知识工作强劲但体验糟糕,卡兹克称难撼Claude Opus 5.5与GPT-6 Astra
AI HOT 精选83 字 (约 1 分钟)
85
Gemini 4 Argon在知识任务表现强劲,但中文写作体验差,不建议购买Ultra版本。
入选理由:Gemini 4 Argon在Vals Index得分68.9,但CUA-bench拒绝率4.83%。
精选文章#Gemini 4 Argon#Claude Opus 5.5#GPT-6 Astra#AI模型对比中文
概念
也叫:CUA
AI模型拒绝率测试基准,用于评估对话能力。
最近变化
2026-10-13 · Gemini 4 Argon在Vals Index得分68.9,但CUA-bench拒绝率4.83%。
CUA-bench 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
已收录 2 篇与「CUA-bench」相关的 AI 资讯和分析。
Gemini 4 Argon在知识任务表现强劲,但中文写作体验差,不建议购买Ultra版本。
入选理由:Gemini 4 Argon在Vals Index得分68.9,但CUA-bench拒绝率4.83%。
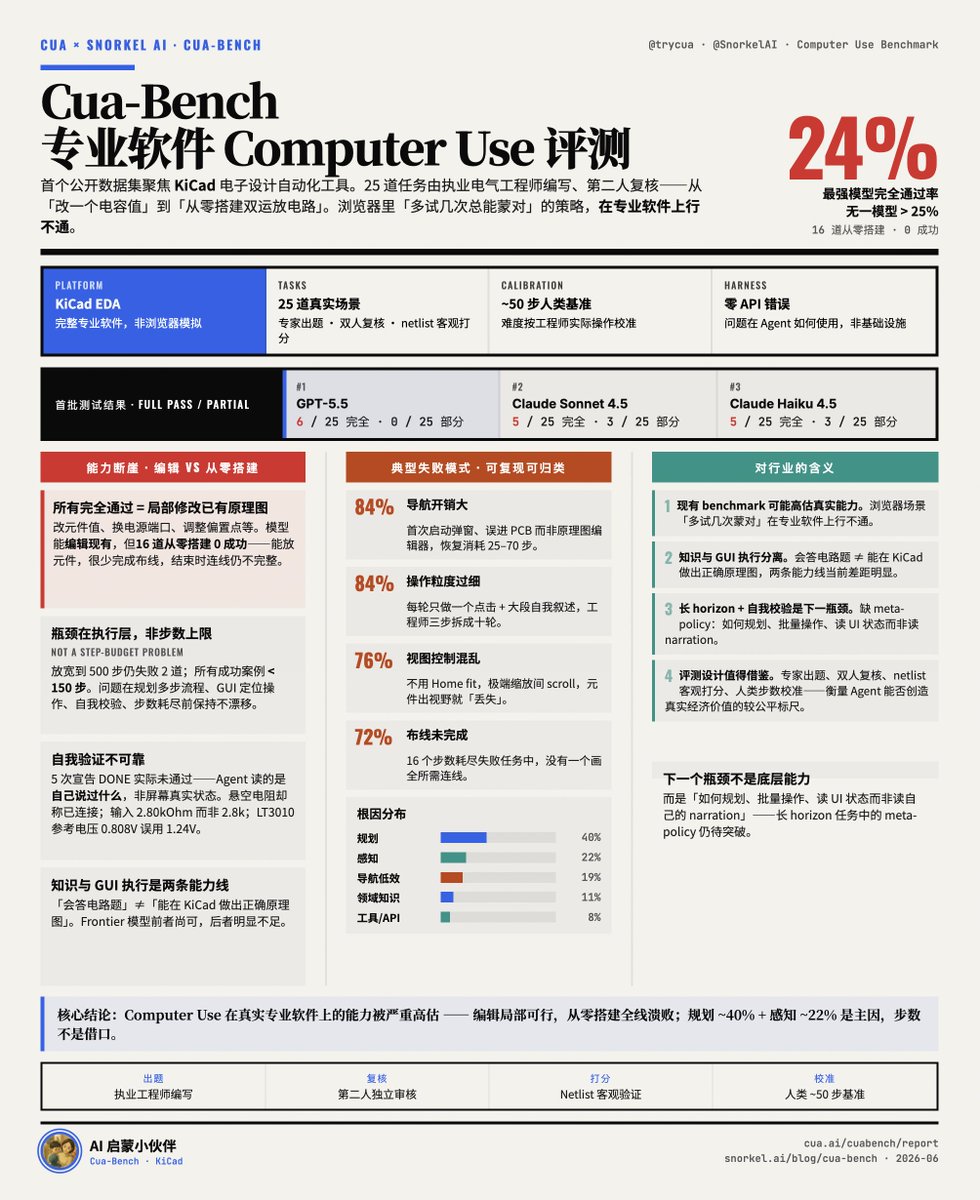
Cua-Bench 是首个评测 Agent 在专业软件上执行任务能力的基准,测试显示当前模型在复杂 GUI 操作和任务规划上存在明显短板。
入选理由:当前最强模型 GPT-5.5 在 Cua-Bench 上仅完成 6/25 任务,完全通过率仅 24%。
与「CUA-bench」经常一起出现的 AI 术语。
💡 想追踪「CUA-bench」的长期趋势?去 实体雷达 · CUA-bench 查看详细分析和跨材料问答。