3倍速搜索:基于Instructed-Retriever-1的并行测试时缩放
Databricks发布Instructed-Retriever-1模型,通过并行测试时计算将搜索延迟降低3倍、首Token时间缩至2秒,且无需牺牲检索质量。该模型统一查询生成与重排序任务,利用多枢轴分组重排和并行查询扩展实现召回率与精确度的帕累托最优,为企业级RAG系统提供低延迟高精度检索新范式。
入选理由:Instructed-Retriever-1使搜索延迟降低3倍以上,TTFT降至约2秒,无需重新配置。
模型
也叫:Claude
基准测试提升的模型版本
最近变化
2026-09-24 · 长上下文会导致AI代理遗忘早期错误,影响决策质量
Claude Sonnet 4.5 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
3x Faster Search: Parallel Test-Time Scaling with Instructed-Retriever-1
Databricks · 9.2 分
Long contexts cause AI agents to forget early mistakes. Meta AI paired primary action agents with d...
DeepLearning.AI(@DeepLearningAI) · 8.5 分
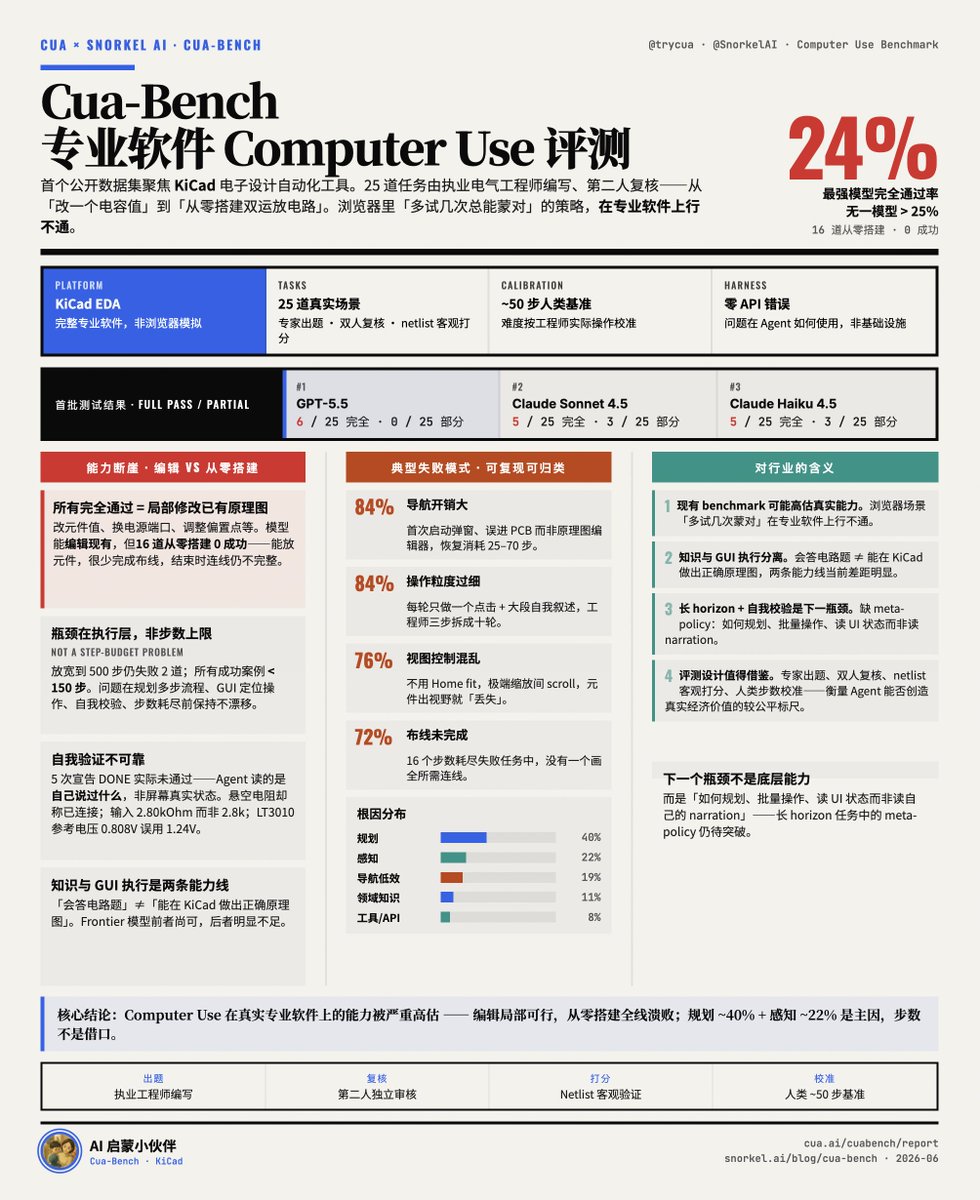
Cua 和 Snorkel AI 联合发布「Cua-Bench」:评测 Agent 在专业软件上的 Computer Use 能力 @trycua @SnorkelAI Cua-Bench 首个...
meng shao(@shao__meng) · 8.5 分
已收录 4 篇与「Claude Sonnet 4.5」相关的 AI 资讯和分析。
Databricks发布Instructed-Retriever-1模型,通过并行测试时计算将搜索延迟降低3倍、首Token时间缩至2秒,且无需牺牲检索质量。该模型统一查询生成与重排序任务,利用多枢轴分组重排和并行查询扩展实现召回率与精确度的帕累托最优,为企业级RAG系统提供低延迟高精度检索新范式。
入选理由:Instructed-Retriever-1使搜索延迟降低3倍以上,TTFT降至约2秒,无需重新配置。
Meta AI通过引入专用记忆代理解决AI代理在长上下文中遗忘早期错误的问题,提升模型性能。
入选理由:长上下文会导致AI代理遗忘早期错误,影响决策质量
Cua-Bench 是首个评测 Agent 在专业软件上执行任务能力的基准,测试显示当前模型在复杂 GUI 操作和任务规划上存在明显短板。
入选理由:当前最强模型 GPT-5.5 在 Cua-Bench 上仅完成 6/25 任务,完全通过率仅 24%。
2025年11月是LLM发展的关键转折点,三大厂商的模型性能在六个月内五次易主,编码代理实现质的飞跃达到日常可用水平,同时Warelay等新兴工具开始出现。
入选理由:2025年11月三大厂商模型性能排名变化5次,Claude Opus 4.5最终胜出
与「Claude Sonnet 4.5」经常一起出现的 AI 术语。
💡 想追踪「Claude Sonnet 4.5」的长期趋势?去 实体雷达 · Claude Sonnet 4.5 查看详细分析和跨材料问答。