多向量检索策略选型:分离度决定nDCG@10成败
多向量检索中近似策略选择错误会导致nDCG@10下降6倍,影响远超模型升级收益。应通过计算Token向量MaxSim标准差判断嵌入空间分离度:高分散选TokenANN/MUVERA,低分散选LEMUR,避免盲目调优。
入选理由:同模型数据集下,错误近似策略使nDCG@10从0.701跌至0.109,损失超模型升级收益
模型
也叫:Jina-ColBERT-v2
基于检索增强的搜索模型。
最近变化
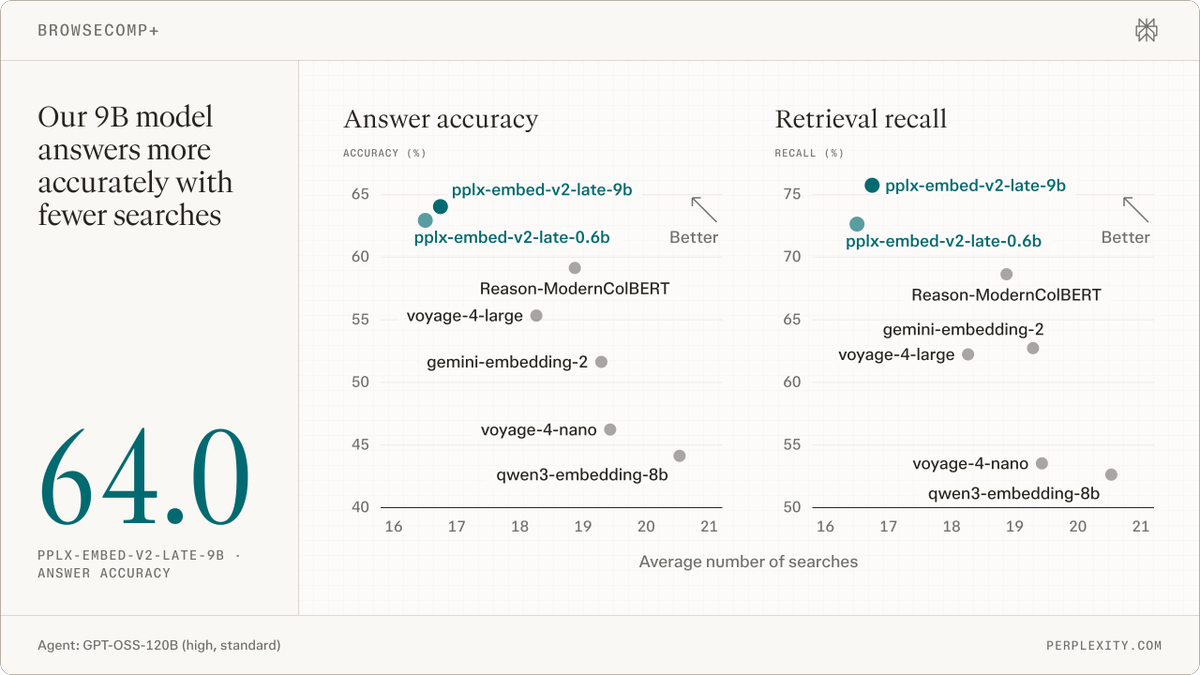
2026-10-07 · GPT-OSS-120B代理在BrowseComp+数据集上达到64.0%正确率
ColBERT 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
With the same multi-vector model, and the same dataset, nDCG@10 can drop from 0.701 to 0.109 — rough...
Milvus(@milvusio) · 9.2 分
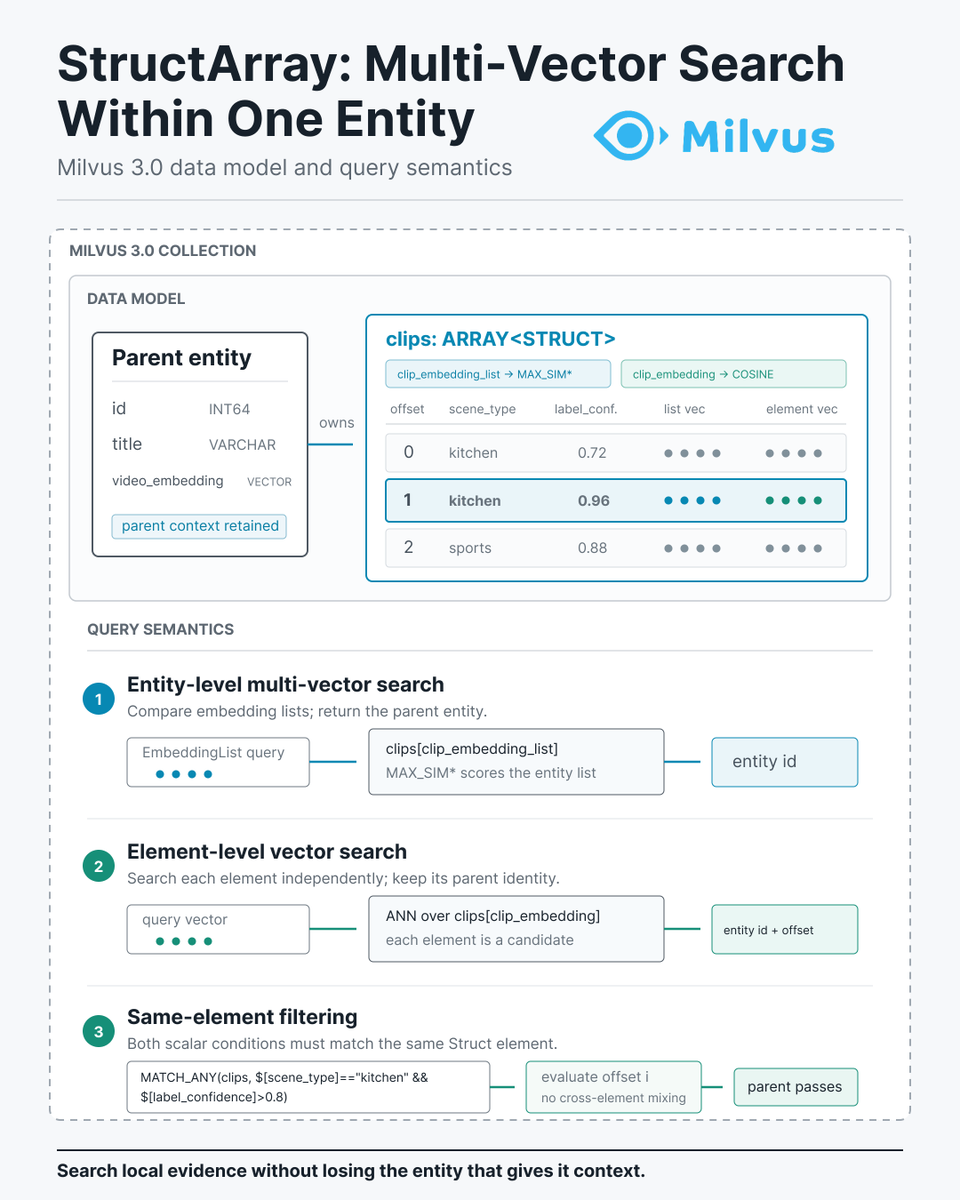
Milvus 3.0 StructArray brings multi-vector search inside a single entity. A video can keep all its ...
Milvus(@milvusio) · 8.5 分
Training and Finetuning Multi-Vector Embedding Models with Sentence Transformers
Hugging Face Blog · 8.5 分
已收录 8 篇与「ColBERT」相关的 AI 资讯和分析。
多向量检索中近似策略选择错误会导致nDCG@10下降6倍,影响远超模型升级收益。应通过计算Token向量MaxSim标准差判断嵌入空间分离度:高分散选TokenANN/MUVERA,低分散选LEMUR,避免盲目调优。
入选理由:同模型数据集下,错误近似策略使nDCG@10从0.701跌至0.109,损失超模型升级收益
Sentence Transformers v6.0新增MultiVectorEncoder模型,通过微调可超越通用检索模型。
入选理由:MultiVectorEncoder模型使用MaxSim算子实现token级匹配,提升检索精度
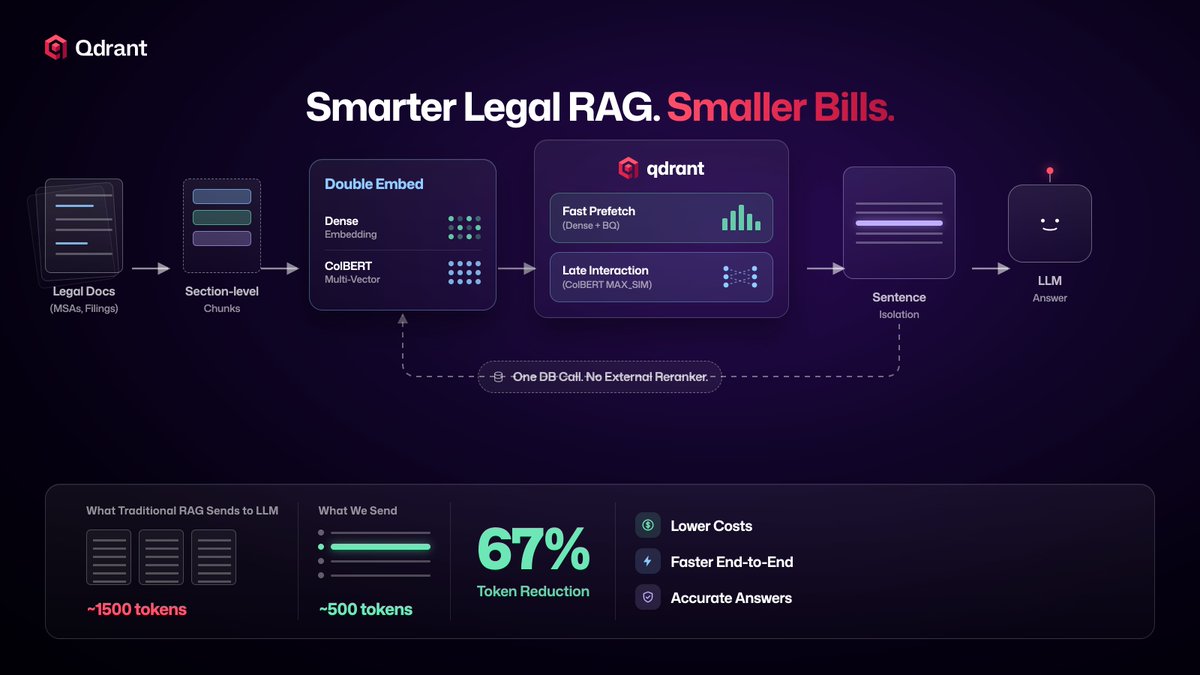
通过结合ColBERT重排序、二进制量化和句子级检索,Qdrant将RAG的token成本降低了67.1%。
入选理由:Qdrant的ColBERT重排序可减少67.1%的输入token
Milvus 3.0 StructArray 支持多向量搜索,保持元素与父实体关联,提升检索效率。
入选理由:StructArray 支持实体级、元素级和相同元素过滤三种检索模式
Sentence Transformers v6.0新增MultiVectorEncoder模型,支持ColBERT风格的晚期交互检索,提升视觉文档检索效果。
入选理由:MultiVector模型保留每个token的向量,避免信息压缩损失。
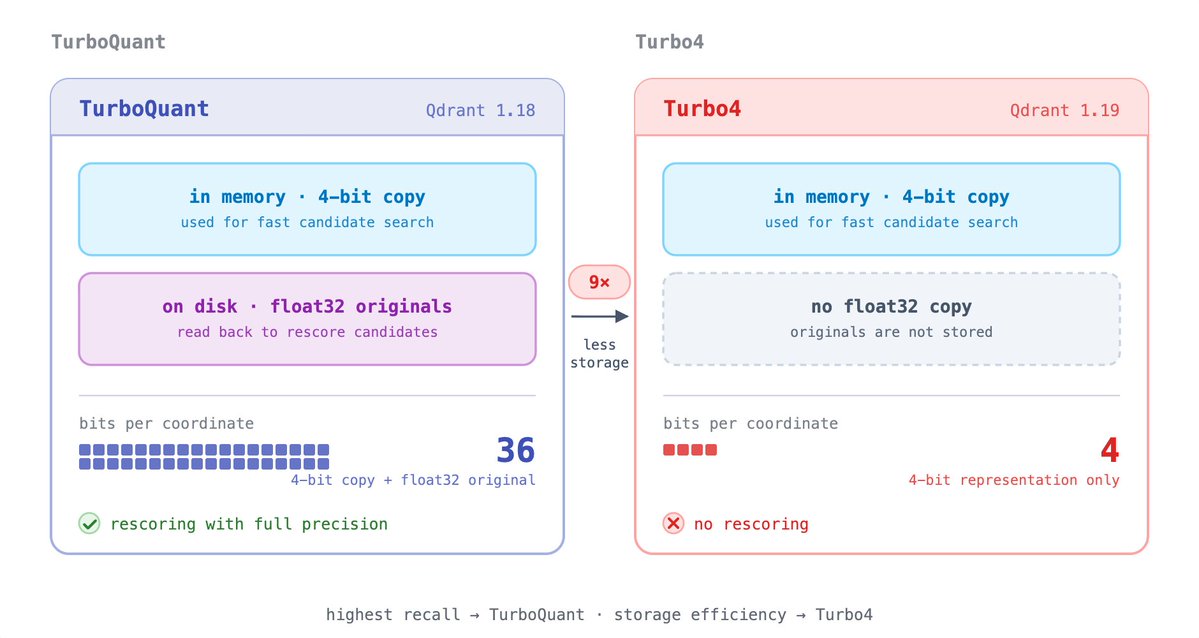
Qdrant 1.19 的 Turbo4 技术通过 4 位压缩存储减少 9 倍空间,但牺牲重评分能力。
入选理由:Turbo4 将存储空间从 36 位/坐标降至 4 位,实现 9× 压缩
Milvus 3.0通过in-engine排名、聚合和多向量搜索增强检索能力,减少生产环境中的自定义逻辑需求。
入选理由:Milvus 3.0支持ORDER BY对ANN候选结果进行排序,减少应用层逻辑
Perplexity的GPT-OSS-120B代理在agentic搜索中正确率64.0%,优于ColBERT模型4.9分且搜索次数更少。
入选理由:GPT-OSS-120B代理在BrowseComp+数据集上达到64.0%正确率
与「ColBERT」经常一起出现的 AI 术语。
💡 想追踪「ColBERT」的长期趋势?去 实体雷达 · ColBERT 查看详细分析和跨材料问答。